早些时候,我的两个AI Agent同时想用同一个浏览器,结果浏览器直接崩了。其实谁都没做错什么,它们都严格按指令行事,只是压根不知道对方也在用。
那一刻我才意识到,跑AI Agent真正难的地方不在AI本身。让模型写出像样的代码,这事基本已经解决了。难的是让四个Agent在同一批项目上连续干上几周,既不互相踩脚,也不重复劳动,更不会在事情没做完的时候乐呵呵地告诉我“搞定了”——我所有的时间都耗在这上面了。
我把整套配置叫作Crysto。最初只是为了管好自己的项目,后来越长越大,连职业工作也靠它撑着,两边完全隔开。下面说说它怎么运作,以及一路踩过的坑。
为什么做这个
我是AI工程师,这些工具本来就是每天打交道的。但我自己的项目散得到处都是:副业、研究、写作,还有那些必须盯紧的要事,全都半途而废地摊在不同的聊天窗口里。每个新对话都从零开始,而唯一清楚进度到哪儿的人,只有我自己。
团队里有谁

Crysto技术栈。可在vanshaj1999.github.io/crysto上点开查看
Claude Code负责总调度:规划工作、给其他Agent写任务简报、审核交回来的所有东西,并决定最终交付什么。我给它配了两个独立账号,一个工作用、一个个人用,靠一个小型shell hook根据当前所在文件夹自动切换。
Codex接长活。给它一份清晰的简报,它就能搭起一个小项目,或者啃完一大堆浏览器表单,我 meanwhile 去忙别的。
更小的模型通过一个叫OpenCode的工具处理边界明确的修复。同一个任务我可以同时丢给五个模型,然后留下结果最好的那个。
手机上的Claude通过Cloudflare Workers上的一个小型MCP服务器连接,后面挂着KV存储。这样手机和笔记本访问的是同一份存储数据,不用依赖共享聊天记录。
编码Agent还以无头模式运行。下面是我用的命令形式,每次运行都会指定模型和简报:
opencode run --format json -m <model> "<brief>"
codex exec -s workspace-write "<brief>"
每次运行都会拿到一份独立的仓库副本。OpenCode 每次调用只跑一个模型;Codex 在自己的 workspace-write 沙箱里干活。分开副本在对比结果时很关键:否则后跑的模型可能继承前一个模型改过的内容,我就没法干净地判断谁做了什么。
问题在于,它们之间不共享任何对话。下面说的所有东西都由此而来。
谁都记不住任何事
Codex 看不到我和 Claude 的聊天。明天的 Claude 会话看不到今天的。每个 Agent 醒来时都失忆。
解决办法土得有点不好意思:文件。每个项目放在一个文件夹里,里面有个 STATUS.md,写明当前进展到哪一步。每次会话先读它,结束前更新它。长期记忆则是一个事实一个文件,每个文件配一行摘要,每次只加载一小份索引。每个记忆文件都有 front matter,写明名称、描述和类型。类型共四种:user、feedback、project、reference。索引告诉 Agent 有哪些记忆存在;任务需要时,它再去读对应文件。
让我意外的是,给每条规则附上理由竟然这么管用。“同一时间只允许一个 Agent 使用浏览器”是规则。加上“因为两个 Agent 共用同一个调试端口会互相搞崩”,Agent 就能自己推断出我没写下来的情况,比如同一台机器上又开了第二个浏览器工具。
这事简单得几乎不值得写。但正是它,让任何 Agent、任何模型,都能冷启动接手一个项目。
谁在做什么
回到浏览器崩溃那件事。解决办法是多加一个文件 COORDINATION.md,放在 hub 里。Agent 在动文件或浏览器之前,先写下自己要接这个活:
# Website copy review, 4 November: CLAIMED BY CODEX
Owner: Codex. Claimed 4 Nov 10:05.
Done: 12 of 18 claims checked.
Evidence: drafts/about.md diff.
Next: check the last 6, then hand back to Claude.

一次真实运行:先创建项目,再在 make check 中跑那 17 个测试
规则一张索引卡就能写完。动手前先看文件。任务已经被人认领,就别碰,来问我。浏览器上只能有一个 Agent。而且这些规则没有任何强制手段。没有锁。它之所以行得通,是因为每个 Agent 的指令都要求它遵守这个文件,而到目前为止它们确实遵守了。
这周它派上了用场。一个工作会话已经占用了浏览器,我的个人会话就改用另一个浏览器工具,没有去抢。
测试通过了,却仍在说谎
整套安排依赖小模型负责构建、Claude 负责审查。这只有在审查真能发现问题时才成立,所以我做了测试。
这个 bug 是 pydynox 的 issue #560。它的 MemoryBackend 装饰器包装了一个异步函数,却在协程运行之前就退出了上下文。这个失败案例值得测试,因为返回协程和执行协程并不是同一件事。上下文必须覆盖真正的异步执行过程。
我把它交给 9 个模型,并附上我事先写好、对它们保密的测试。八个模型通过了这些隐藏测试,最快的一个 84 秒完成。Nemotron 3.5 Lightning 通过了,但还删掉了一个已有测试。如果我只看最终的测试结果,就完全不会发现这处改动。
重构任务在 awslabs/stickler 里,测试套件有 4,091 个测试。五个模型保持全绿,且没有改动任何测试。Flint 40B 还对 8 个无关的 notebook 跑了 ruff --fix。它的 diff 涉及 11 个文件,而其他模型只碰了 3 个。这些额外改动对任务来说并不必要,尽管测试套件仍然通过。

所以现在 Claude 对每处改动做三件事:事先写好构建 Agent 看不到的测试,事后运行这些测试,再通读整个 diff。测试全绿只能说明测试通过了,仅此而已。

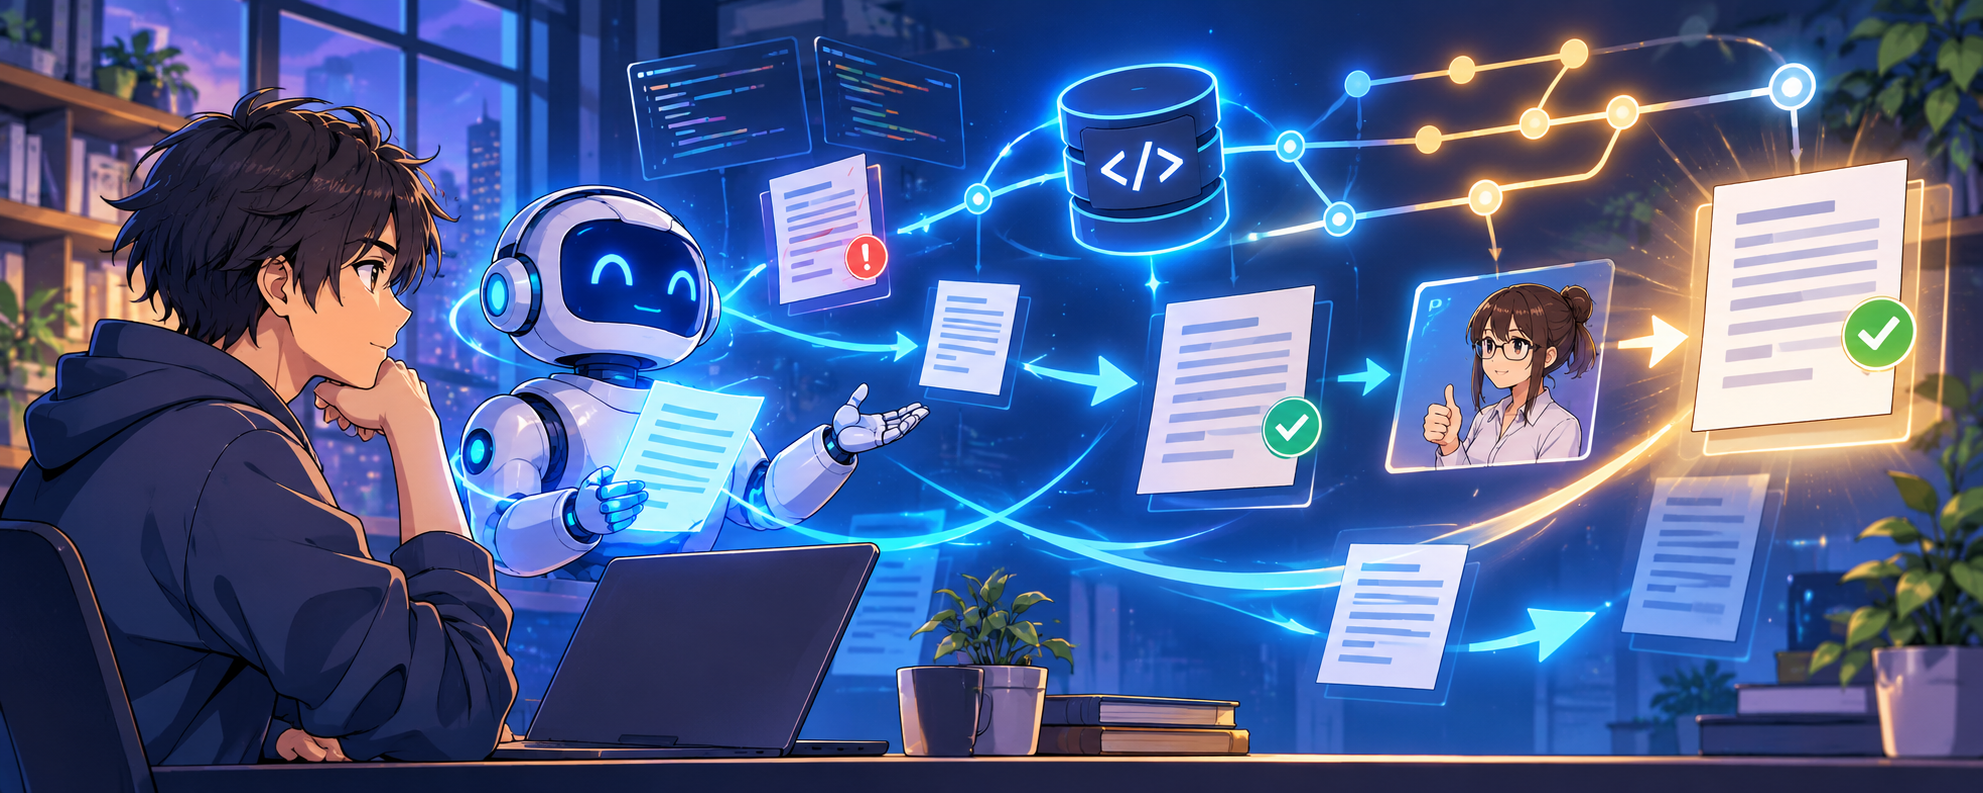
构建循环。交互版见 vanshaj1999.github.io/crysto
谁都会稍微夸大一点
Agent 完成任务后会写一份交接说明:改了什么、证据是什么、哪里出了问题、哪些还没测。规则是“完成”意味着某条命令跑过、输出就在文件里。计划和良好意愿不算数。
即便如此,说辞还是会悄悄注水。小模型搭建我的检索基准测试时,交接说明倒是坦承有一个功能——Claude 回答路径——从未真正运行过。可它们的 README 读起来仍像是结果的一部分。评审还发现,有个阈值恰恰是在用来评分的那批问题上调出来的。这两处现在都已修正,README 也写明了。
那个项目叫 rag-eval-lab,用 745 份 Python PEP 切成 17,933 个块,存进 PostgreSQL,配 pgvector 和 HNSW 索引。向量搜索的 recall@1 是 0.70,全文搜索是 0.36。采用倒数排名融合(RRF)的混合搜索得分 0.66。这里的 recall@1 问的是预期结果有没有排在第一位。多加一种检索方法,并不会自动提高这个分数。
这些数字描述的是这个基准测试。它们不能证明向量搜索在每个语料库上都胜出,也说明不了那条从未运行的回答路径。这个区分,正是我需要交接说明和 README 保住的。
Claude 也不能幸免。在起草上一篇稿子时,它写我的修复已经发给了项目维护者。其实还没有。我们之所以发现,是因为核查时回去看了实际的 pull request。
我已经不再指望有哪个模型从不夸大其词。我想要的是一个不轻信它说法的核查机制。
与 AI 无关的规则
我代价最大的两个教训,跟模型毫无关系。
我的工作账号和个人 Claude 账号用不同的配置文件夹隔开。但两者读的是同一个钥匙串条目,所以退出其中一个来切换,会把机器上所有会话都退掉。现在由 shell 钩子处理切换,每次切换都打印一行提示,我再也不手动退出了。
账户文件夹中,Claude 使用 CLAUDE_CONFIG_DIR,GitHub CLI 使用 GH_CONFIG_DIR。钩子会检查当前目录,选出匹配的配置。以下代码直接摘自 account-switch.zsh:
autoload -Uz add-zsh-hook
add-zsh-hook chpwd _crysto_claude_account
add-zsh-hook chpwd _crysto_gh_account
_crysto_claude_account
_crysto_gh_account
目录切换时,chpwd hook 会运行账户相关函数。最后几处调用还会在 shell 启动时选定账户。分开的配置文件夹解决了选择问题,但共享钥匙串的行为依然存在。
然后是语音助手。我最初为“Hey Crysto”设计的方案,是一个小型 Cloudflare Worker,用我的订阅登录来调用 Claude。Anthropic 的条款不允许这么做:订阅只适用于他们自家的应用,任何跑在自己服务器上的东西都需要付费 API key。于是我把问题拆开。最关键的部分——Crysto 与我的数据之间的连接——已经建好并在运行:一个部署在 Cloudflare Workers 上的个人 MCP 网关,带 OAuth 和 PKCE,默认只读,任何写入都需要我明确同意。Codex 登录进去,通过一个端点读取我的邮件、日历和项目数据。语音方面,目前我用 Claude 应用和 Siri。那个常驻的大脑——一个能自主运行、还能控制家里灯光的模型——已经设计好,只等上线。主要卡住我的是 API 账单:我还没准备好为一个副业项目按请求付费。下次我会先读条款,再画架构图。
内部实现
Crysto 主要由 Markdown 文件和 shell 命令组成。Claude Code 负责协调工作,而无头的 OpenCode 和 Codex 运行则产出改动供审查。项目状态和任务认领信息就放在工作内容旁边,下一次会话用普通文件工具就能读到。
公开仓库里有一个用于创建项目的 bash 脚本,外加 17 个测试、shellcheck 和 GitHub Actions CI。Cloudflare Workers 上的 MCP 服务器用 KV 存储状态。PostgreSQL、pgvector 和 HNSW 属于检索基准测试,而不属于协调协议。我不需要查数据库才知道谁在占用浏览器。
成本
除了我本来就有的订阅之外,没多花什么钱。钱其实不是真正的限制,注意力才是。所以整套东西的设计目标,就是把注意力花在写简报和做审查上,而不是敲代码。
如果你想试试
- 把共享状态放在文件里,而不是聊天记录里。
- 让 Agent 在开工前先认领任务,并且只给浏览器一个驱动。
- 自己写测试,并且让测试远离写代码的 Agent。
- 每一份 diff 都要读,哪怕全部通过。
- 要求提供证据,然后去核实。

GitHub 上的 crysto 仓库
设计、协作规则、模板,以及一个用来初始化新项目的脚本,全部开源在 github.com/vanshaj1999/crysto。我的记忆、笔记和数据则没有公开,这是有意为之。
想自己点开看看?交互式图表在 vanshaj1999.github.io/crysto。
封面照片由 James Harrison 拍摄,发布于 Unsplash。