每次把一项严肃的任务交给编码代理时,都会以相同的方式开始。克隆仓库。创建虚拟环境。安装依赖。运行测试套件以确认起点是绿色的。运行基准测试以记录你想要超越的数字。只有在这之后,有趣的工作才开始。在一个小型 Python 服务上,该设置让代理花费了 57 秒。在一个真实的单体仓库,包含数据库容器、构建步骤和温暖缓存时,需要 10 到 20 分钟,并且每次尝试都会重复这一过程。
当你只进行一次尝试时,这没问题。但当你想要比较不同方法时,这就会成为一种 税。“一次性重写” versus “进行性能分析并仅修复热点” versus “切换到 pandas” 是三种不同的赌注,而诚实地比较它们的方法是从同一起点运行这三种方案并进行测量。如果一个接一个地这样做,意味着要三次支付设置成本,并希望中间没有任何偏差。
DigitalOcean Harness 运行时 有专门为此构建的功能:检查点与分叉。您在已知良好的时刻保存代理的机器,然后将该保存点分叉为独立的副本。每个副本都已安装依赖、测试通过且基线已记录,因为每个副本 就是 当时的机器。您为每个分叉提供不同的指令,它们同时工作,然后您进行比较。如果原始会话上的实验出错,您可以将其回滚到该检查点。
在这篇文章中,我故意在一个报告服务上设置得很慢,正是这样做的。我使用 Claude Code 代理一次性设置了沙箱,进行检查点,将其三向分叉,为每个分叉提供不同的优化策略,并将三个结果与一个相同的基线进行比较。然后我故意破坏父会话并将其回滚。下面的每条命令、时间和数字均来自 2026 年 9 月 19 日的现场会话,使用了 doctl 1.168.0-beta。Harness Fork 实验室 仓库是公开的,因此您可以运行相同的实验。
DigitalOcean 托管代理 现已对所有用户开放 公开预览,并提供 Harness 运行时 和 操作网关 的官方文档。本演练在 2026 年 9 月 19 日的预览环境中运行,预览行为可能会发生变化;检查点、分叉和回滚操作指南 是当前命令和限制的参考。如果您是新手?请先从 Harness 运行时快速入门 和 示例演练 开始。
TL;DR
- 检查点是 Harness 运行时会话的保存点。DigitalOcean 捕获整个沙盒机器,因此分叉或回滚将从该确切状态开始,而不是重放步骤。在全新设置的 2 vCPU、4 GB 沙盒(默认大小)上创建一个检查点耗时 27 秒,并报告大小为 84.0 GB(为完整的沙盒镜像大小,而非我的文件大小)。
- 分叉 从检查点创建独立的子会话,每个子会话拥有自己的会话 ID,而父会话保持不变并继续运行。
doctl harness-runtime fork anish-fork-lab --from-checkpoint cp_97dafbedc792 --count 3返回了 三个ready会话,耗时 10.6 秒。每个会话已经克隆了仓库、构建了虚拟环境,并且 15 项测试通过,无需自行进行设置。 - 基于同一基准的三种不同策略(基准 4,250 至 4,340 毫秒,校验和
5c1322b035d743e3),分叉在并行运行时分别用时 49 秒、92 秒 和 187 秒 完成,且三者均保持校验和以及 15 项测试通过:- Fork A,单次遍历重写:40.7 毫秒,在一个文件中添加 91 行、删除 55 行。
- Fork B,先进行性能分析,仅修复最热点的函数:876.6 毫秒,添加 4 行、删除 8 行。
- Fork C,pandas DataFrame:64.9 ms,在两个文件中新增 84 行,删除 11 行,并新增一个依赖。
- 回滚 在同一台机器、同一会话 ID 下将父级恢复,耗时 5.8 秒。一个故意设计的糟糕实验(额外安装了一个包,且两个测试因校验和改变而失败)已被移除:该包未被安装,15 个测试通过,且校验和恢复为
5c1322b035d743e3。 - 唯一不会恢复的是代理的对话。每次 fork 都会开始一个全新的 transcript,回滚后代理告诉我“这次是我们会话的开始”。工作区记住了一切;聊天记录没有。解决办法是养成习惯:让设置将其发现写入一个文件(这里是
BRIEF.md),以便每次 fork 从磁盘读取相同的上下文。 - Fork 会占用您团队的 并发会话限制,每个 fork 命令可以创建 1 到 4 个,该功能在 Codex CLI、OpenCode 和 Claude Code 适配器上受支持。检查点按存储计费,费用为 0.05 美元/ GiB‑月,因此请删除不再需要的检查点。
Harness Runtime 是什么,以及检查点捕获了什么
DigitalOcean 托管代理 是两个托管组件。
-
Harness 运行时 在专用的 Firecracker microVM 沙箱环境中运行您的代理。
-
Action 网关 让您的代理能够在其他产品中操作(我的 凭证代理教程 讲解了这一部分)。本文介绍第一个 DigitalOcean Harness 运行时。要了解两者之间的区别,请参阅 Harness 运行时和 Action 网关如何协同工作,见产品文档。
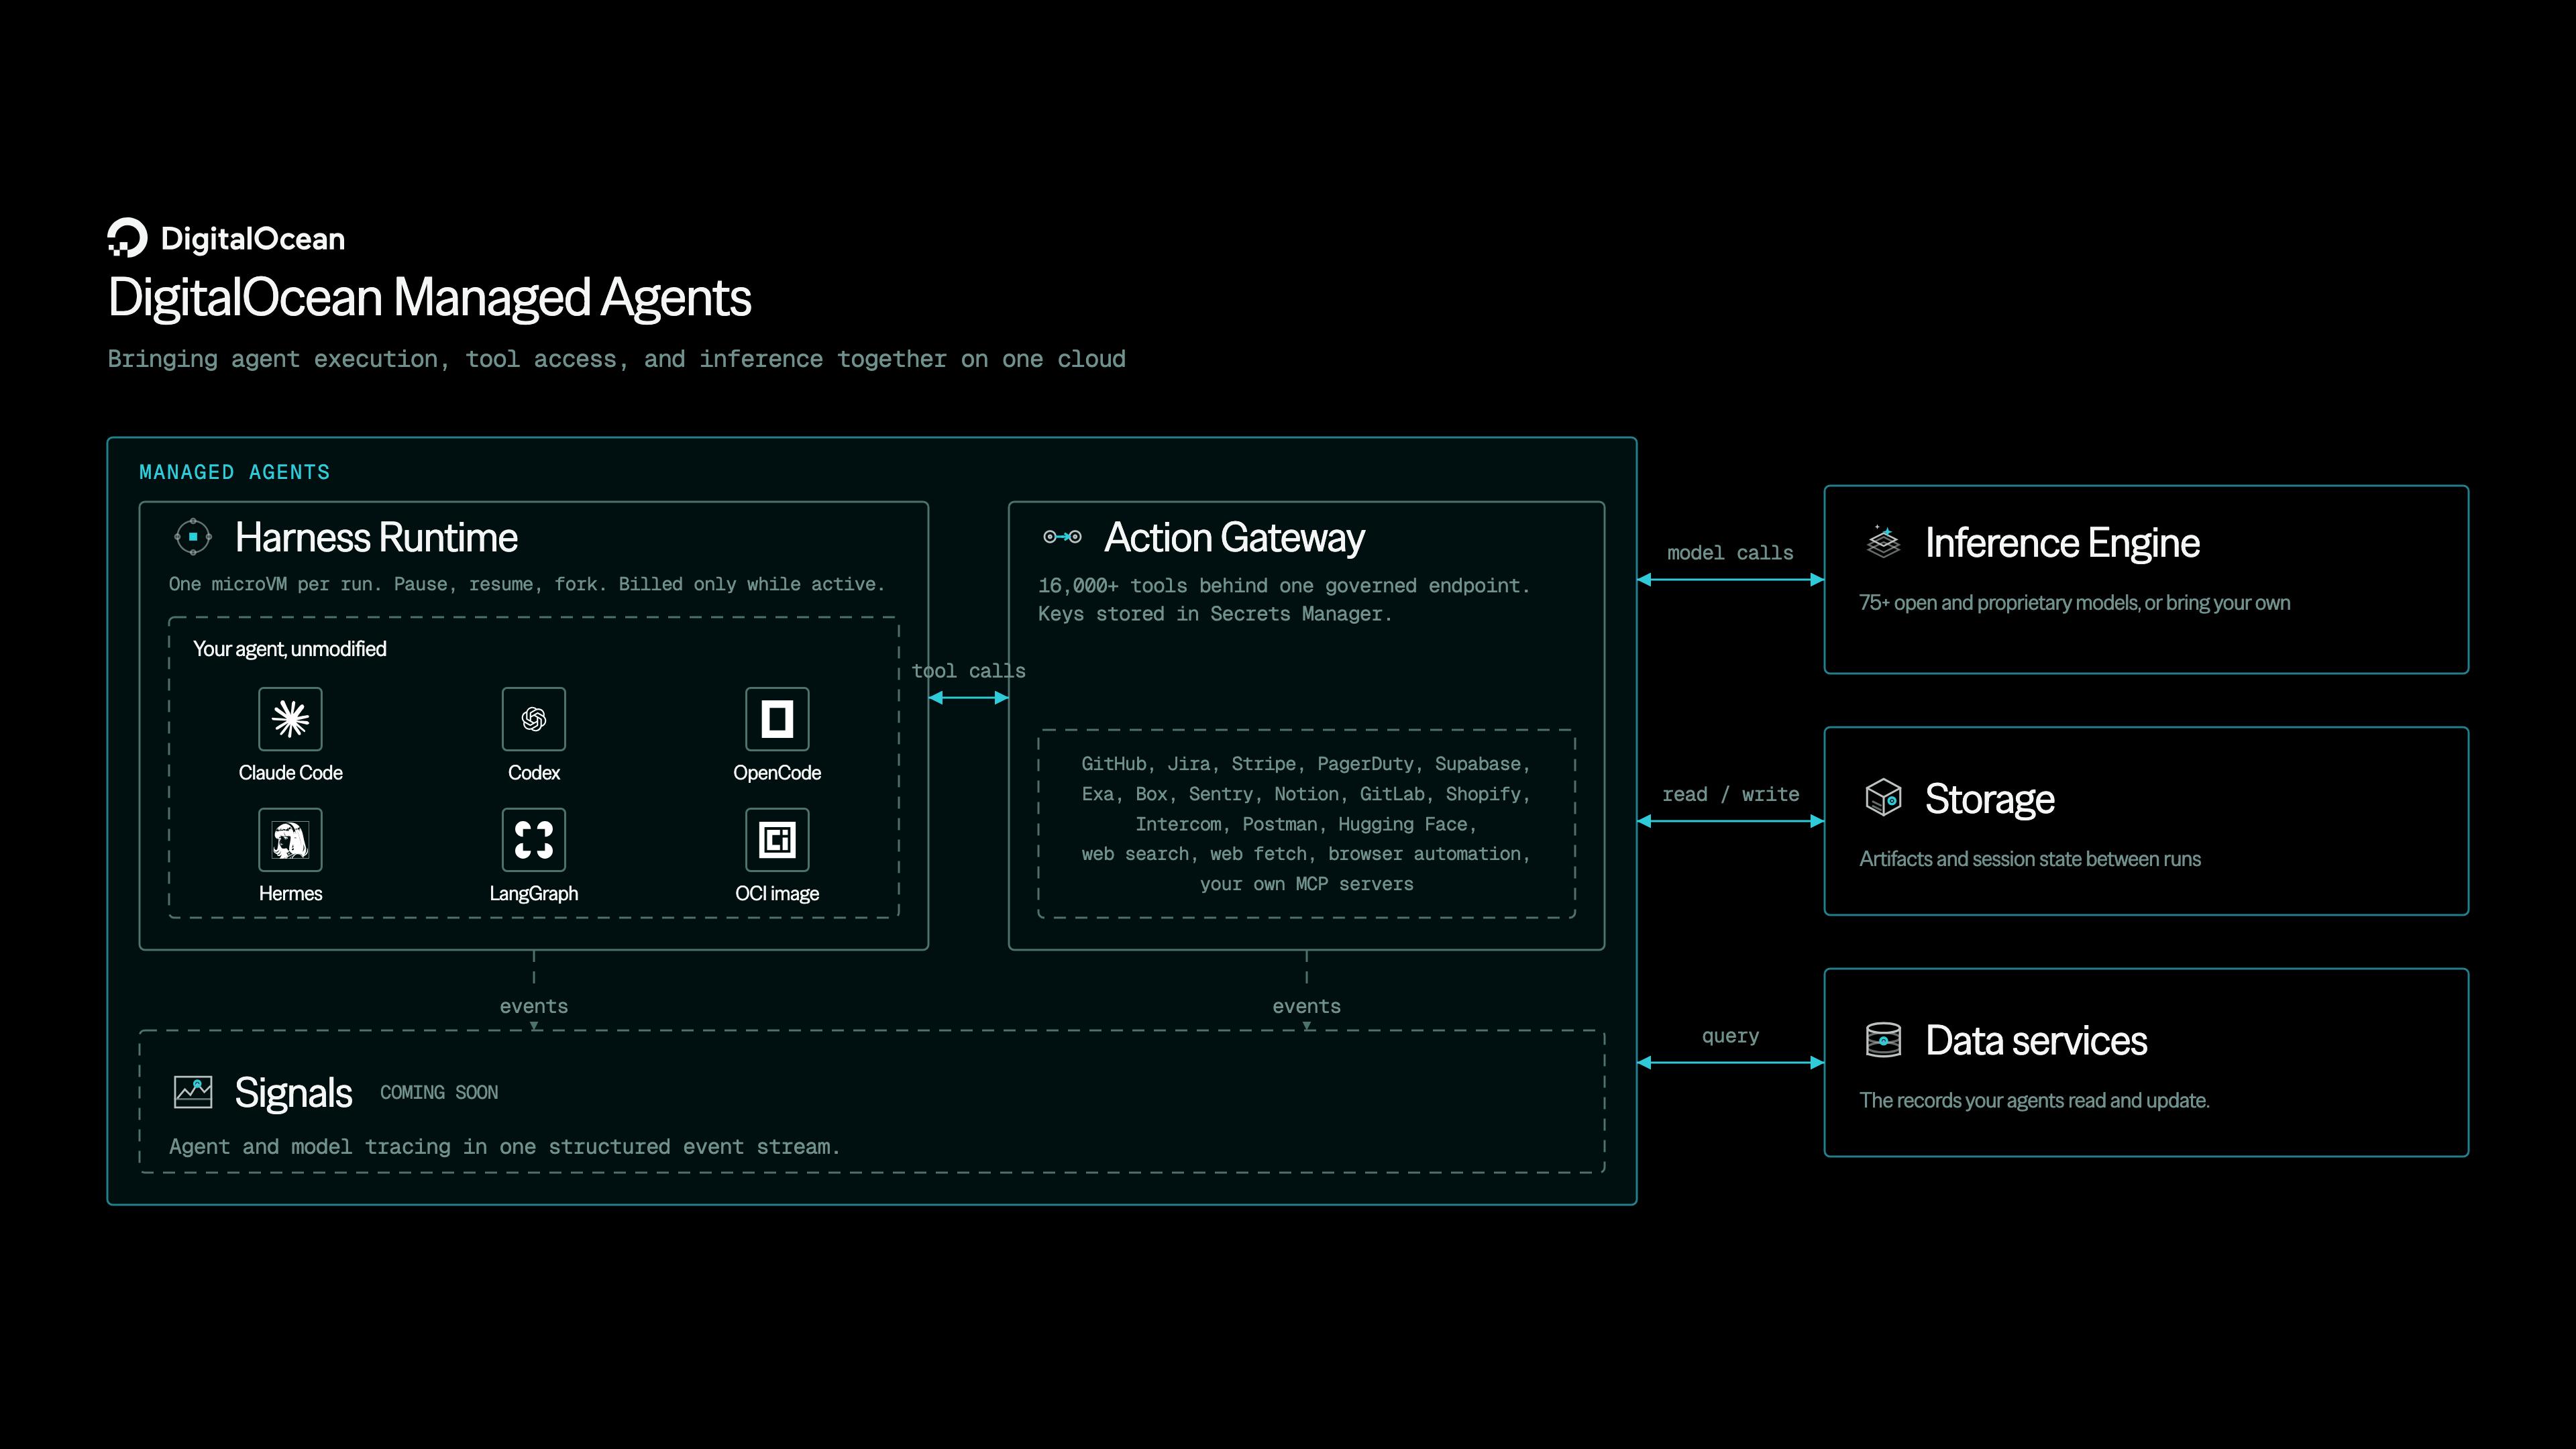
Harness Runtime 是您的代理运行所在的计算机。 当您启动会话时,DigitalOcean 会为您的编码代理(Claude Code、Codex CLI 或 OpenCode)提供一个小型且隔离的机器,即一个专用的 Firecracker microVM 沙盒。您在一个文件 agents.yaml(即 environment spec)中描述该机器:哪个代理、哪个模型、CPU 和内存大小(mars-2vcpu-4gb 为默认值)、哪些环境变量和 secrets,以及一个 permission policy,该策略说明哪些操作可以自行运行、哪些需要先征求人工确认、哪些被禁止。您可以通过 DigitalOcean 控制台的聊天窗口或使用 doctl 在终端中与会话进行交互。即使您关闭笔记本电脑,机器仍会继续运行,并且您可以在保持文件完整的情况下 暂停和恢复 它。
一个 checkpoint 是该机器的保存点。 DigitalOcean 会一起捕获整个沙盒、工作区文件以及运行状态,因此回滚或分叉可以精确地从会话所在位置继续,而不是重放一个近似值。简单来说,检查点既不是要重放的步骤列表,也不是 Git 提交。它是被冻结的沙盒。
从检查点,您可以执行两种操作:
| 操作 | 它的作用 | 保持不变 | 变化 |
|---|---|---|---|
| 分叉 | 从检查点生成会话的独立副本 | 父会话继续运行,保持不变 | 每个子会话获得自己的会话 ID 和全新的转录本 |
| 回滚 | 在同一台机器上恢复检查点,将会话就地倒回 | 会话 ID 和您持有的任何句柄 | 工作区恢复到检查点状态 |
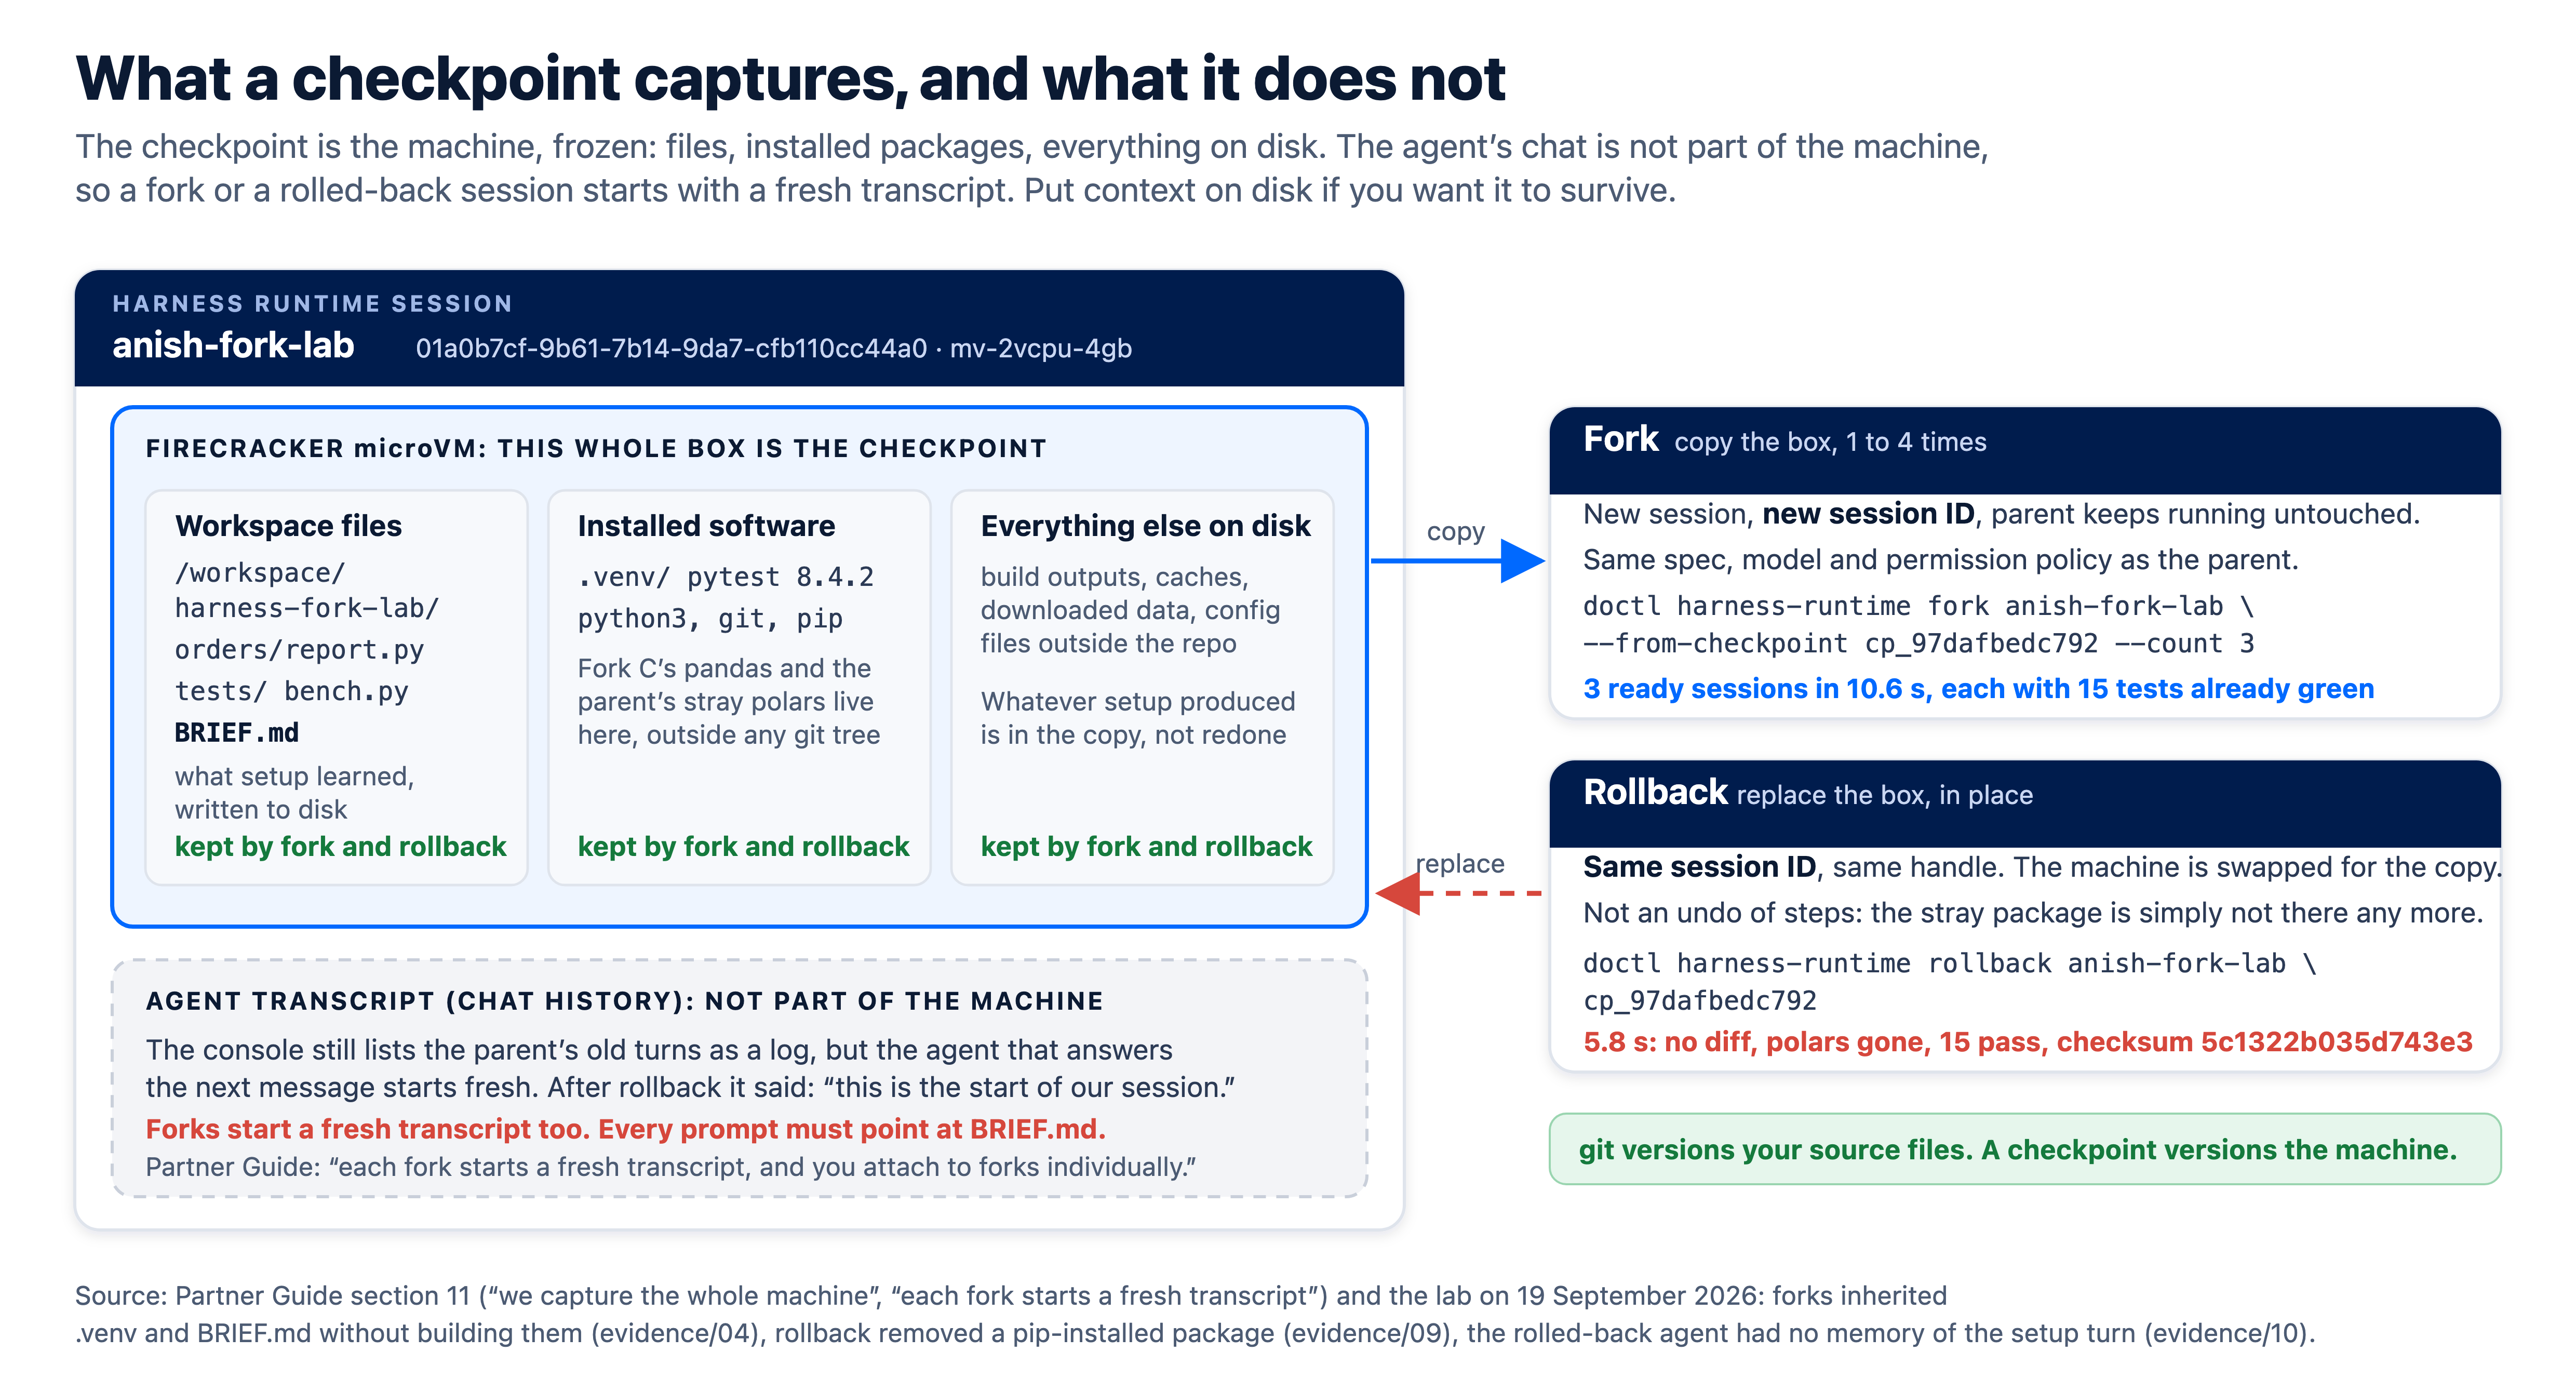
此图展示了:
BRIEF.md)、代理安装的软件(.venv、pytest,某个 fork 中后来出现 pandas,而父会话中则有 stray polars),以及磁盘上残留的其他所有设置。命令位于 doctl harness-runtime(别名 doctl agent),详见 如何检查点、Fork 与回滚会话:
| 命令 | 作用 |
|---|---|
doctl harness-runtime checkpoint create |
为会话创建保存点 |
doctl harness-runtime checkpoint list |
列出会话的检查点 |
doctl harness-runtime fork |
从检查点创建子会话(省略 --from-checkpoint 则先创建检查点再 fork) |
doctl harness-runtime list --parent-session-id |
列出从会话 fork 出来的子会话 |
doctl harness-runtime rollback |
将同一会话回滚到检查点 |
控制台提供相同的控制功能。每个会话页面的菜单中都有 检查点 条目,打开后会弹出一个抽屉,其中包含 立即保存检查点 按钮;每个已保存的检查点都有 恢复 和 Fork 会话 按钮。
一图中的模式
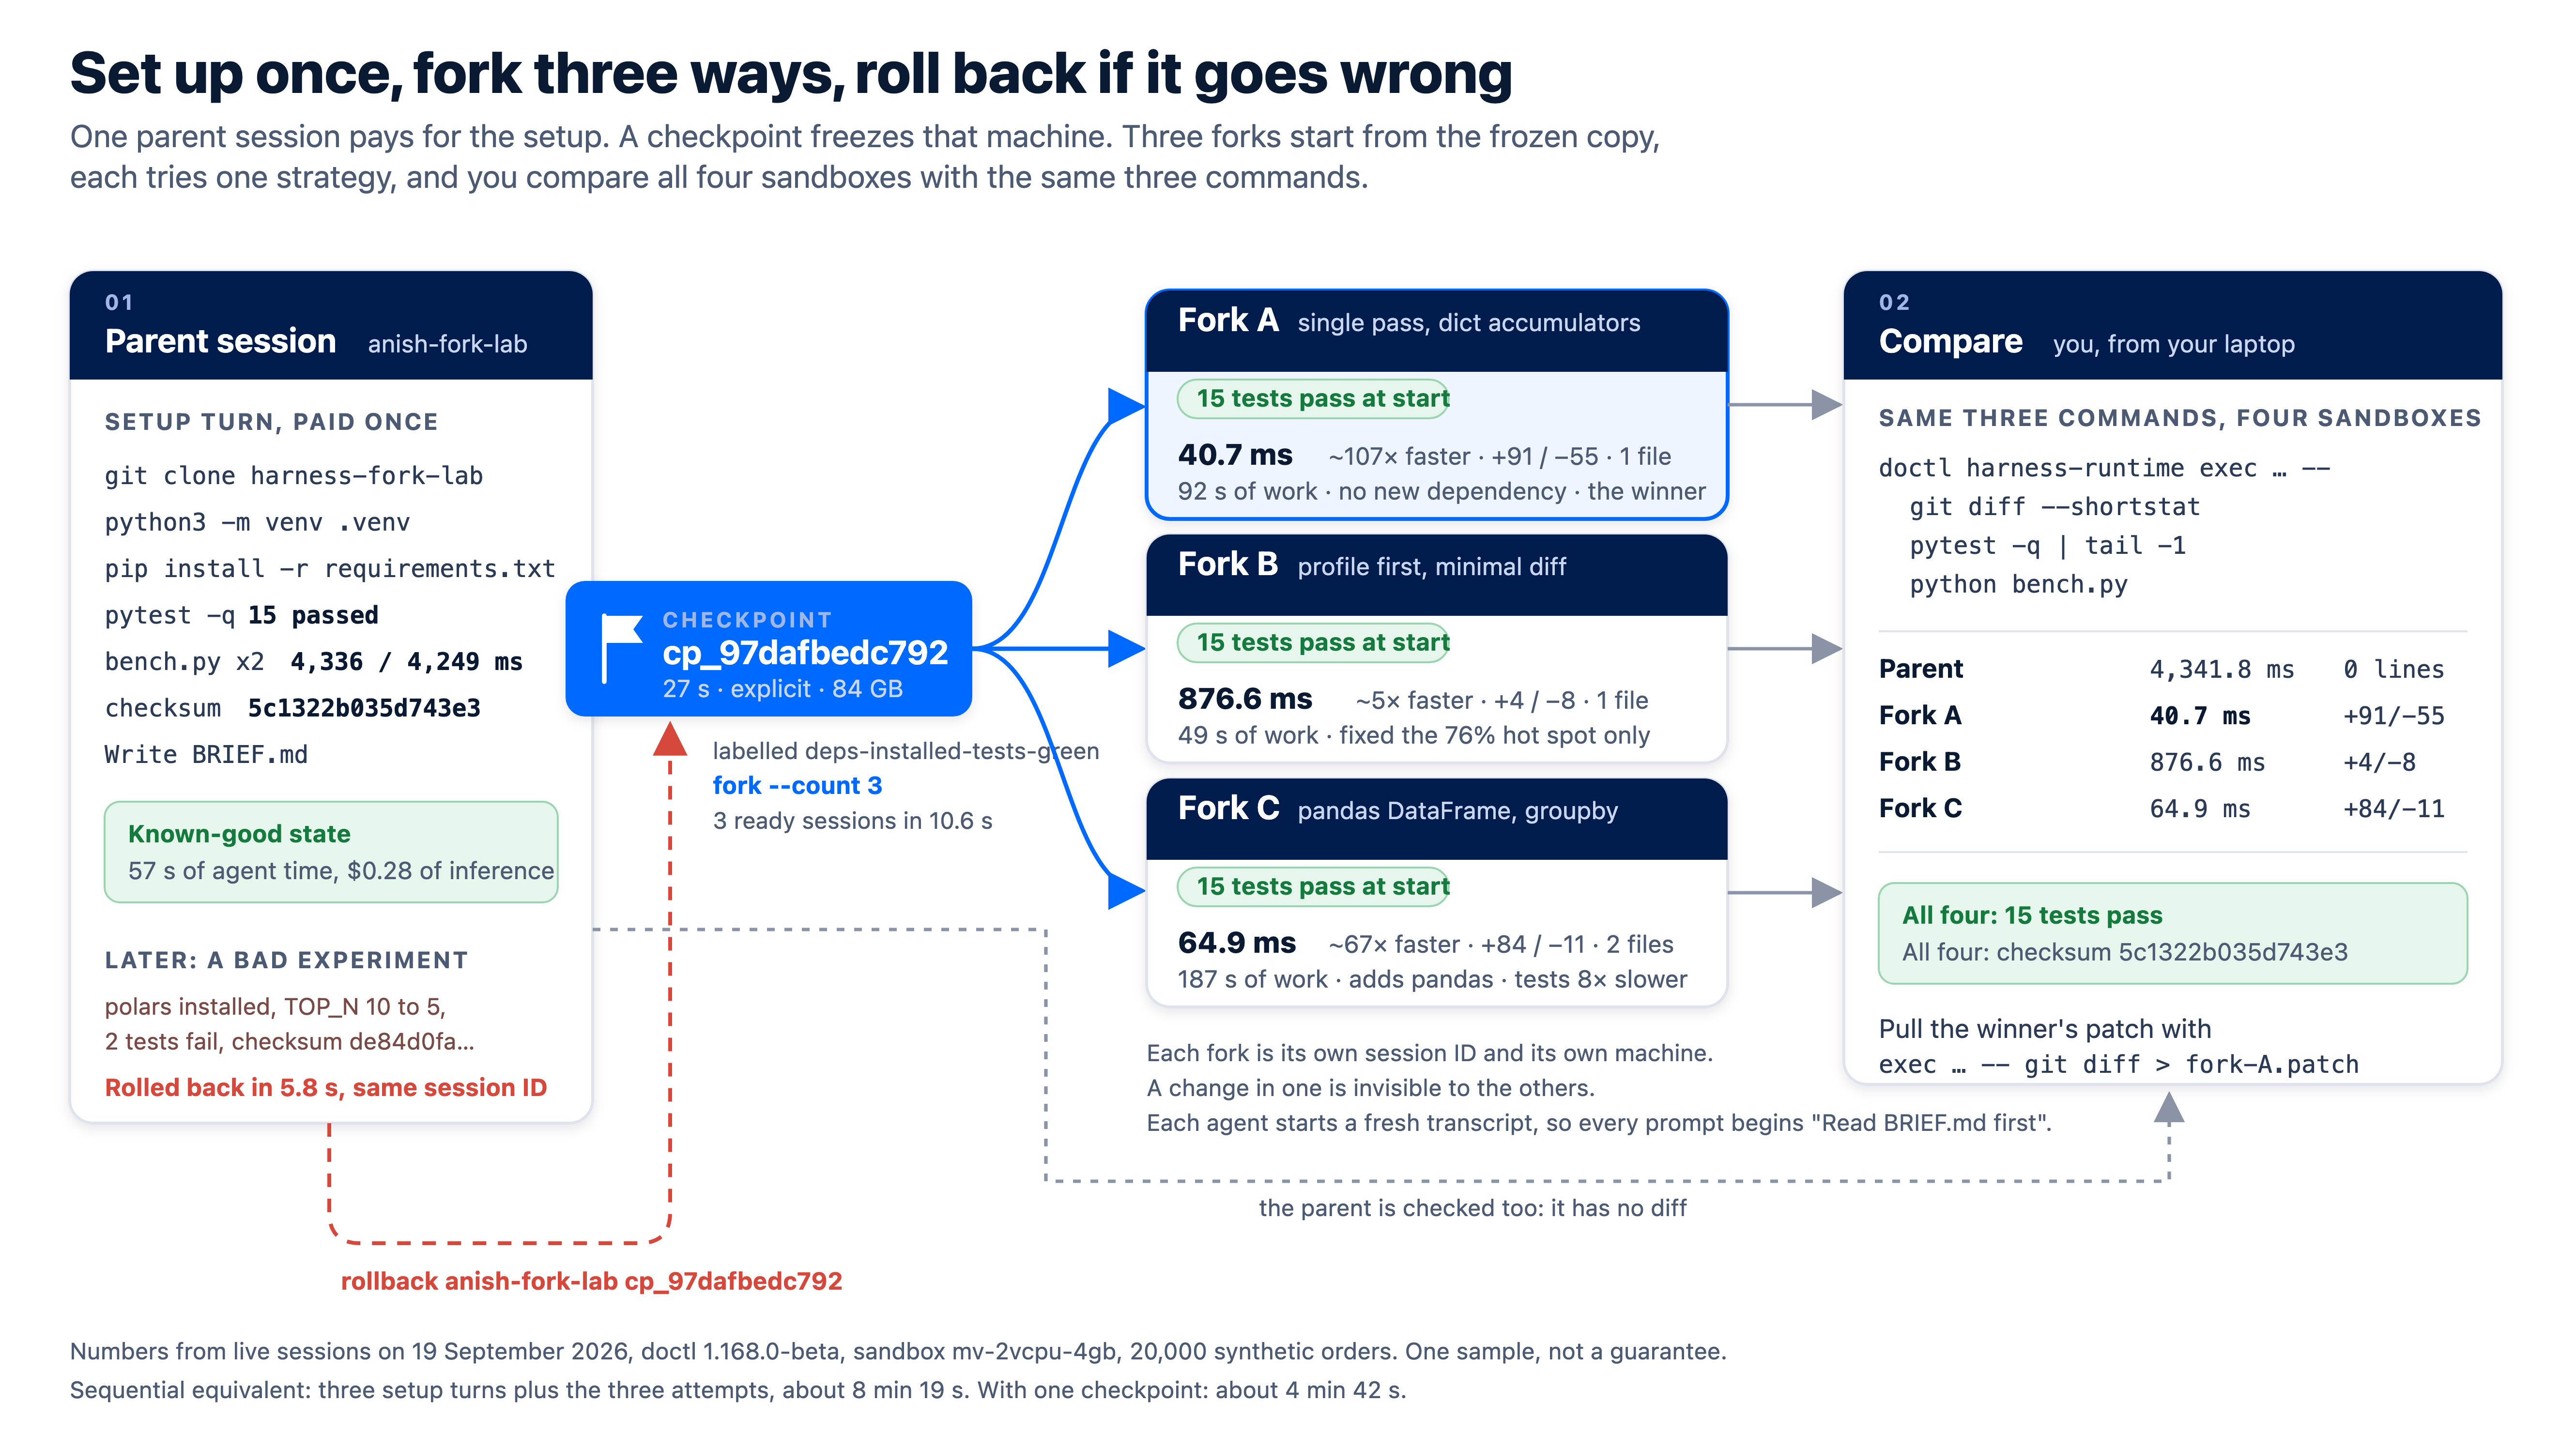
此图展示:
- 一图展示完整实验室:一次性设置,检查点,以三种方式 fork,进行比较,若父会话出错则回滚。
.venv、依赖、测试、基准、写入 BRIEF.md):57 秒和 0.28 美元。检查点 deps-installed-tests-green 在 27 秒内保存该状态。git diff --shortstat、pytest -q、bench.py),并并排读取这些数字。BRIEF.md”开始。来源:本文中的实验室,在 2026 年 9 月 19 日针对会话 anish-fork-lab 及其三个 fork 运行。方框中的每个数字均来自 doctl harness-runtime exec 的输出,在第 7 步中复现。
这对 AI 原生工程团队为何重要
采用编码代理最快的团队不会问“代理能否完成此任务”。他们是在问“我们应该交付这三种做任务的方式中的哪一种”,他们希望这个答案来自证据,而不是一次恰好顺利运行的结果。检查点和 fork 方法改变了获取该证据的经济学。
设置只发生一次,而不是每次尝试都发生。 在此实验室中,设置轮次的成本是 57 秒的代理时间和 0.28 美元的推理。传统方式下的三次尝试需要支付三次该成本。使用 fork 时,只需支付一次成本,三次尝试从字节相同的机器开始。在实际服务中,如果设置意味着容器、种子和温暖的缓存,则节省的工程师小时数,而不是秒数。
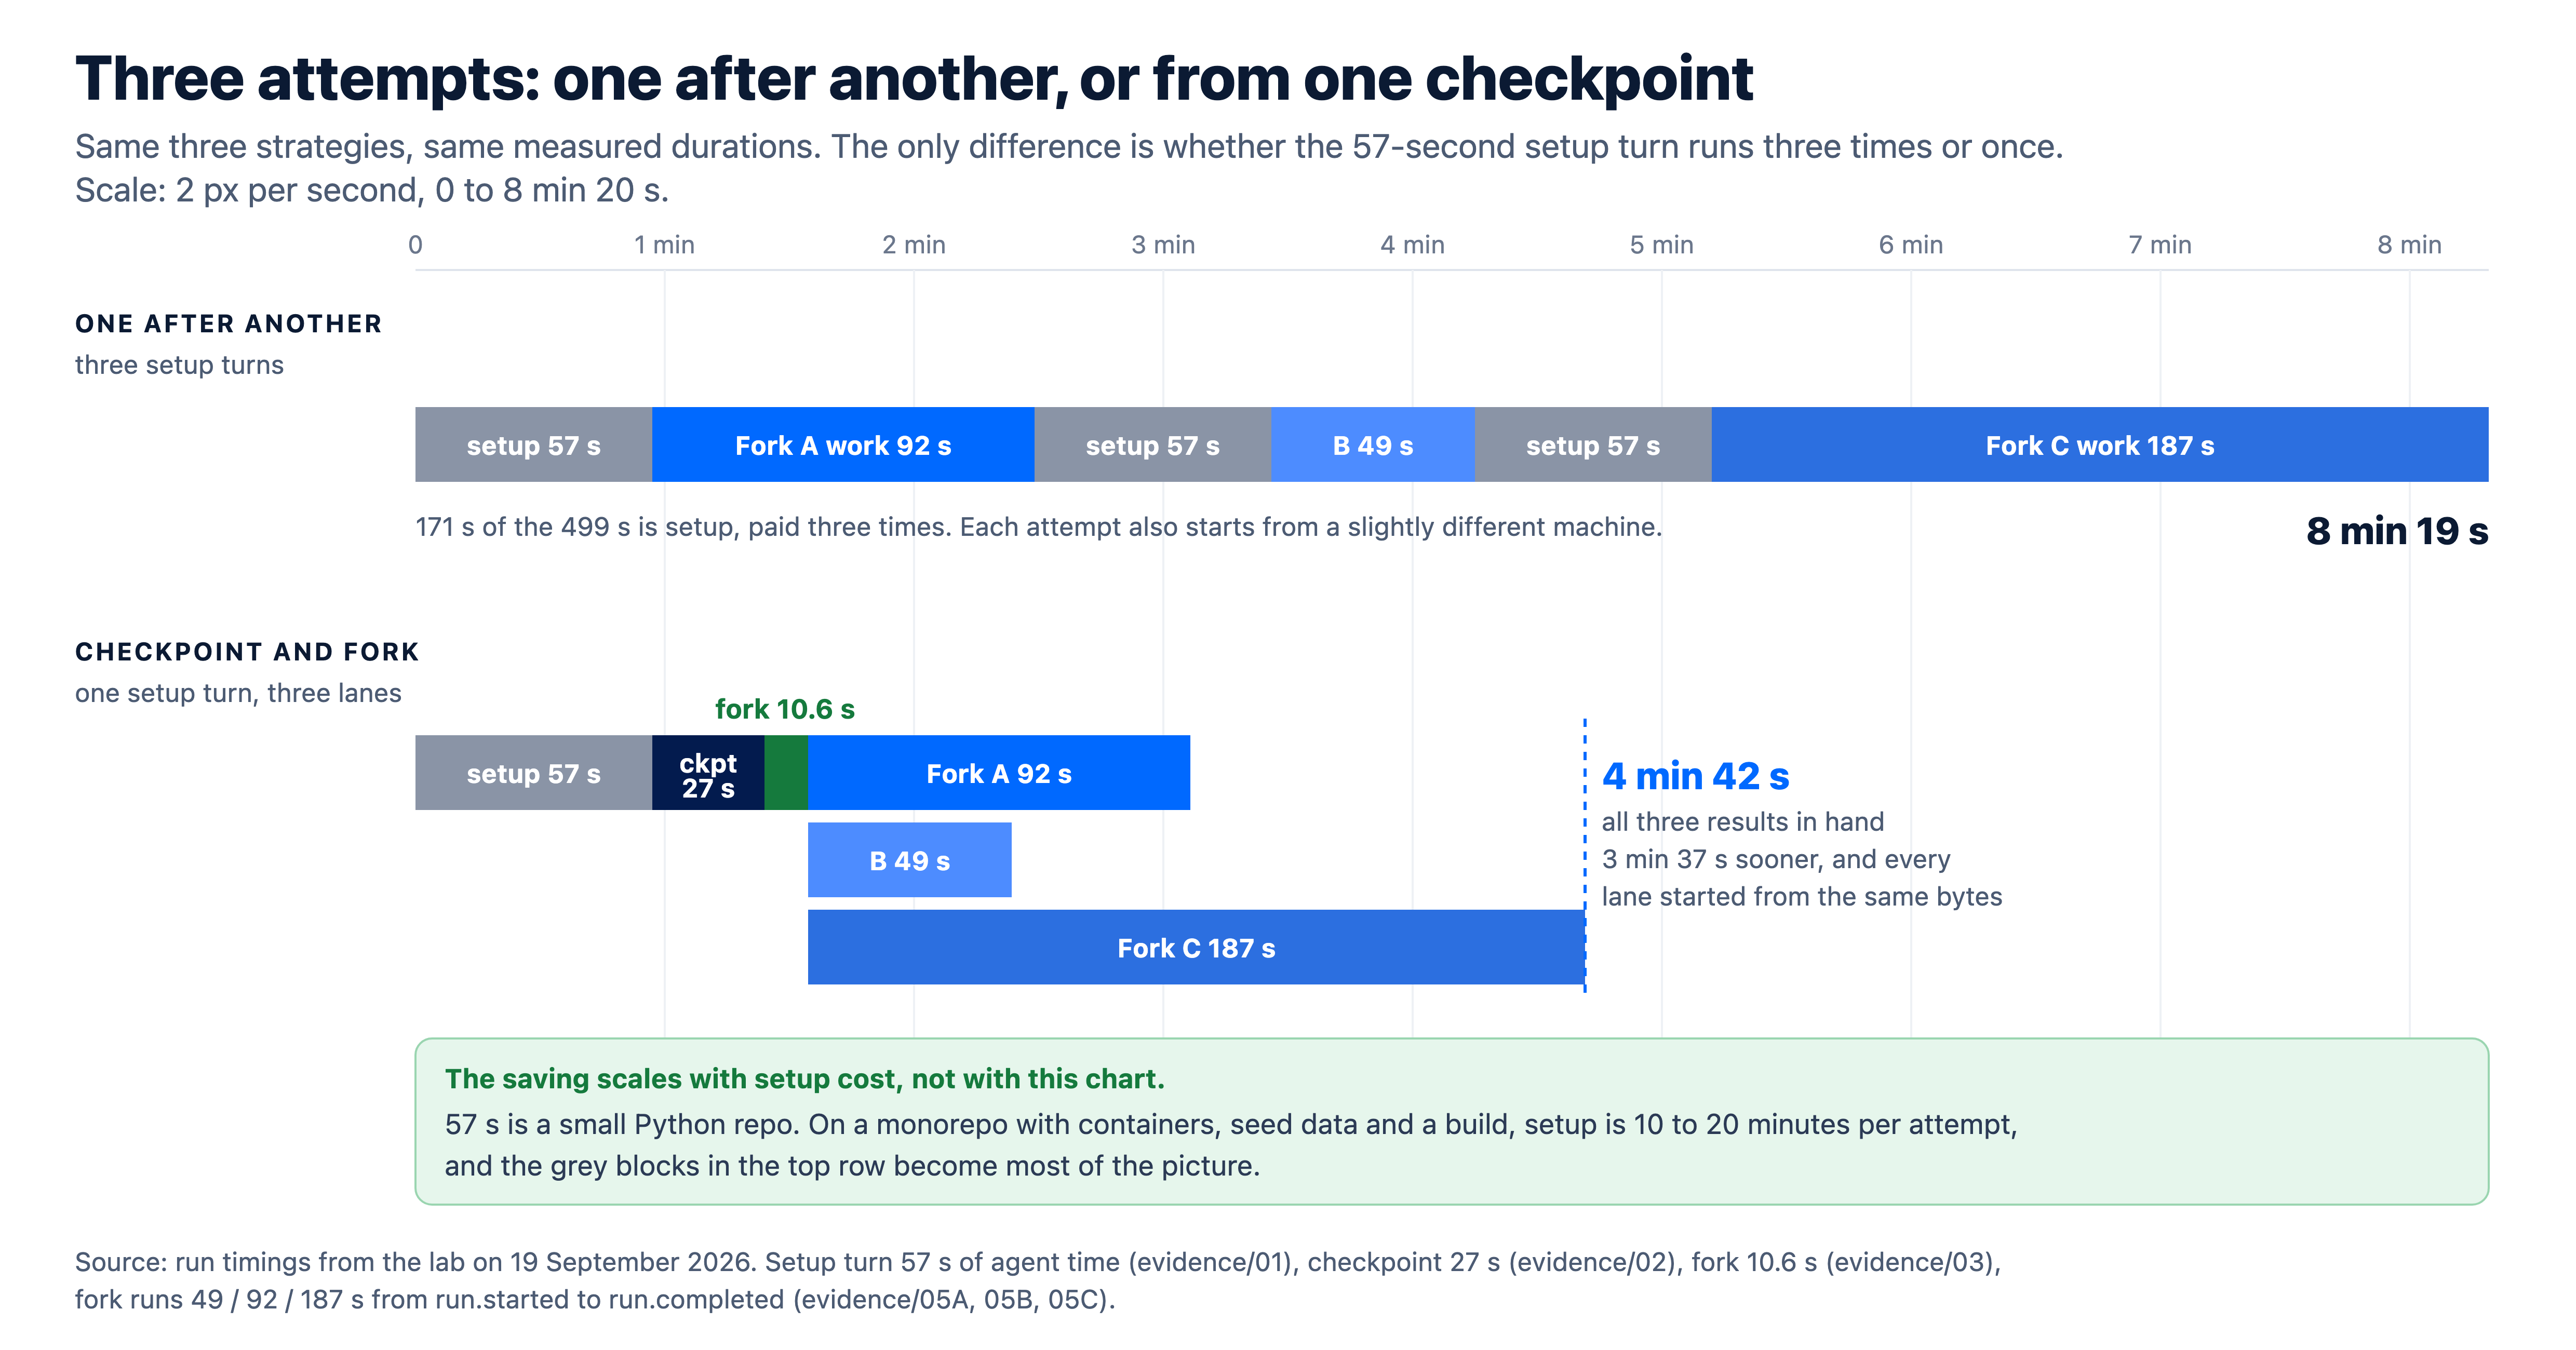
此图表比较的内容:
- 相同的三次尝试,有两种方式:依次进行,或从一个检查点并行启动。
- 依次进行:每次尝试都需要支付自己的 57 秒设置时间,然后执行工作(A、B、C 分别为 92、49、187 秒)。所有三个结果在 8 分 19 秒时全部得到,而在这 499 秒中,有 171 秒是重复三次的相同设置时间。
来源:通过 doctl harness-runtime checkpoint(27 秒)和 doctl harness-runtime fork(10.6 秒)打印的计时数据,以及每个会话事件流中的 run.started 到 run.completed 时间戳,全部为 2026 年 9 月 19 日。设置和 fork 的记录在步骤 3 和 6 中复现。
比较是公平的。 本文中的三个 fork 起始自同一个克隆、同一个 .venv、同一个 BRIEF.md,基准数也相同。当 Fork A 报告 40.7 ms,Fork B 报告 876.6 ms 时,差异来源于策略,而非运行间环境漂移。
冒险工作有安全网。 在进行危险的重构前创建检查点,并行尝试三种方案,保留胜出的那个。同样的保存点也适用于不那么光鲜的情况:代理安装了不该装的东西,编辑了被告知不要触碰的文件,或让测试变红。回滚能让机器在几秒钟内恢复,无需重新创建会话或丢失其 ID。
你可以从同一状态尝试不同的代理和模型。 本文中的所有 fork 都使用不同的提示运行 Claude Code。同样的模式让你只需 fork 一次,然后让每个子进程指向不同的模型,或比较不同的提示风格,起点相同。
此模式不适用的情况同样重要,我将在 何时使用它 章节中再次讨论。
动手:一次性设置,三种方式 fork,比较,回滚
本演练按顺序完成五件事。
- 在 Harness Runtime 中启动一个 Claude Code 会话,让它完成设置:克隆、安装、测试、基准测试、编写简报。
- 保存一个标记为
deps-installed-tests-green的检查点。 - 将检查点 fork 成三个会话,并验证每个会话都继承了设置。
- 为每个 fork 提供不同的优化策略,让它们并行运行,并将三个结果与父会话进行比较。
- 故意把父机弄坏,然后回滚,确认机器已恢复到检查点时的状态。
你需要准备什么
- 一个已绑定付款方式的 DigitalOcean 账户,且 Harness Runtime 的预付费余额大于零。如果还没有账户,请到 cloud.digitalocean.com 注册。
- DigitalOcean Managed Agents,目前处于公开预览阶段。如果你从未启动过会话,按照Harness Runtime 快速入门操作,一条命令就能让 agent 跑起来。
- 一个终端。Mac 上打开「终端」应用,Windows 上使用 PowerShell 或 WSL。
- 一个具备完全访问权限的 DigitalOcean 个人访问令牌,在控制面板的 API 部分创建。参见API 快速入门。将其导出为
DIGITALOCEAN_ACCESS_TOKEN。 doctl1.170.0 或更高版本。该版本(2026 年 9 月 22 日发布)是第一个内置harness-runtime(别名agent)命令的标准构建,包括fork和rollback;在此之前,这些命令只随 beta 构建发布,而我做本实验时用的是 1.168.0-beta。你可以从doctl 安装指南或 doctl 发布页安装,用你的令牌运行doctl auth init,再执行doctl harness-runtime checkpoint --help确认可用。- 笔记本电脑上装有 Python 3,仅用于一个从终端向会话发送提示词的小辅助脚本。
你不需要 Anthropic 或 OpenAI 的密钥。下文的配置使用 DigitalOcean 托管的推理服务,因此调用模型的费用同样由这个 DigitalOcean 令牌支付。
如果你之前没有创建过 Harness Runtime 会话,那么 Harness Runtime 快速入门 是最短的路径;我之前的教程 使用 Action Gateway 将 AI 代理连接到 SaaS 工具 会一步步演示如何基于规范进行第一次会话。
我们交给代理的问题
示例仓库是 anishsingh20/harness-fork-lab。这是一个小型 Python 包,orders,包含一个财务团队可能运行的夜间报告。build_report() 正确但缓慢:每次聚合(按地区的收入、按月的收入、顶级客户、最畅销的 SKU、重复客户占比)都会重新扫描完整的订单列表,每个唯一键扫描一次。在 20,000 条合成订单上大约需要 4.3 秒。
有两个因素固定了输出,使得代理不能通过更改答案来进行“优化”:
tests/test_report.py包含 15 个测试,其中包括一个 500 条订单报告的黄金文件。bench.py会打印运行时间以及完整报告的 16 位校验和。报告中任何数值的变化都会导致校验和改变。
def repeat_customer_share(orders: list[Order]) -> float:
    """Share of paid orders that came from a customer with more than one paid order."""
    paid = _paid(orders)
    if not paid:
        return 0.0
    repeat = 0
    for o in paid:
        count = 0
        for other in paid:          # O(n^2): every paid order rescans every paid order
            if other.customer_id == o.customer_id:
                count += 1
        if count > 1:
            repeat += 1
    return round(repeat / len(paid), 4)
该函数单独占据了运行时间的 76%,这一点会被其中一个分支发现。其他函数的形状同样是 O(n × k)。每个分支的任务相同:让 build_report 快速运行,保持全部 15 项测试通过(绿色),校验和保持不变。只有实现方式不同。
步骤 1: 编写规范
为实验创建一个文件夹,并将此保存为 specs/agents.yaml。代理是 Claude Code,模型由 DigitalOcean 的推理端点提供服务,唯一的密钥是你的 DigitalOcean 令牌。
name: anish-fork-lab
agent: claude-code
size: mars-2vcpu-4gb
persistent_workspace: true
env:
  ANTHROPIC_BASE_URL: "https://inference.do-ai.run"
  ANTHROPIC_MODEL: anthropic-claude-4.6-sonnet
  CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS: "1"
secrets:
  ANTHROPIC_API_KEY: "${DIGITALOCEAN_ACCESS_TOKEN}"
permissions:
  default: allow
  rules:
    - tool: bash
      match: { command: "rm -rf *" }
      action: deny
    - tool: bash
      match: { command: "git push *" }
      action: deny
以下三行内容值得注意。
permissions.default: allow让代理能够在不询问的情况下运行 shell 命令。这是你在无人值守实验中所期望的。对于第一次会话,ask是更安全的默认值,而在你了解代理倾向做什么之前使用它。两条deny规则阻止了我永远不希望实验运行的两条命令。权限指南 介绍了规则语法以及在启动会话之前如何验证策略。ANTHROPIC_API_KEY应该放在secrets下,而不是env。env中的值会原样存储并在沙箱内可读;secrets通过 DigitalOcean Secrets Manager 传递,且永不会出现在会话元数据中。size: mars-2vcpu-4gb是默认配置(2 vCPU,4 GB),足以满足此仓库的需求。如果是真正的单体仓库,请选择更大的沙箱;沙箱规格 从mars-1vcpu-1gb到mars-16vcpu-32gb,且doctl harness-runtime sizes list会列出当前的 slug。我在 9 月 19 日进行此实验时,相同配置曾被称为mv-2vcpu-4gb;随后 slug 改为mars-*以供公开预览,因此请参考sizes list的输出。
步骤 2:启动父会话
doctl harness-runtime start --spec specs/agents.yaml
在 1.168.0-beta 版本中,
doctl harness-runtime start在创建会话前会把 Claude Code spec 的ANTHROPIC_API_KEY发送给 Anthropic 进行校验;如果该密钥是用于 DigitalOcean 托管推理的 DigitalOcean 令牌,校验就会失败。遇到这种情况时,可直接把同样的清单提交到 sessions API。示例仓库的specs/目录提供了一个简短的start-session.py,它读取 spec,将${DIGITALOCEAN_ACCESS_TOKEN}替换为实际值,然后调用POST /v2/agents/sessions(python3 specs/start-session.py specs/agents.yaml)。它生成的会话与之前的完全相同。
无论如何,经过 10 到 15 秒后,您会得到一个名为 anish-fork-lab、状态为 ready 的会话:
doctl harness-runtime show anish-fork-lab
您可以在控制台聊天中使用 doctl harness-runtime attach anish-fork-lab 与其交互,也可以通过向 sessions API 发送请求。对于这样的实验,我想把提示放在一个可重复运行的文件中,于是我使用了一个小助手(specs/mars.py 在示例仓库中),它会向 /v2/agents/sessions/{id}/input 发送一条消息,并跟随事件流直到运行结束:
python3 specs/mars.py send anish-fork-lab "your prompt here"
步骤 3:只执行一次昂贵的设置
这是您希望仅付费一次的回合。提示告诉代理要设置什么、要测量什么,最重要的是,将它学到的内容写入文件:
Set up the repo so it is ready to work on. Steps:
1) git clone https://github.com/anishsingh20/harness-fork-lab into /workspace/harness-fork-lab.
2) Inside it, python3 -m venv .venv and install requirements.txt with .venv/bin/pip.
3) Run .venv/bin/python -m pytest -q and confirm all tests pass.
4) Run .venv/bin/python bench.py and note the time and checksum.
5) Write /workspace/harness-fork-lab/BRIEF.md containing: the repo layout, exact commands
   to run tests and the benchmark, the baseline time and checksum you measured, and the
   rule that all tests and the checksum must stay unchanged by any optimisation.
Do not modify any code. Finish with a short summary of the baseline numbers.
以下是裁剪后的运行。左侧的时间为自发送提示起经过的秒数。
   5.1s [tool ] Bash: git clone https://github.com/anishsingh20/harness-fork-lab /workspace/harness-fork-lab
   5.5s [done ] ok 486 ms   Cloning into '/workspace/harness-fork-lab'...
   7.5s [tool ] Bash: cd /workspace/harness-fork-lab && python3 -m venv .venv
  11.4s [done ] ok 3962 ms
  13.4s [tool ] Bash: .venv/bin/pip install -r requirements.txt
  15.5s [done ] ok 2236 ms  Collecting pytest==8.4.2 ...
  17.3s [tool ] Bash: .venv/bin/python -m pytest -q
  17.6s [done ] ok 256 ms   15 passed in 0.04s
  19.5s [tool ] Bash: .venv/bin/python bench.py
  23.9s [done ] ok 4461 ms  orders=20000 runs=1 best=4336.1 ms checksum=5c1322b035d743e3
  26.5s [tool ] Bash: .venv/bin/python bench.py
  30.8s [done ] ok 4375 ms  orders=20000 runs=1 best=4249.4 ms checksum=5c1322b035d743e3
         [agent] Good — checksum is stable. Now let me look at the repo layout before writing the brief.
  53.0s [tool ] Write: /workspace/harness-fork-lab/BRIEF.md
         [agent] Baseline numbers:
         [agent] - 15 tests pass in 0.04s (pytest -q)
         [agent] - Benchmark: orders=20000 runs=1 best≈4,250–4,340 ms checksum=5c1322b035d743e3
         [agent] The checksum 5c1322b035d743e3 is the hard constraint — it must not change across any
                 optimisation. The slowness comes from orders/report.py, where every aggregation
                 function does an O(n×k) double loop ...
  58.9s [run  ] completed: in=12 out=1892 cost=$0.2764
代理时间五十七秒,推理成本0.28美元,机器处于已知良好状态:仓库已克隆,.venv 已构建,15 项测试通过,基准 4,250 至 4,340 毫秒,校验和 5c1322b035d743e3,磁盘上的 BRIEF.md 文件说明了所有这些内容。
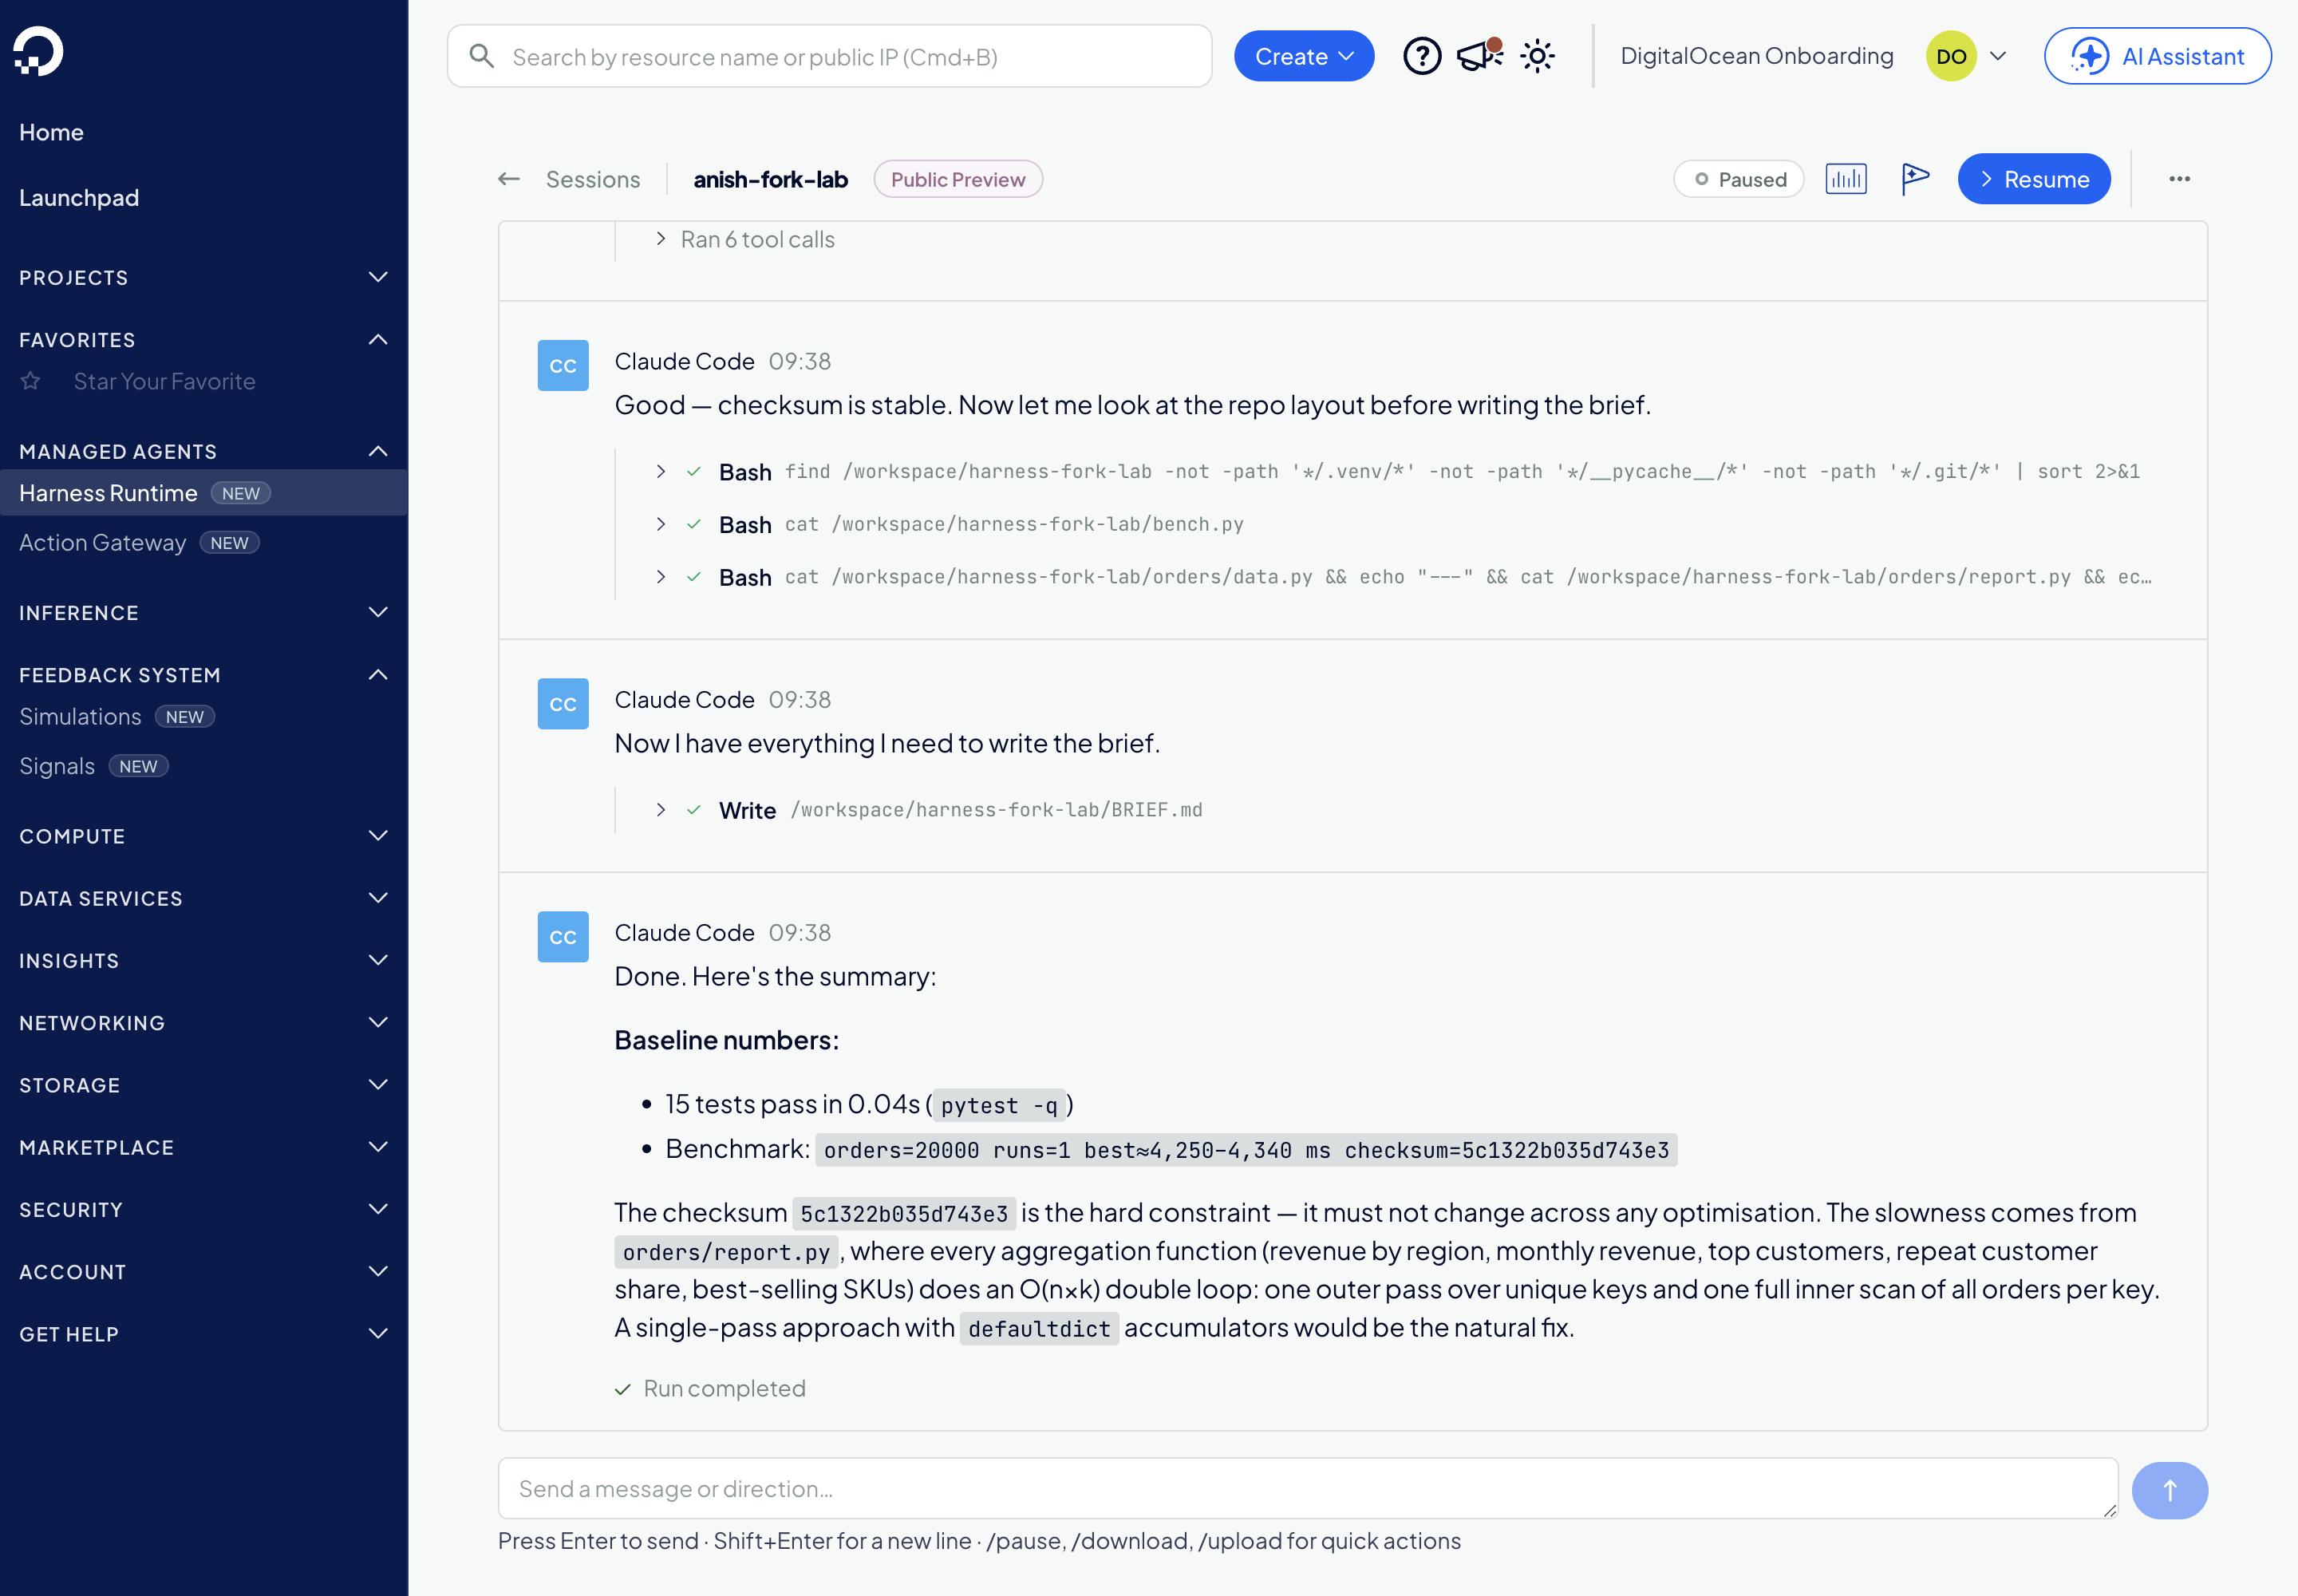
这是在控制台中看到的同一轮操作。左侧边栏在 Managed Agents 下显示 Harness Runtime。标题将会话命名为 anish-fork-lab,并带有 Public Preview 徽章及其状态标签(截图时为暂停状态)。在转录中,每个 Bash 和 Write 行都是代理所做的工具调用;最后一条消息是代理自己的摘要,包含基准数字、校验和以及对 O(n×k) 循环的诊断。绿色的 Run completed 标志着这一轮的结束。此刻是保存的时机。
步骤 4:保存检查点
doctl harness-runtime checkpoint create anish-fork-lab --label deps-installed-tests-green
Checkpoint created

  Name     deps-installed-tests-green
  ID       cp_97dafbedc792
  Status   ● ready
  Kind     explicit
  Size     84.0 GB
  Created  just now

Next step
  rollback doctl harness-runtime rollback 01a0b7cf-9b61-7b14-9da7-cfb110cc44a0 cp_97dafbedc792
该命令耗时 27 秒。从输出中可以得到两点信息。Kind explicit 表示我是有意创建的,这与你省略 --from-checkpoint 时 fork 自动生成的隐式检查点不同。Size 84.0 GB 表示捕获的沙盒大小,而不是仓库大小;该大小在此沙盒的每个检查点上保持不变。请记住此 ID:cp_97dafbedc792。后续内容均基于此 ID。
doctl harness-runtime checkpoint list anish-fork-lab
1 checkpoint

● deps-installed-tests-green
  explicit · ready · 84.0 GB · Created just now
  cp_97dafbedc792
控制台显示相同的检查点。打开会话,点击右上角的 ⋯ 菜单,然后选择 Checkpoints。
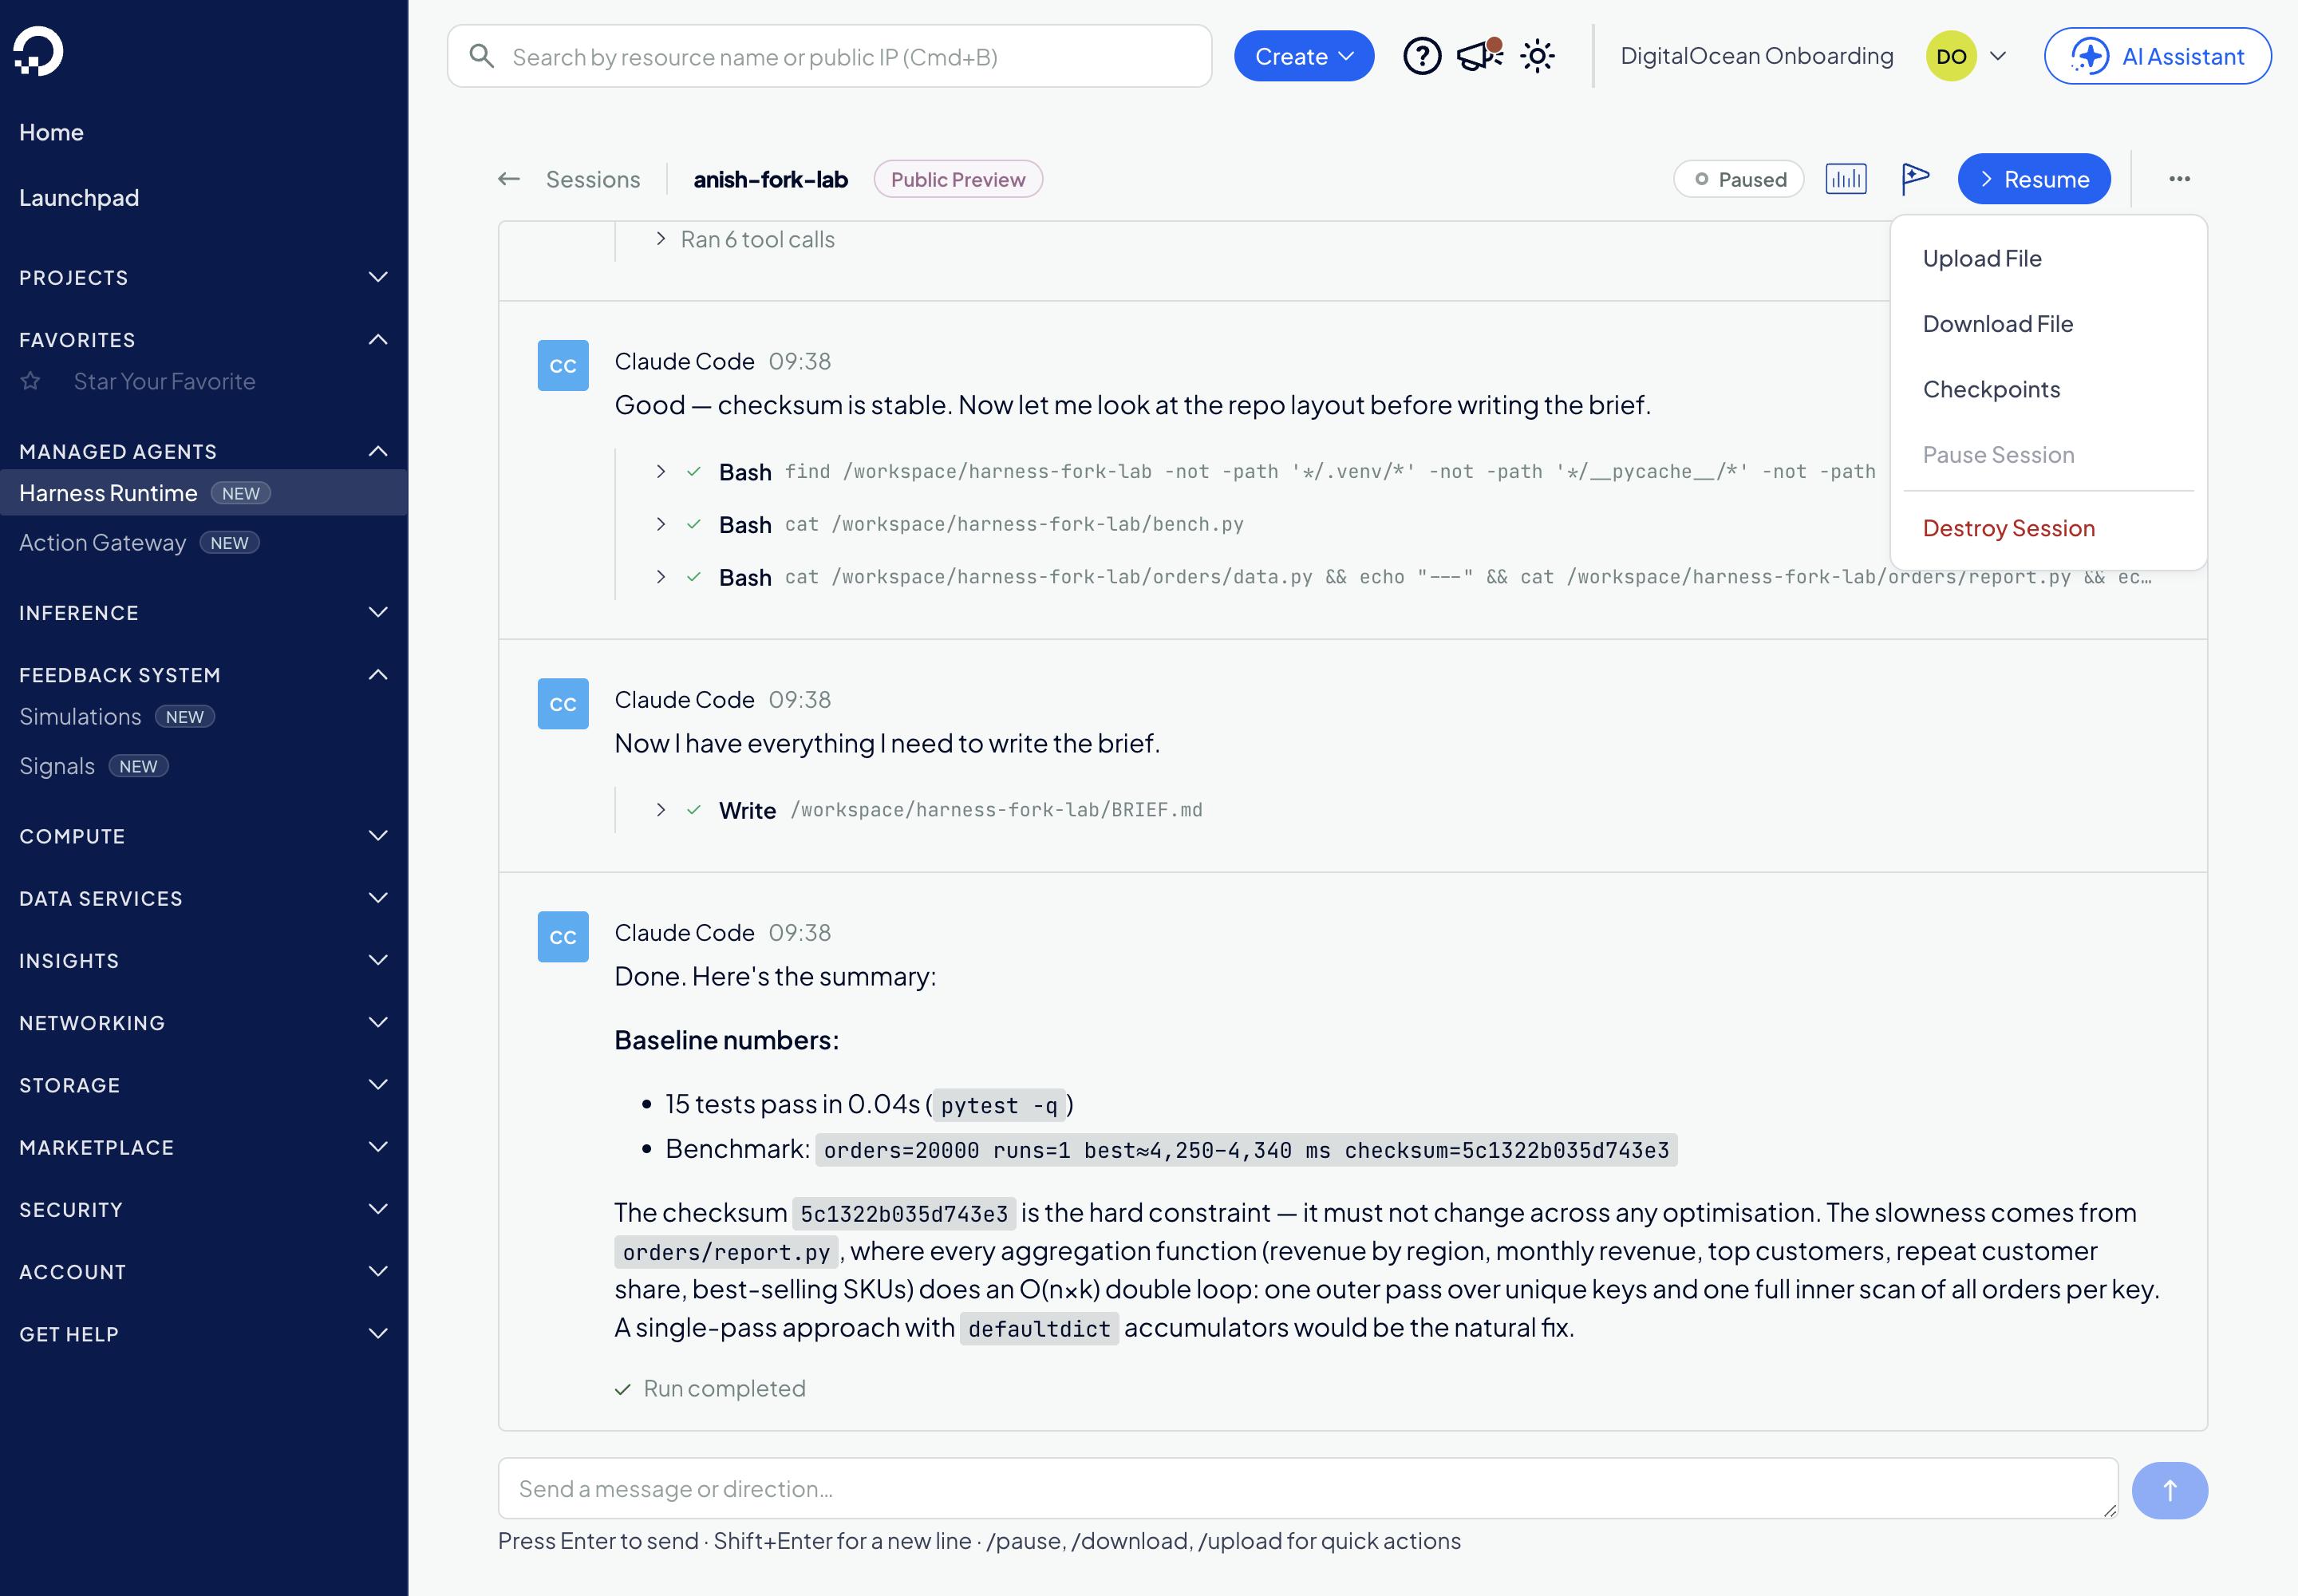
此菜单是会话级操作的所在位置。Upload File 和 Download File 在沙盒之间移动文件,Checkpoints 打开下面所示的抽屉,Pause Session 因会话已暂停而置灰,Destroy Session 会销毁该机器。此菜单中的内容与 fork 无关;fork 是一个完整的会话,拥有相同的菜单。
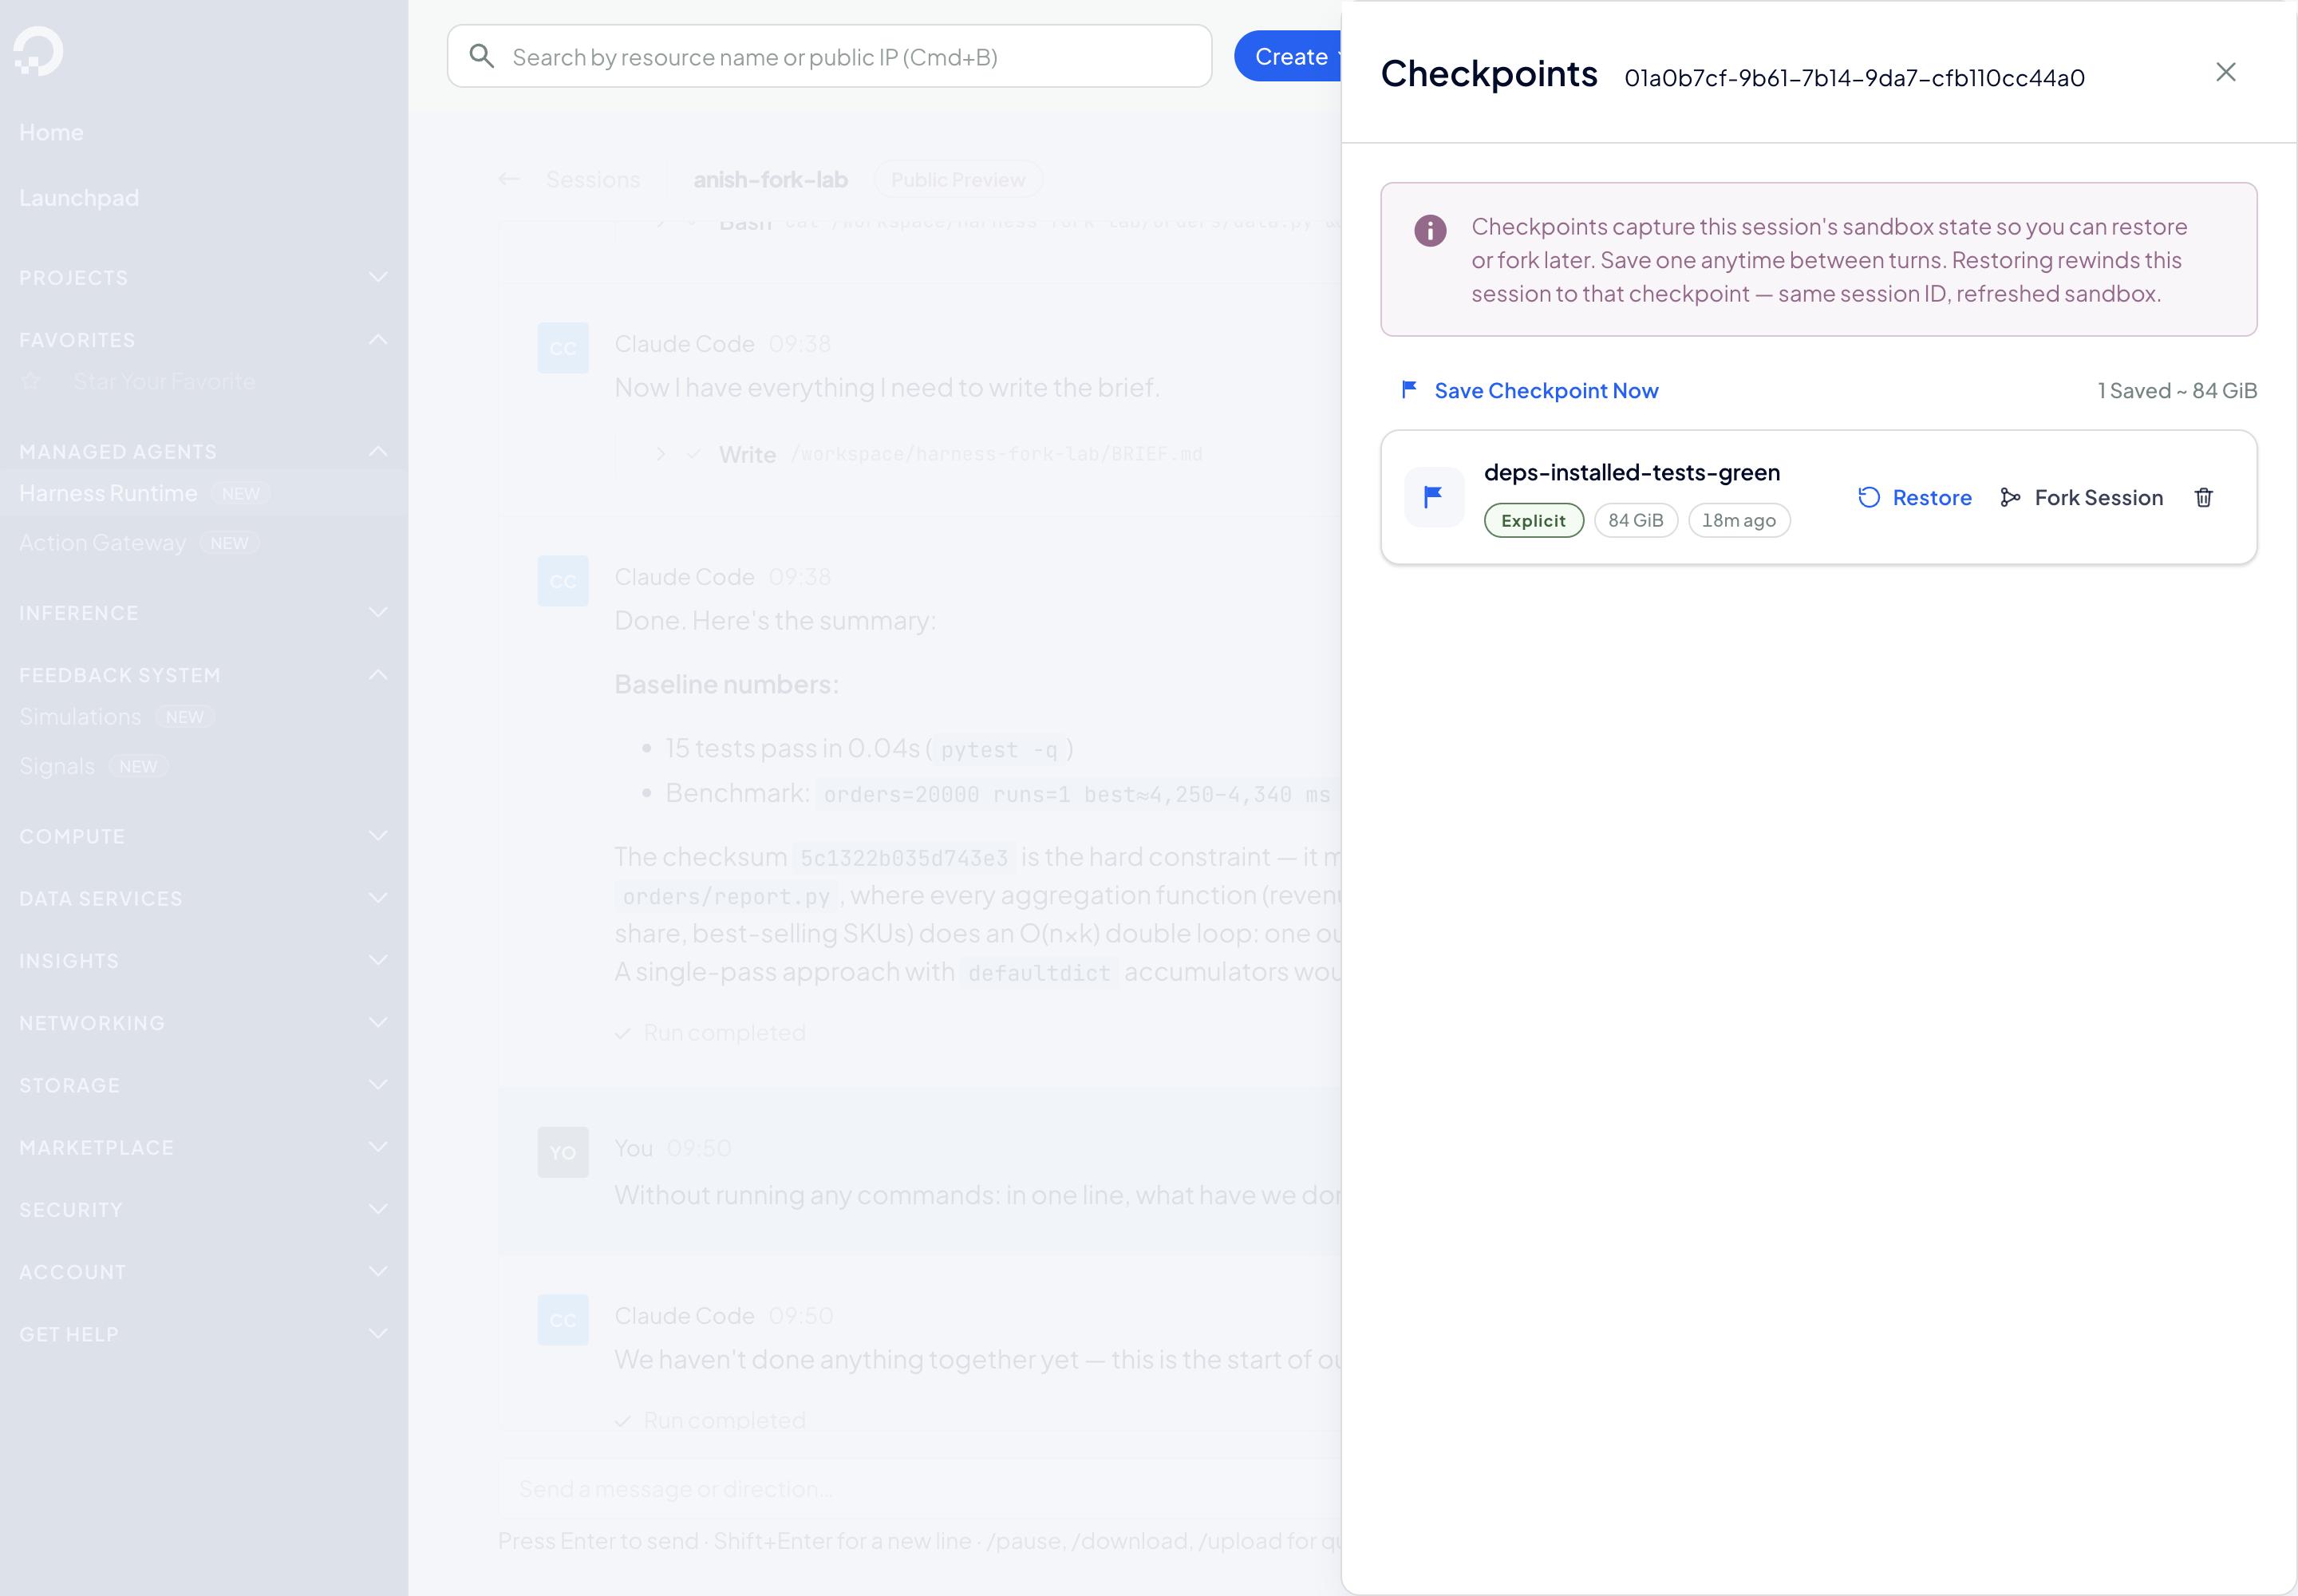
此抽屉将完整功能集中在一个面板中。顶部的蓝色框是产品自身的定义,与我的观察一致:检查点捕获沙盒状态,您在轮次之间保存它们,而恢复则在刷新沙盒的同时保持会话 ID 不变。Save Checkpoint Now 相当于终端中的 checkpoint create 命令。单张卡片是我的检查点:我为其设定的标签、一个 Explicit 标签、84 GiB 的大小以及其年龄。卡片上的两个按钮正是本文要介绍的两种操作:Restore(回滚)和 Fork Session。垃圾桶图标用于删除检查点。如果您更倾向于点击而非输入,可以从此处继续完成本实验的其余步骤。
步骤 5:三种方式进行 fork
一条命令,三个独立的会话:
doctl harness-runtime fork anish-fork-lab --from-checkpoint cp_97dafbedc792 --count 3
3 sessions

● session-claude-code-20260919-040924-fork-4cb82464
  Claude Code · ready · Created just now

● session-claude-code-20260919-040924-fork-8ff88358
  Claude Code · ready · Created just now

● session-claude-code-20260919-040924-fork-40922fb4
  Claude Code · ready · Created just now
按下 Enter 到三个 ready 会话只用了 10.6 秒。相比之下,准备阶段耗时 57 秒,且请记住,准备阶段是设置的廉价版本。子进程的名称来源于父进程的 agent 类型和时间戳,末尾附带一个 8 字符的 fork ID。在本文剩余部分,我将它们称为 分支 A(4cb82464)、分支 B(8ff88358)和 分支 C(40922fb4)。
父进程知道它的子进程:
doctl harness-runtime list --parent-session-id 01a0b7cf-9b61-7b14-9da7-cfb110cc44a0 -o json
每条子记录携带 parent_session_id 指向 anish-fork-lab,以及自身的 session_id 和 fork_id。它们共享父记录的 config_id,这就是你在步骤 1 中编写的规格。
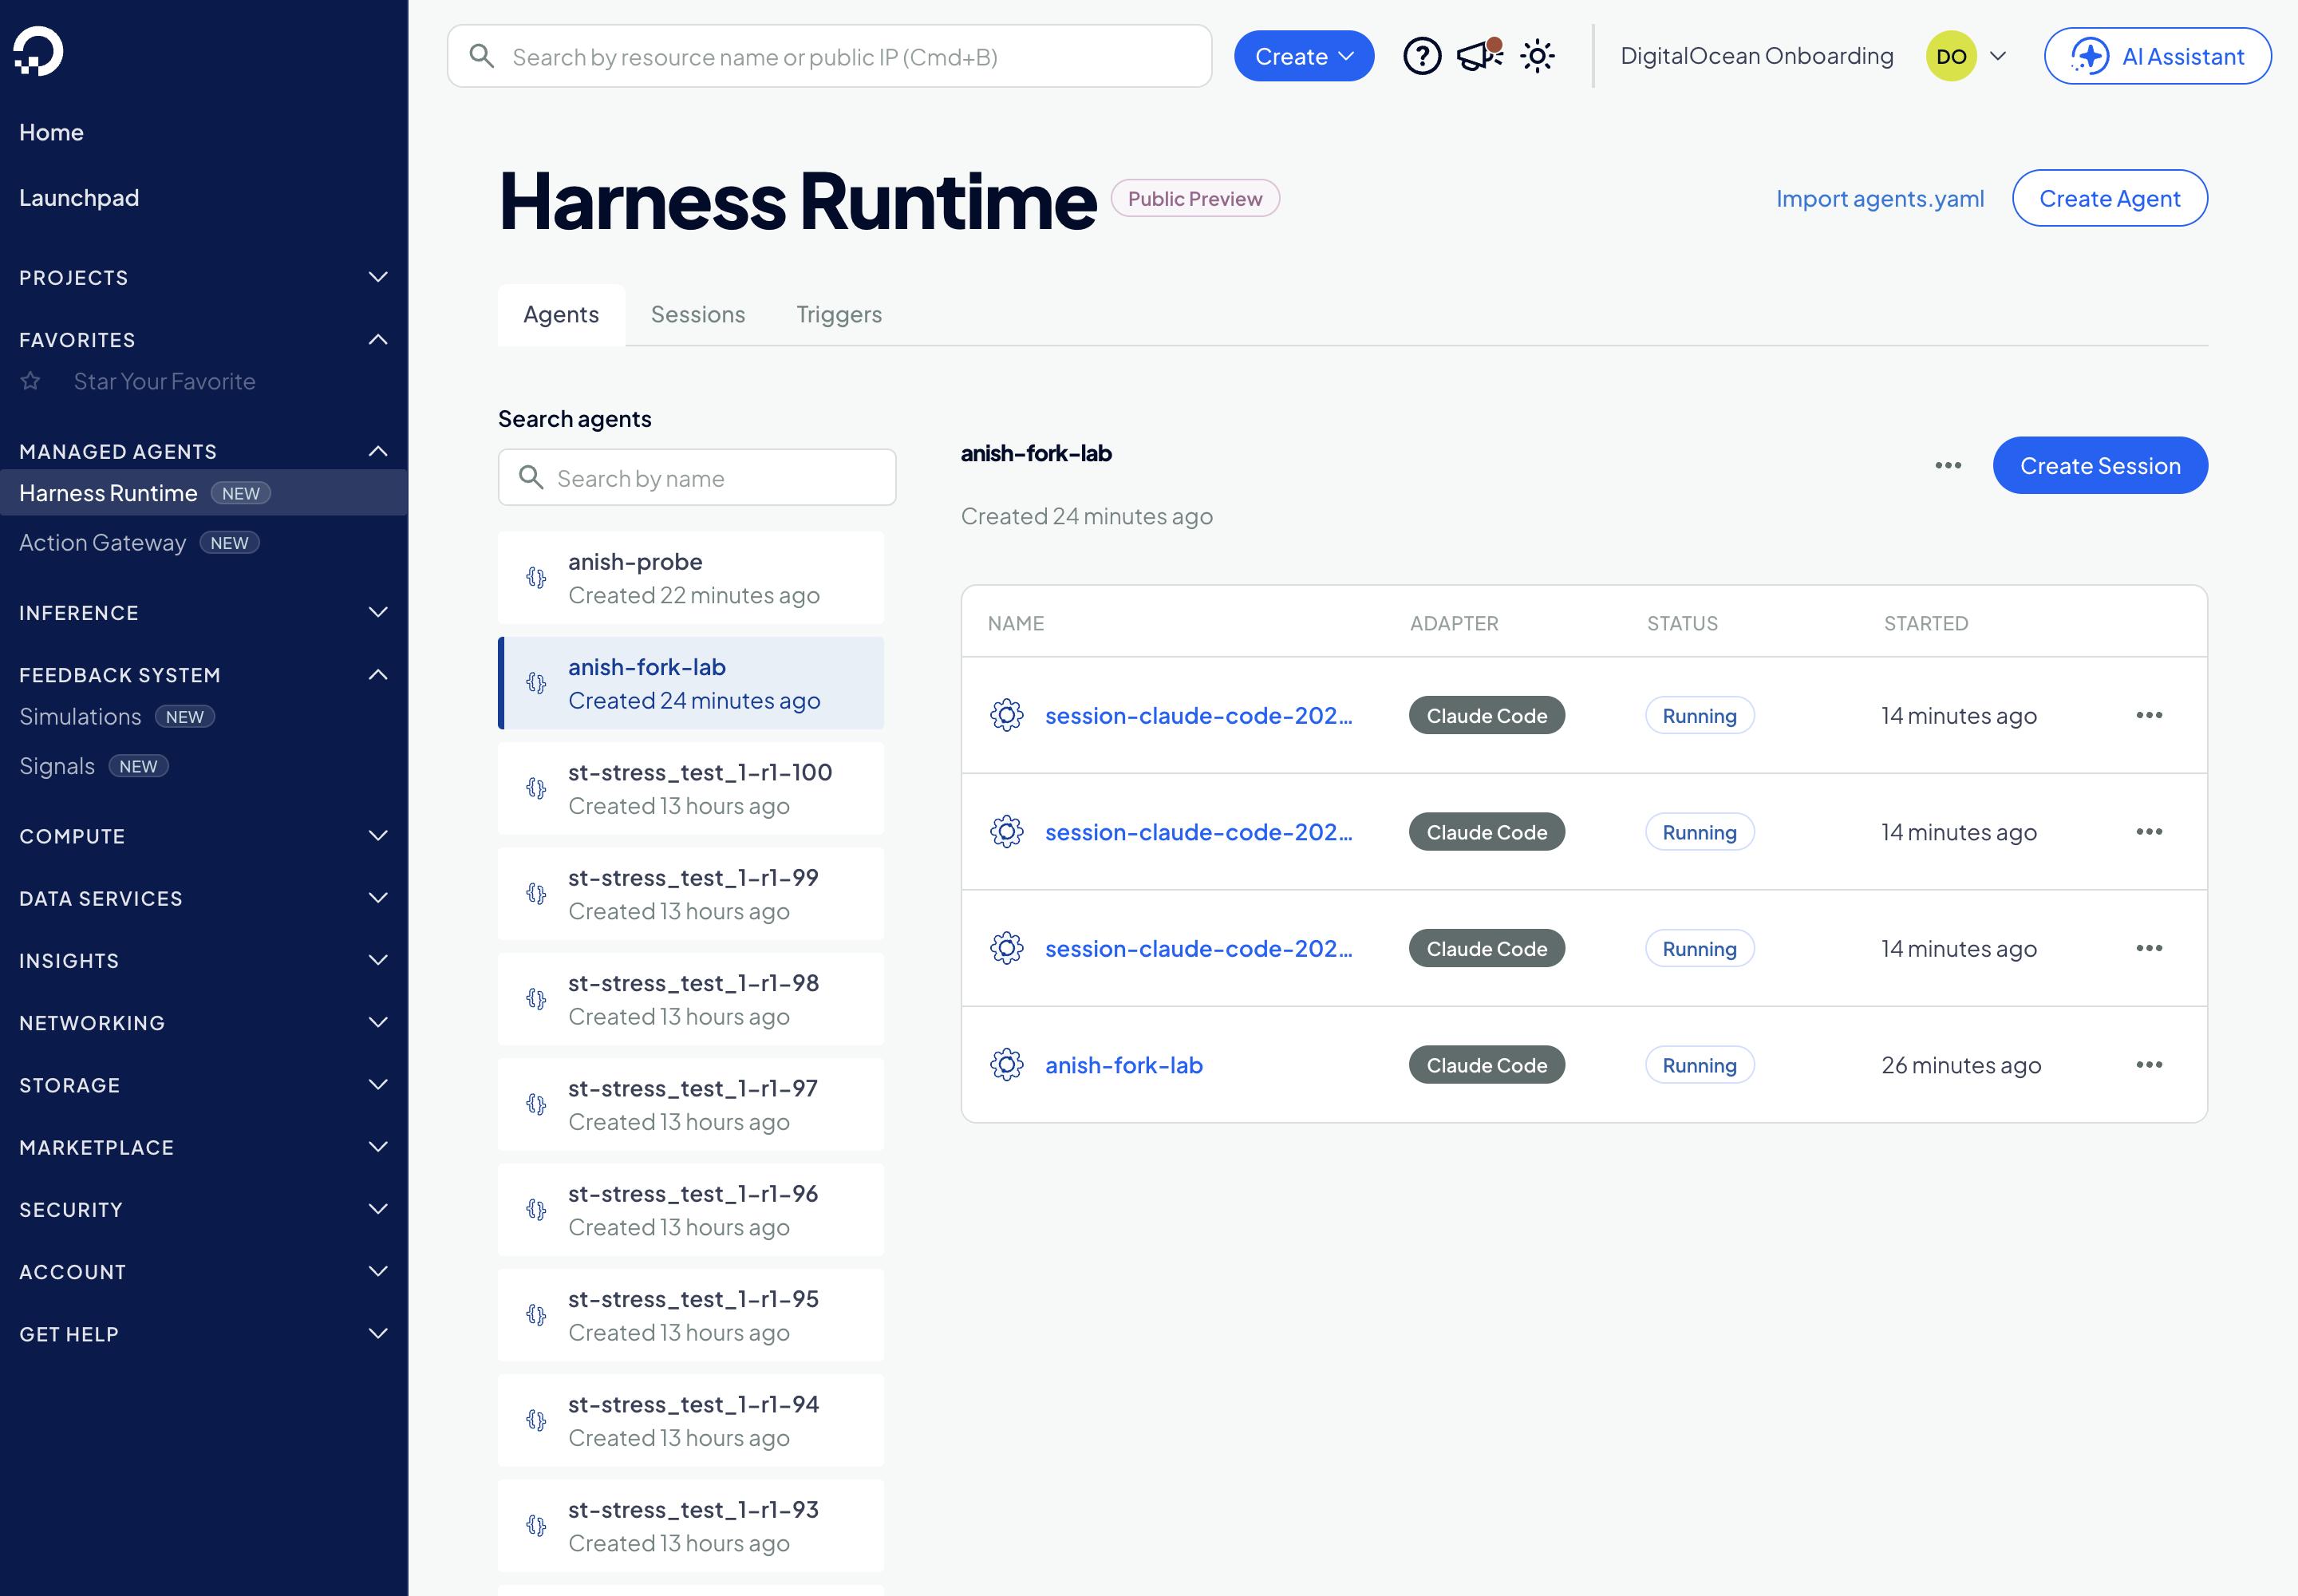
这是分叉后在控制台看到的代理页面。左侧列出代理:步骤 1 的规格是被选中的那个,anish-probe 是我之前用来学习 API 的临时代理,而 st-stress_test 条目属于同一团队的其他成员。右侧的表格显示了基于 anish-fork-lab 规格运行的所有会话:底部是父会话,启动于 26 分钟前;其上方的三个分叉会话均在同一秒内启动,距今 14 分钟。这四个会话均显示适配器为 Claude Code,状态为 Running。表格中没有标记“fork”;每个子会话都是独立的一等会话,你可以自行打开、聊天、暂停或销毁。
验证分叉是否继承了设置。 这是关键的断言,因此在发送任何工作之前请先检查。doctl harness-runtime exec 在会话的沙箱内直接运行命令,不经过代理,这使得它成为一个公平的检查:答案不依赖于代理选择告诉你的内容。
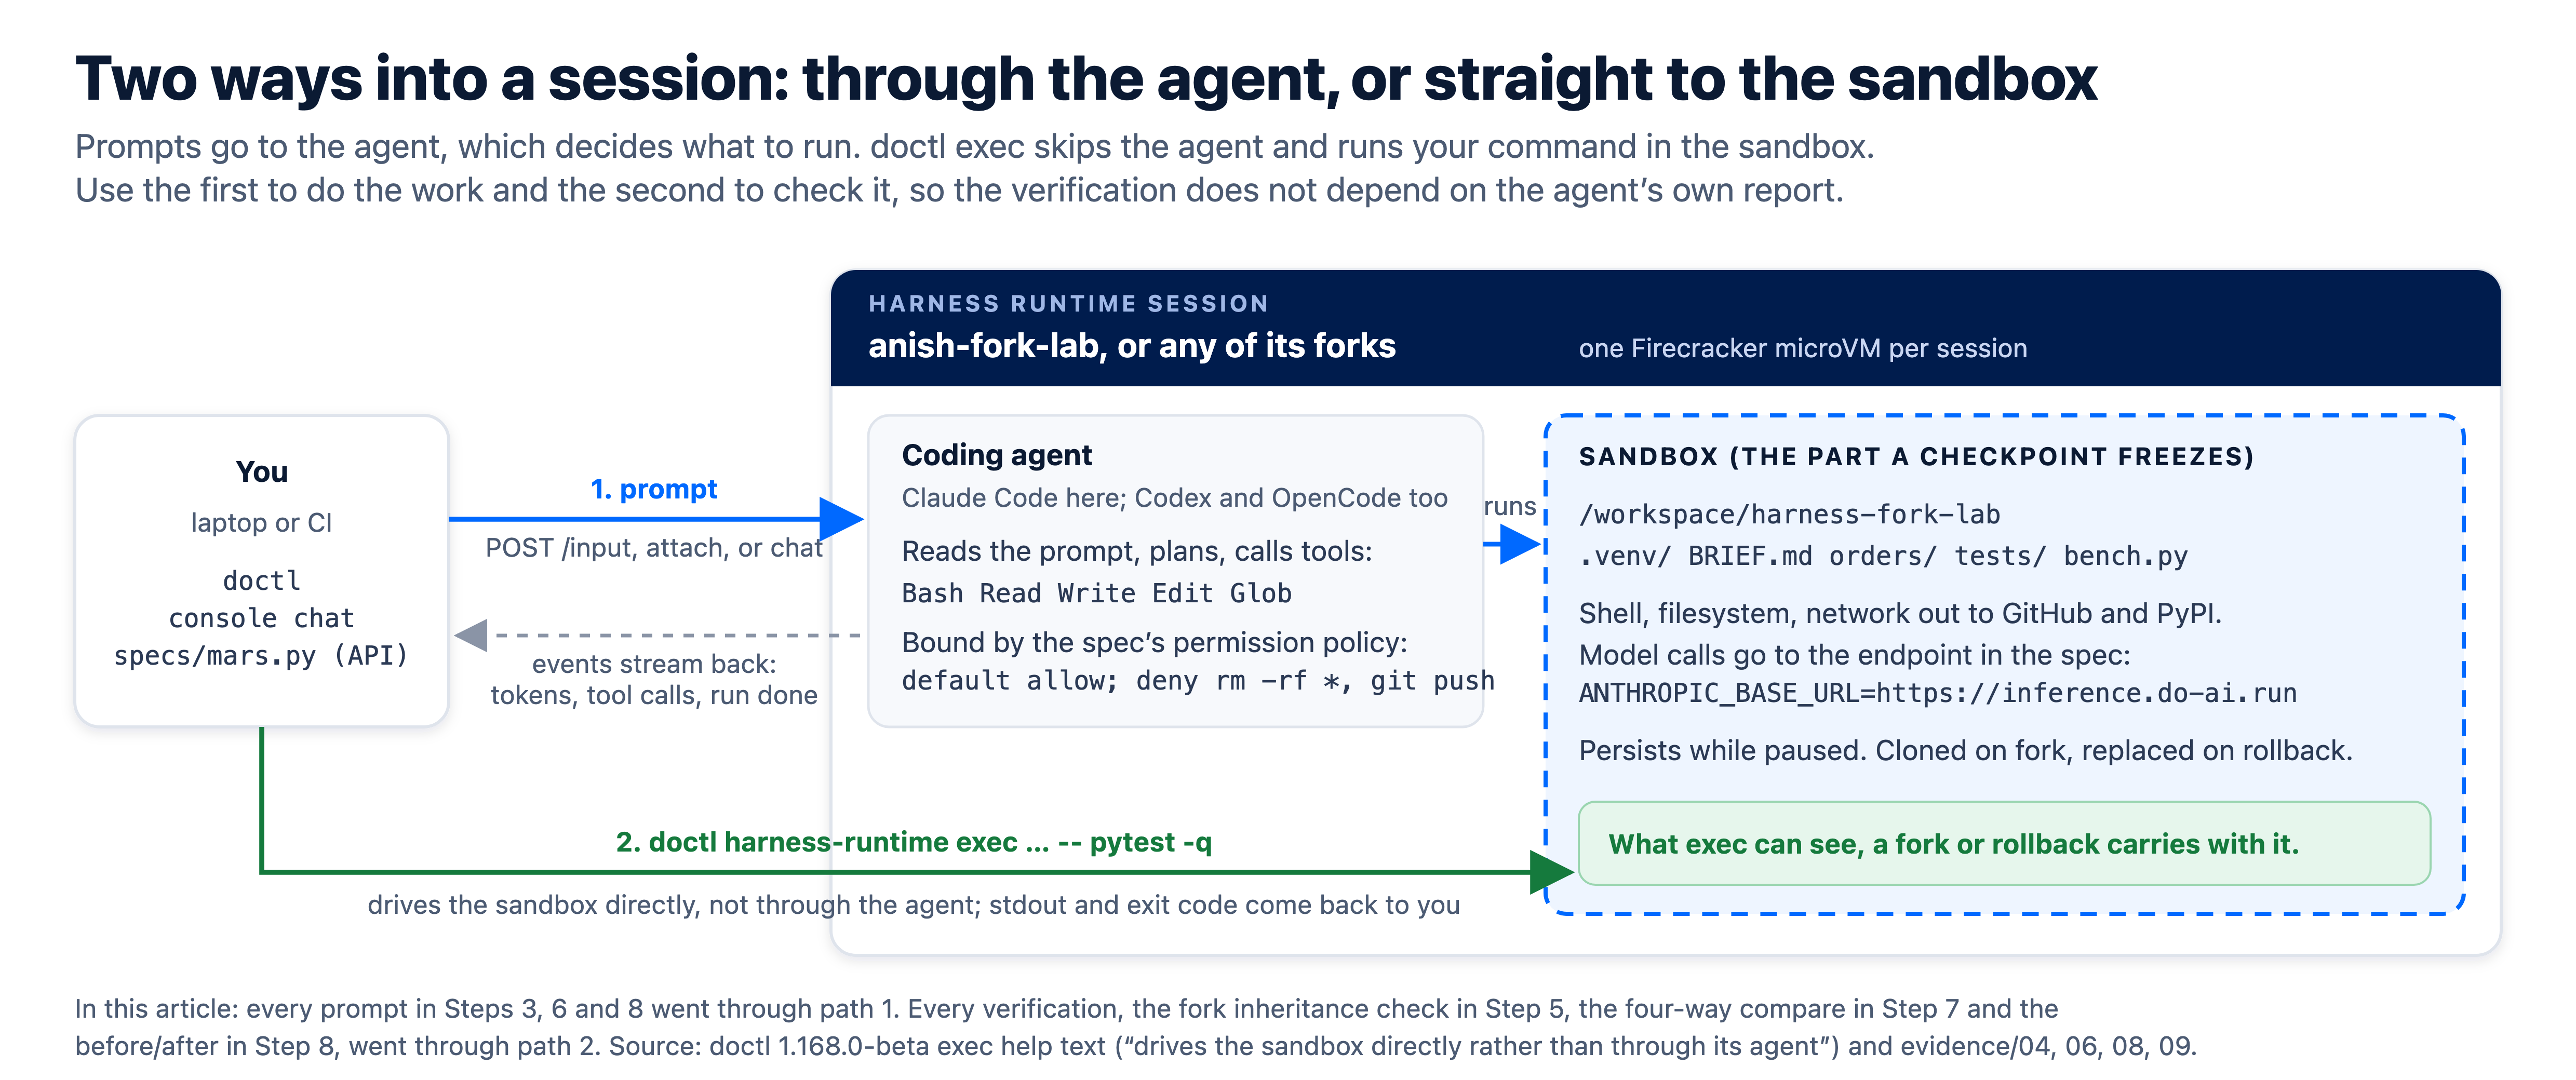
此图示展示的内容:
- 有两种不同的方式可以到达一个会话,本文根据不同的任务分别使用了这两种方式。
- 路径 1,通过代理:你发送一个提示(来自
doctl、控制台聊天或小型mars.py脚本),Claude Code 读取它,决定要做什么,并在规格的权限策略内调用诸如Bash和Write之类的工具。事件流(令牌、工具调用、运行完成标记)会返回给你。本文中每个提示都采用了此路径。 - 路径 2,直接到沙箱:
doctl harness-runtime exec直接在机器上运行命令,位于代理之下,并返回标准输出和退出码。本文中的每次验证都采用了此路径:这里的继承检查、步骤 7 的四路比较以及步骤 8 的前后对比。 - 沙箱是检查点冻结的部分。代理则不是。
- 这并不意味着:代理仍然可以看到
exec所做的事情,因为它们共享同一块磁盘。关键在于,你的检查不依赖于代理的配合或其内存。
来源:1.168.0-beta 版的 doctl harness-runtime exec --help(“直接驱动沙箱而非通过其代理”);步骤 1 的规格;步骤 5、7 和 8 中重现的 exec 运行。
在所有三个会话中运行测试:
for s in 4cb82464 8ff88358 40922fb4; do
  doctl harness-runtime exec session-claude-code-20260919-040924-fork-$s \
    --workdir /workspace/harness-fork-lab -- .venv/bin/python -m pytest -q
done
...............                                                          [100%]
15 passed in 0.04s
...............                                                          [100%]
15 passed in 0.03s
...............                                                          [100%]
15 passed in 0.03s
三个沙箱,每个沙箱都包含仓库、.venv、已安装的 pytest 以及 15 个通过的测试,而这些测试他们自己并未编写。BRIEF.md 也在其中。这就是“捕获整台机器”在实践中的含义。
步骤 6:为每个分叉提供不同的策略
现在进行实验。每个分叉获得相同的框架和不同的一行策略。框架首先将代理指向 BRIEF.md,因为分叉的代理对设置回合没有记忆(在第 8 步中会进一步说明),并要求以固定形式给出摘要,这样三个结果就易于并排比较。
每个提示的共享部分:
Read /workspace/harness-fork-lab/BRIEF.md first and follow its rules: all 15 tests must pass
and the bench.py checksum must stay 5c1322b035d743e3. Your job is to make build_report in
orders/report.py fast using exactly one strategy:


Run the tests and run bench.py twice when you are done. Do not touch tests/. Finish with a
summary in this shape: Strategy used, Files changed, Lines changed (git diff --stat),
Before and After times in ms, Checksum.
下面是三条策略路线:
| 分支 | 策略路线 |
|---|---|
| A | Strategy A (single pass): Rewrite each aggregation in orders/report.py to use one pass over the orders with dict or collections accumulators. |
| B | Strategy B (profile first, minimal diff): Profile build_report with cProfile, find the single hottest function, and fix only that one. Keep the diff as small as possible. |
| C | Strategy C (pandas): Install pandas into .venv, add it to requirements.txt, and rewrite build_report to load the orders into a DataFrame and use vectorised groupby operations. |
无需等待,一次性发出全部三条:
python3 specs/mars.py send session-claude-code-20260919-040924-fork-4cb82464 "$PROMPT_A" &
python3 specs/mars.py send session-claude-code-20260919-040924-fork-8ff88358 "$PROMPT_B" &
python3 specs/mars.py send session-claude-code-20260919-040924-fork-40922fb4 "$PROMPT_C" &
wait
所有三次运行均在 UTC 04:10:11 开始。Fork B 最先完成,时间为 04:11:00(49 秒),Fork A 为 04:11:43(92 秒),Fork C 为 04:13:18(187 秒)。三次完整独立的优化尝试的总墙钟时间略超过三分钟,此外还有一次设置回合。
步骤 7:比较结果
您可以在控制台中查看每个 Fork 的摘要。以下是它们按照完成顺序给出的摘要。
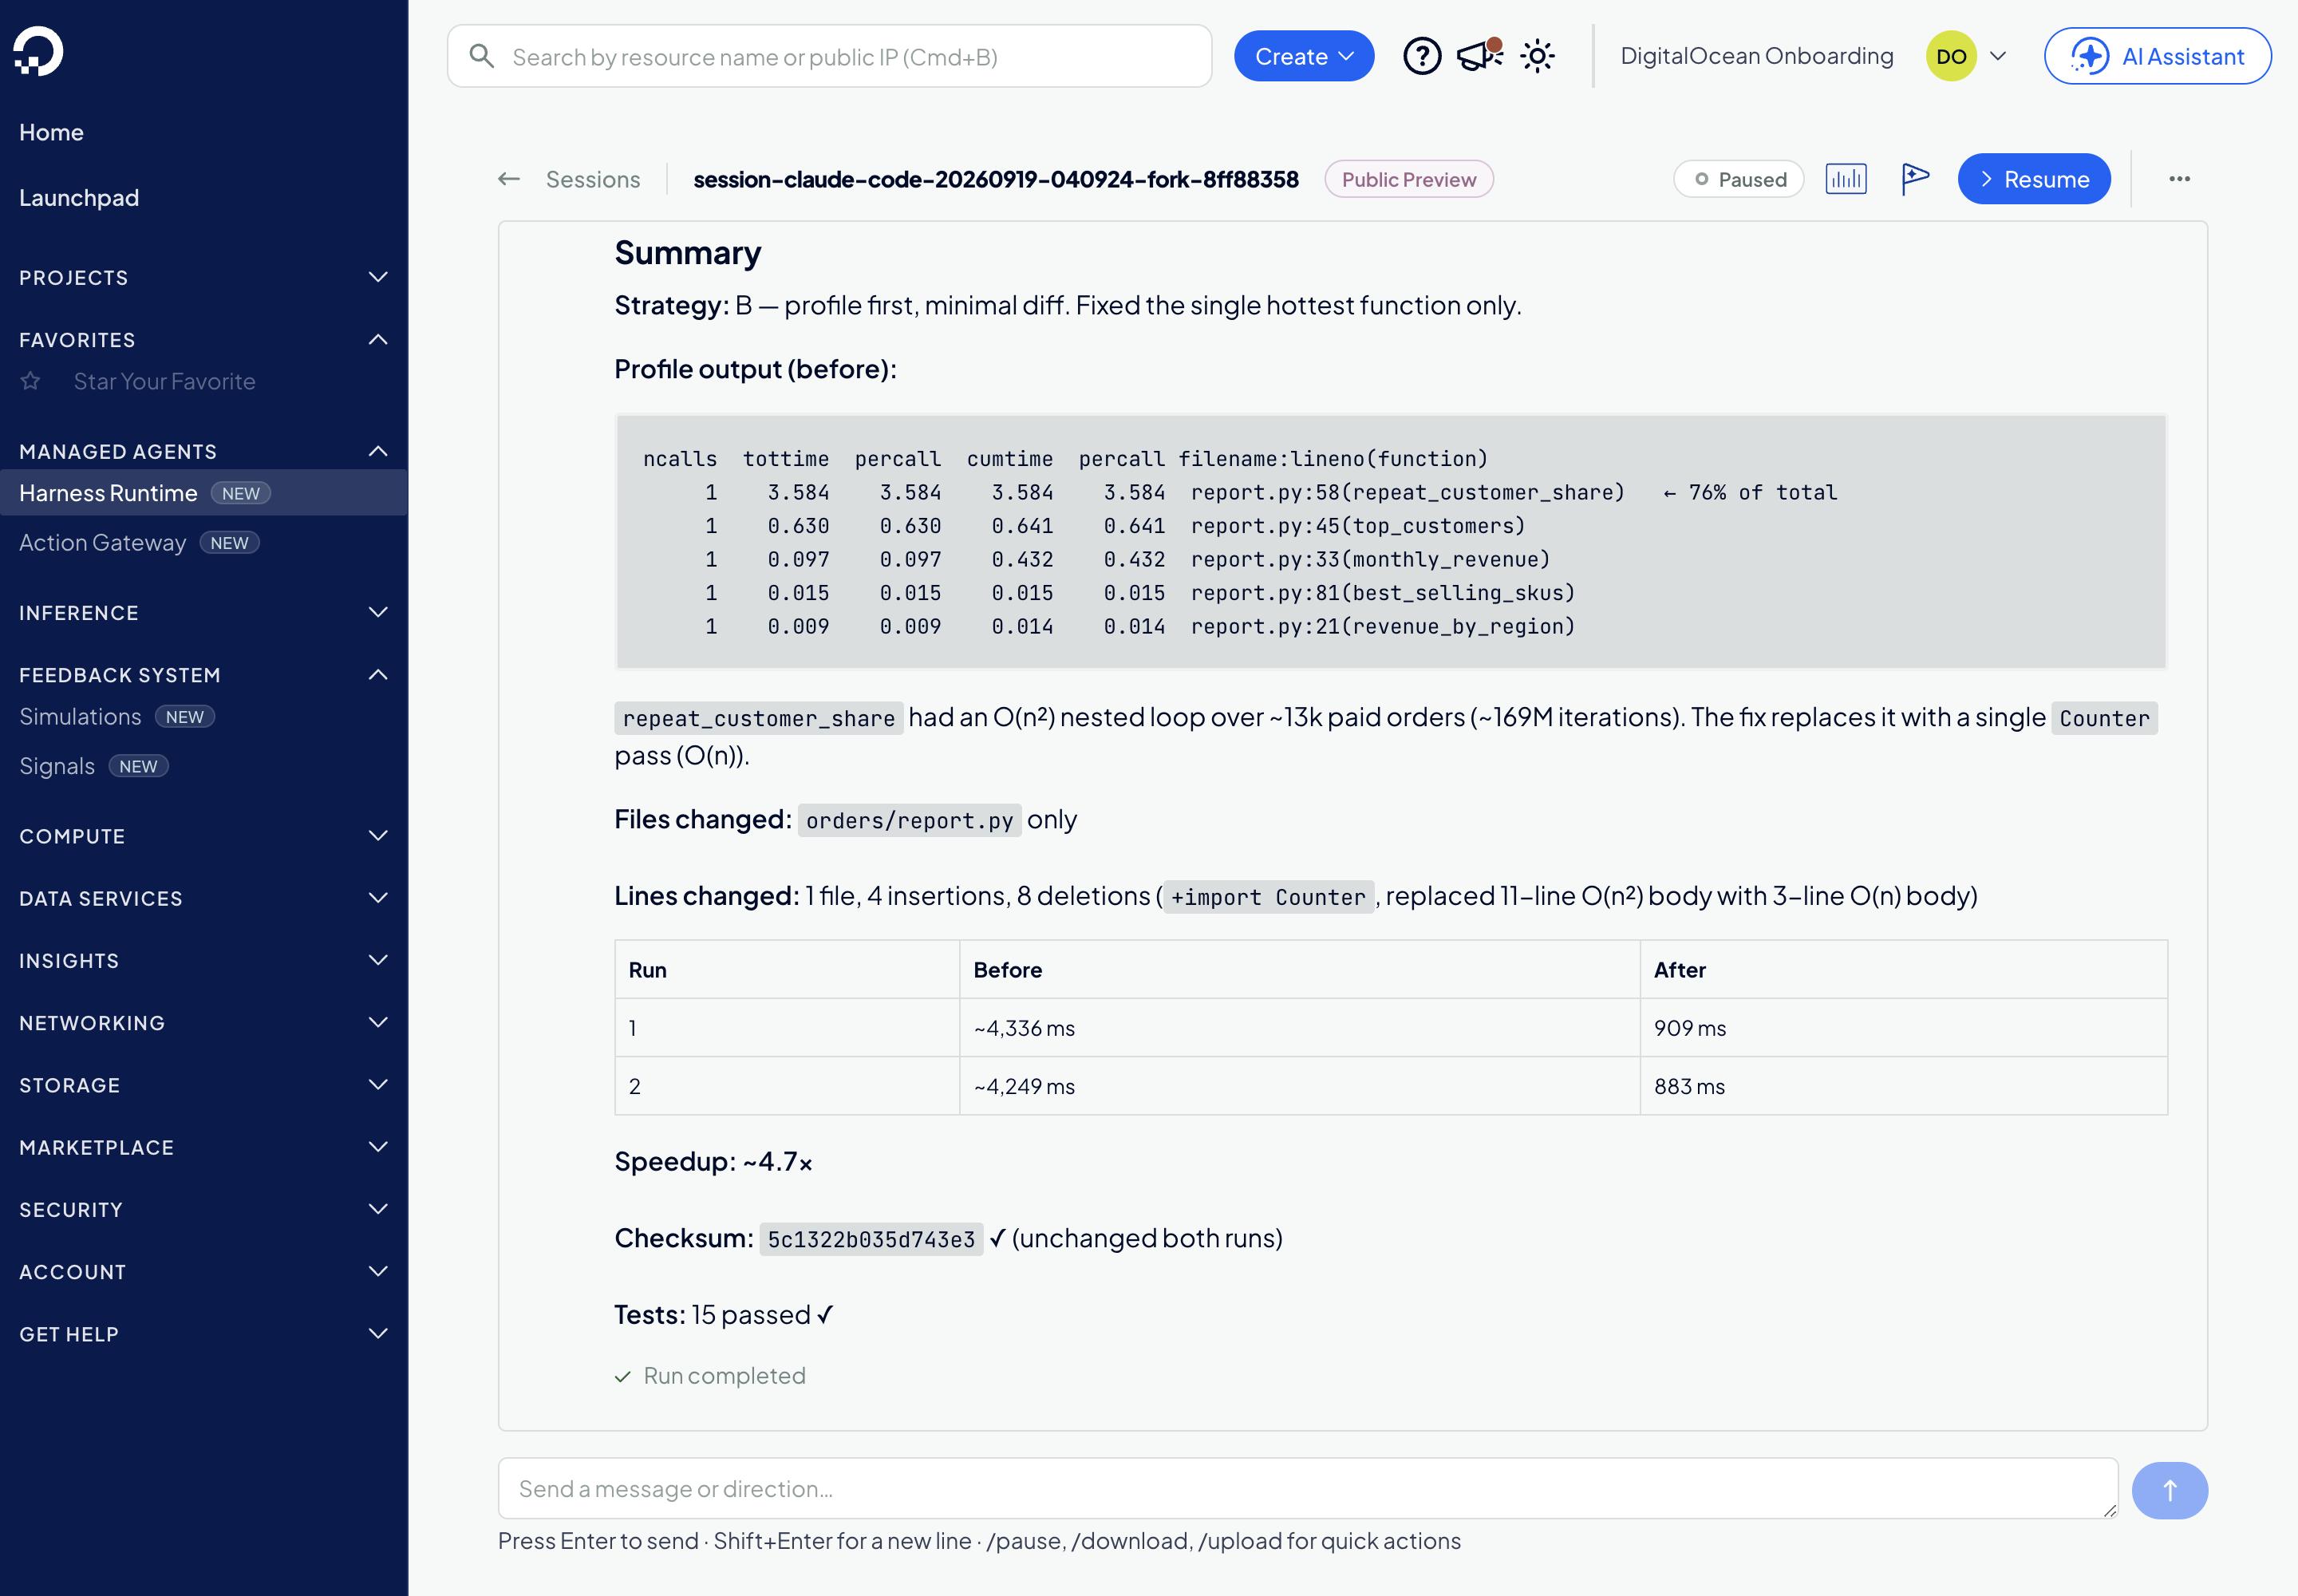
Fork B 首先做了一个细心工程师会做的事情。截图中间的性能表格讲述了全部故事:repeat_customer_share 单独占用了大约 4.3 秒中的 3.584 秒,占运行时间的 76%,这是因为之前展示的 O(n²) 循环所致。Fork B 用一个 3 行的 Counter 遍历替换了这 11 行代码,然后停止。结果是一个 12 行的 diff,速度提升了 4.7×,测试通过(green),校验和未变。它还留下了大约 880 ms 的空间,因为它只修复了一个函数,而其他四个函数仍在重新扫描。
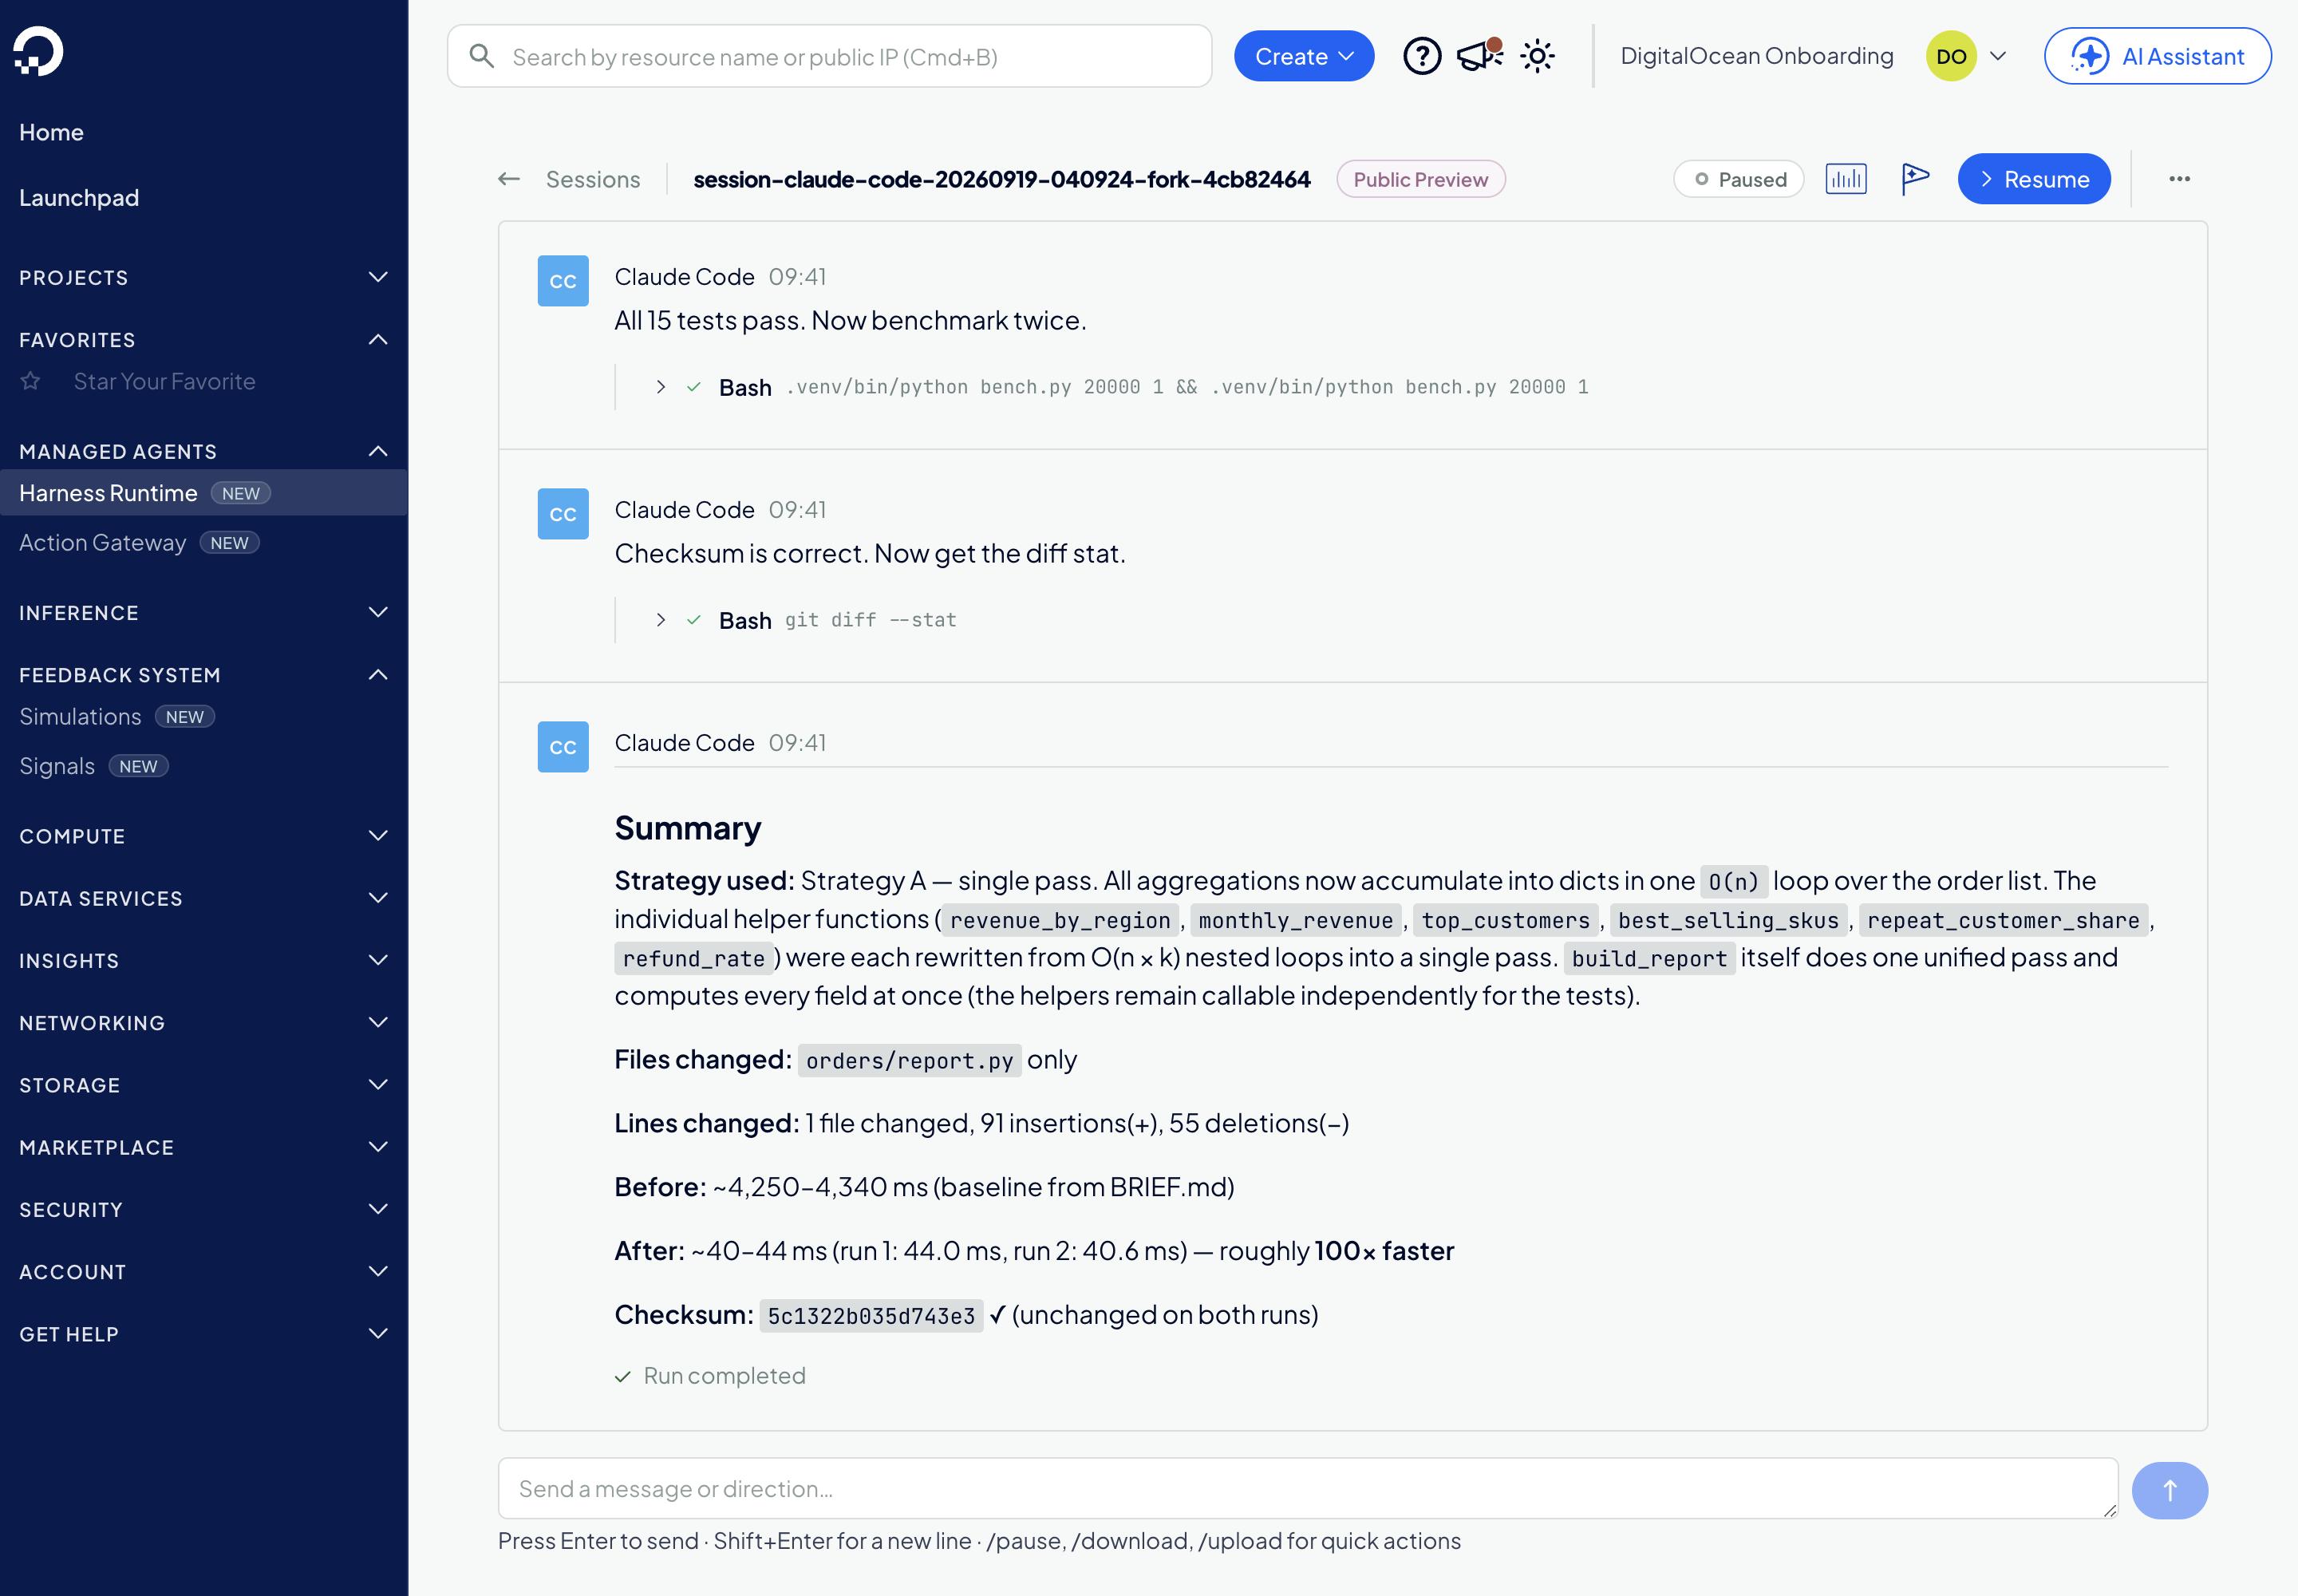
Fork A 使用字典累加器将每个聚合重写为单次遍历,并让 build_report 在一个循环中计算所有内容,同时保持各个辅助函数可导入,以便测试仍能调用它们。摘要上方的两行 Bash 是它的最终检查,分别运行 bench.py 两次和 git diff --stat。结果:一个文件,新增 91 行,删除 55 行,速度提升约 100×,耗时 40–44 毫秒,校验和未变,未引入新依赖。
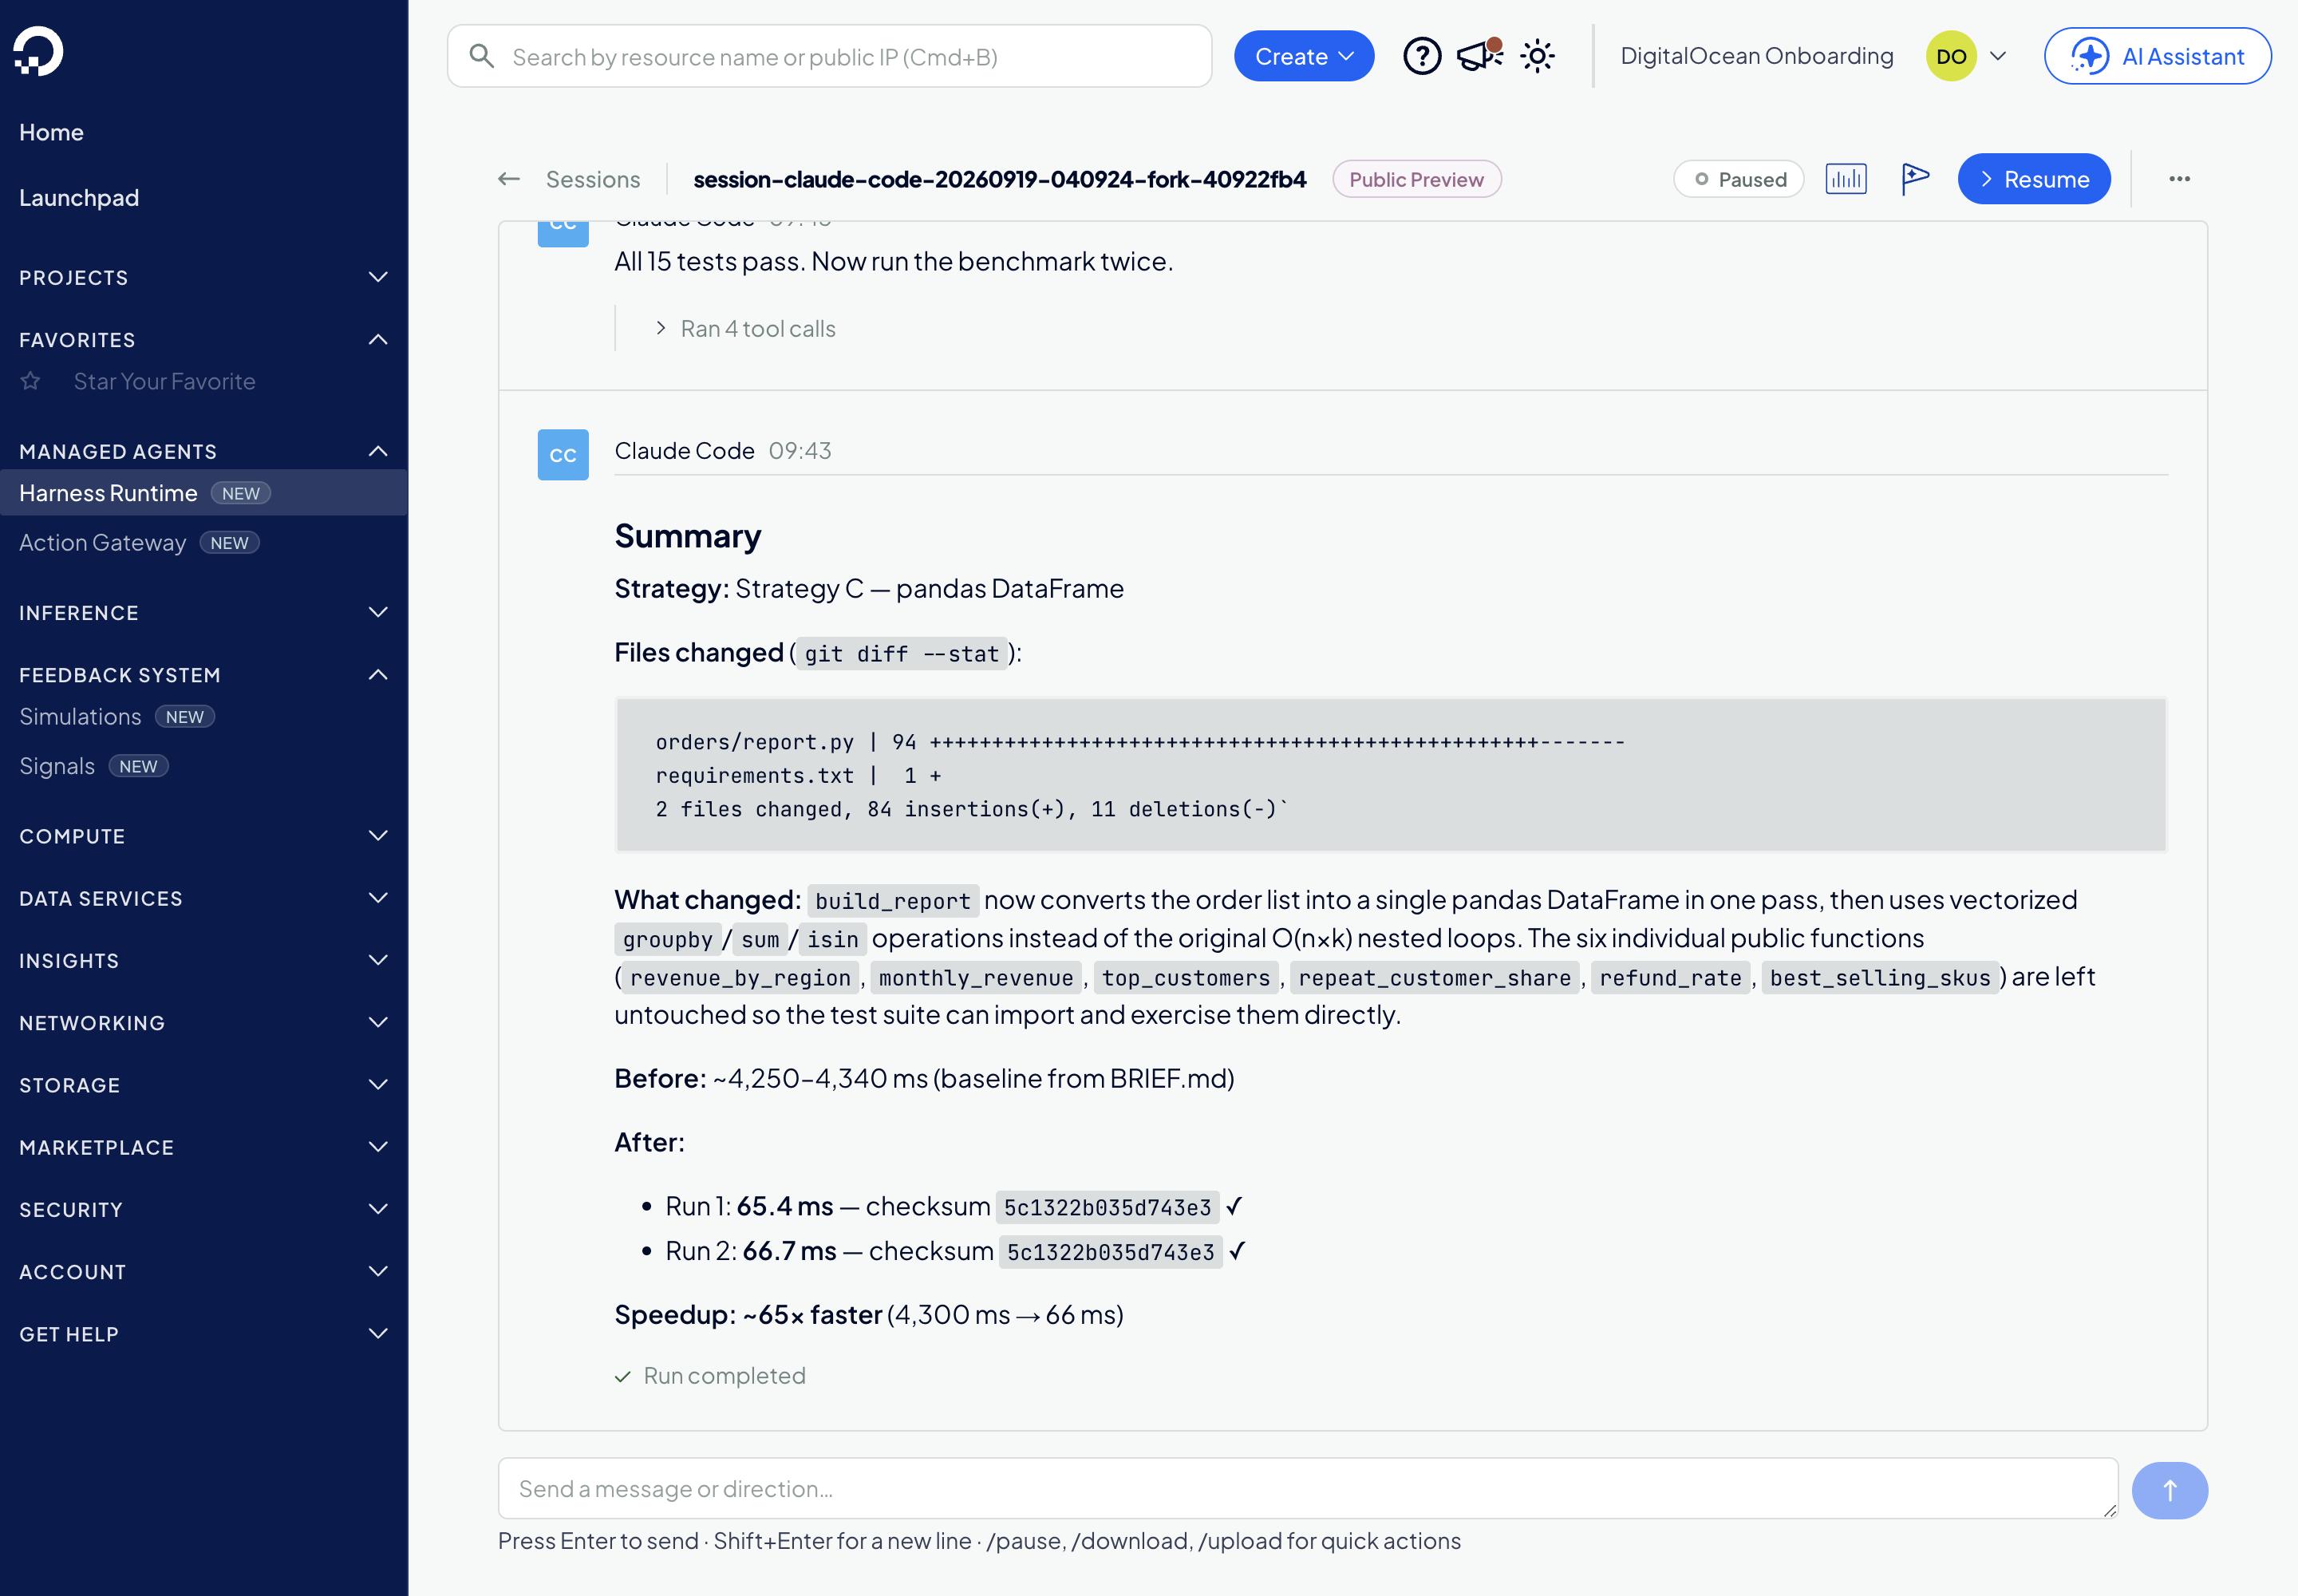
Fork C 耗时最长(187 秒),部分原因是在 2 vCPU 沙盒中安装 pandas 较慢,部分原因是它花时间担心(且正确地)numpy 整数类型会破坏 JSON 校验和。它最终达到了:65 毫秒,校验和完整。其代价可见于其摘要顶部附近的 git diff --stat 块:两个文件被修改,requirements.txt 中新增了一项运行时依赖,以及 84 行新代码,其结果比 Fork A 的无依赖版本慢。
不要只相信代理人的说法。在你的终端中,使用 exec 亲自在所有四个沙盒中运行相同的三次检查:
CHECK='git -c safe.directory="*" diff --shortstat; .venv/bin/python -m pytest -q | tail -1; .venv/bin/python bench.py'
for s in anish-fork-lab \
         session-claude-code-20260919-040924-fork-4cb82464 \
         session-claude-code-20260919-040924-fork-8ff88358 \
         session-claude-code-20260919-040924-fork-40922fb4; do
  echo "== $s"; doctl harness-runtime exec $s --workdir /workspace/harness-fork-lab -- sh -c "$CHECK"
done
== anish-fork-lab
15 passed in 0.03s
orders=20000 runs=1 best=4341.8 ms checksum=5c1322b035d743e3
== session-claude-code-20260919-040924-fork-4cb82464
 1 file changed, 91 insertions(+), 55 deletions(-)
15 passed in 0.02s
orders=20000 runs=1 best=40.7 ms checksum=5c1322b035d743e3
== session-claude-code-20260919-040924-fork-8ff88358
 1 file changed, 4 insertions(+), 8 deletions(-)
15 passed in 0.03s
orders=20000 runs=1 best=876.6 ms checksum=5c1322b035d743e3
== session-claude-code-20260919-040924-fork-40922fb4
 2 files changed, 84 insertions(+), 11 deletions(-)
15 passed in 0.23s
orders=20000 runs=1 best=64.9 ms checksum=5c1322b035d743e3
注意第一个块。父级没有 无差异。三个子级修改了代码,而父级完全保持检查点时的状态,这就是“父级保持不变运行”的意思。以下是并排的四个数字:
| 会话 | 策略 | 时间 (20,000 订单) | 加速比 | 差异 | 新依赖 | 测试 | 校验和 |
|---|---|---|---|---|---|---|---|
| 父级 | 无(基准) | 4,341.8 毫秒 | 1倍 | 0 行 | 否 | 15 通过 | 5c1322b035d743e3 |
| Fork A | 单次通过 | 40.7 毫秒 | 约 107倍 | +91 / −55, 1 文件 | 否 | 15 通过 | 5c1322b035d743e3 |
| Fork B | 先进行性能分析,最小差异 | 876.6 毫秒 | 约 5倍 | +4 / −8, 1 文件 | 否 | 15 通过 | 5c1322b035d743e3 |
| Fork C | pandas | 64.9 毫秒 | 约 67倍 | +84 / −11, 2 文件 | pandas | 15 通过 (0.23 秒) | 5c1322b035d743e3 |
哪一个胜出取决于你在优化什么,这就是运行所有三个的目的。如果只有夜间报告才重要,Fork A 是明确的选择:最快,无依赖,单文件。如果你想要现在能够接受的最小可能更改以供今下午审查,并且 5× 的提升已经足够,那么 Fork B 的 12 行差异是应合并的那个,而 Fork A 的方法将成为下一个冲刺的后续工作。Fork C 在这里你大概不会发布:它比 A 慢,增加了依赖,并且其测试套件变慢了八倍,因为导入 pandas 不是免费的。但如果代码库到处都在使用 pandas,那么计算就会改变。
要将胜者从其分支中取出,请从沙箱拉取补丁:
doctl harness-runtime exec session-claude-code-20260919-040924-fork-4cb82464 \
  --workdir /workspace/harness-fork-lab -- git -c safe.directory="*" diff > fork-A.patch
在你自己的克隆分支上应用它,打开拉取请求,然后删除你不再需要的会话。如果你的规范带有 GitHub 授权,你同样可以请求获胜的分支自行推送一个分支。
步骤 8:打破父级,然后回滚
父级仍然停留在检查点。让我们用它来进行第四次实验,那是你会后悔的那种。此提示要求一个将会违反规则的捷径。
Second experiment: install polars into .venv (do not add it to requirements.txt) and rewrite
top_customers and best_selling_skus with polars. Also change TOP_N from 10 to 5 so the report
is shorter. Then run the tests and bench.py and report the results honestly, even if they
are bad.
代理按照指示行事,并如实报告:
   4.8s [tool ] Bash: cd /workspace/harness-fork-lab && .venv/bin/pip install polars -q
  12.8s [done ] ok    1.44.2
  15.3s [tool ] Edit: /workspace/harness-fork-lab/orders/report.py
  ...
  31.5s [done ] FAIL  ....F.........F   2 failed, 13 passed
  38.1s [done ] ok    orders=20000 runs=1 best=3760.6 ms checksum=de84d0fa446c158e
         [agent] Tests: 2 failed, 13 passed. Both failures are due to TOP_N=5 ...
         [agent] Benchmark: 3,760.6 ms — checksum changed from 5c1322b035d743e3 to de84d0fa446c158e
         [agent] Summary of the state left in place: TOP_N = 5 (was 10); top_customers and
                 best_selling_skus use polars; polars 1.44.2 installed in .venv but not in
                 requirements.txt; 2 tests failing, checksum changed
在代理外部确认损坏:
doctl harness-runtime exec anish-fork-lab --workdir /workspace/harness-fork-lab -- sh -c \
  'git -c safe.directory="*" diff --shortstat; .venv/bin/pip show polars 2>/dev/null | head -1; .venv/bin/python -m pytest -q | tail -1; .venv/bin/python bench.py'
 1 file changed, 25 insertions(+), 21 deletions(-)
Name: polars
2 failed, 13 passed in 0.14s
orders=20000 runs=1 best=3687.3 ms checksum=de84d0fa446c158e
环境中出现意外包,常量被修改,测试变红,校验和不同。传统做法是先执行 git checkout -- .,再运行 pip uninstall polars,并希望没有其他东西被移动。Harness Runtime 的修复只要一条命令:
doctl harness-runtime rollback anish-fork-lab cp_97dafbedc792
在执行此操作前,你需要了解回滚文档提到两点。回滚会永久删除检查点之后会话所做的所有更改,且不会先自动创建检查点——如果你可能想恢复“错误”状态,请先手动保存一个检查点。此外,回滚只能用于从规格或环境配置启动的会话,就像 anish-fork-lab 那样;没有配置的内联会话无法回滚。
  Session  anish-fork-lab
  Agent    Claude Code
  Status   ● ready
  Created  22m ago

Next step
  attach   doctl harness-runtime attach anish-fork-lab
5.8 秒。会话名称相同,会话 ID 相同, Created 22m ago 因为这是同一个会话。 再次运行检查:
polars: not installed
15 passed in 0.03s
orders=20000 runs=1 best=4409.8 ms checksum=5c1322b035d743e3
没有差异,没有 polars,15 个测试通过,原始校验和。机器恢复到 deps-installed-tests-green。它不是一步步“撤销”的;而是用保存的副本替换的。
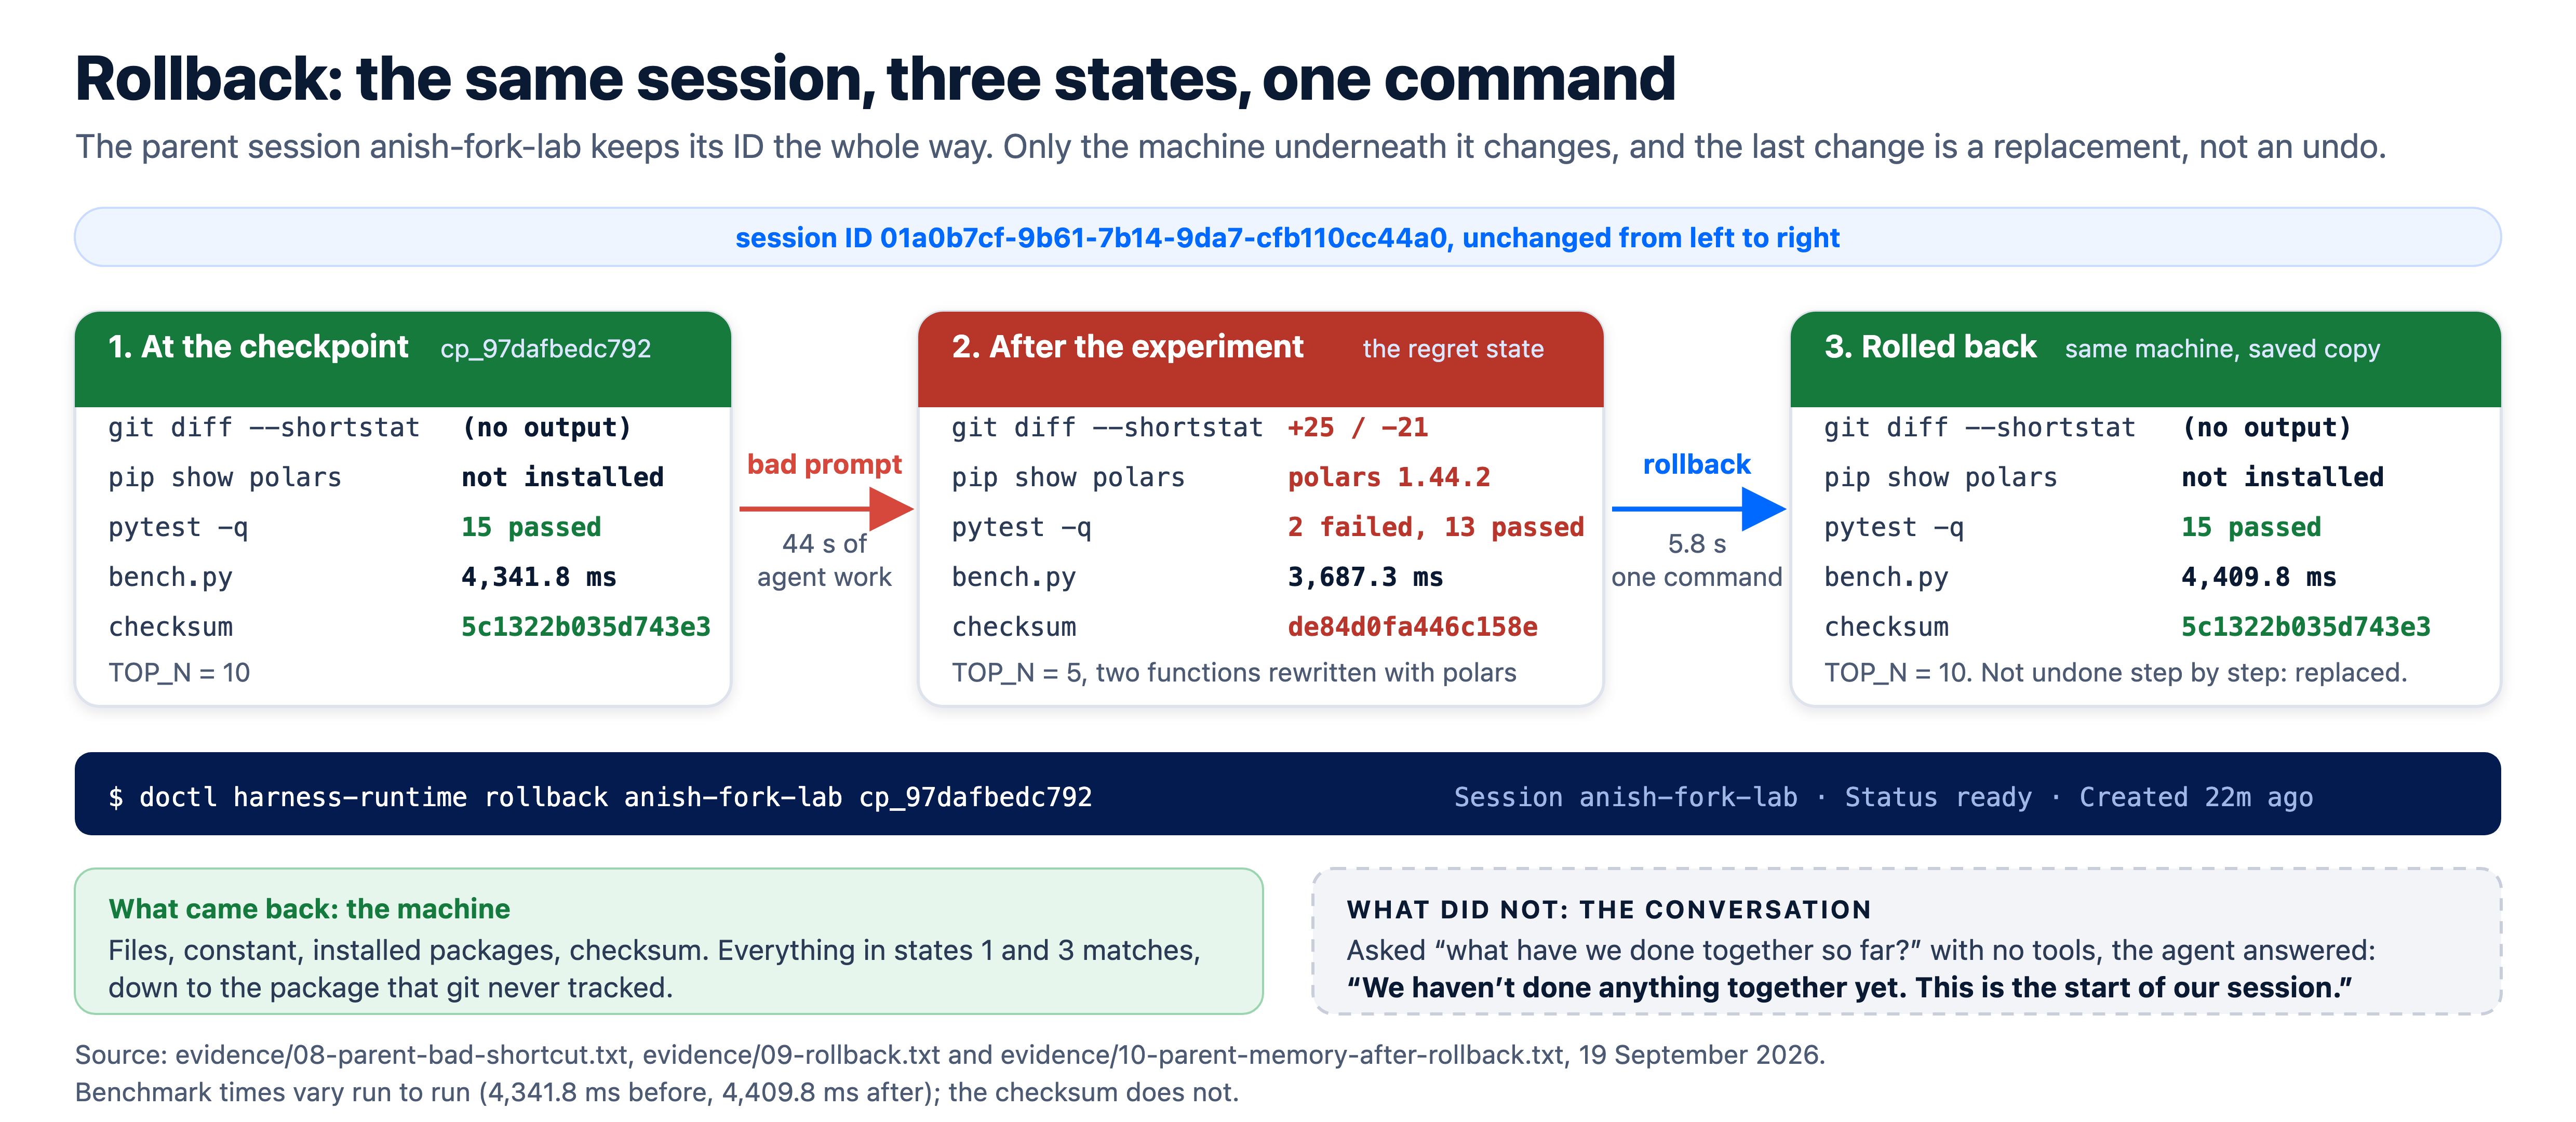
此图所示内容:
- 同一个会话,会话 ID 在整个过程中保持不变,分别在三个时间点:检查点时、一次不良实验之后以及回滚之后。
- 每个时间点都使用相同的五项检查进行测量,所有检查均在我的笔记本上通过
exec运行:git diff --shortstat、polars是否已安装、测试结果、基准时间以及校验和。 - 在检查点时:差异干净,未安装 polars,15 个测试通过,校验和为
5c1322b035d743e3,TOP_N = 10。 - 在不良提示之后(代理工作 44 秒):出现 46 行的差异,有一个不在
requirements.txt中的包,两个测试失败,校验和不同。实验室的每条规则都被打破。 - 执行一次
rollback命令后(5.8 秒):所有检查再次与检查点匹配,包括 git 从未追踪的那个包。 - 这并不意味着:两次基准时间(之前 4,341.8 毫秒,之后 4,409.8 毫秒)只是小型 VM 上正常的运行间波动,并非实际变化。必须匹配的校验和正是这个值,并且它确实匹配。
- 局限在于:机器恢复了,但对话没有恢复。
来源:父会话的 transcript 以及在 doctl harness-runtime exec 前后的检查,于 2026 年 9 月 19 日的第 8 步中复现。
未恢复的内容。 然后我向回滚后的代理提出了一个问题,且未使用任何工具:
Without running any commands: in one line, what have we done together in this session so far?
[agent] We haven't done anything together yet — this is the start of our session.
工作区记住了设置回合;但代理的对话却没有。分支的行为也是如此:每个分支都会开始一个全新的转录,并且你需要分别附加到每个分支。在控制台中,父级的聊天历史记录仍然显示,但回答你下一条消息的代理进程是全新启动的。这就是为什么在第 3 步中,代理被要求写入 BRIEF.md,而在第 6 步中,每个提示都以 “先读取 BRIEF.md” 开头。将你希望在分支或回滚后仍然保留的上下文放置在磁盘上,它就会得以保留;如果留在聊天中,则不会保留。
步骤 9: 清理
分支会占用你团队的并发会话限制(每个团队最多可同时有 100 个会话,具体取决于层级),因此请删除你已经完成使用的分支:
doctl harness-runtime remove session-claude-code-20260919-040924-fork-8ff88358
doctl harness-runtime remove session-claude-code-20260919-040924-fork-40922fb4
保留获胜者,直到其补丁被合并;如果您计划稍后返回,请暂停父项。暂停会在工作区保持不变的情况下停止计算费用;保留的检查点在会话暂停期间仍会继续产生存储费用。
doctl harness-runtime pause anish-fork-lab
这项测试说明了什么,又没说明什么
已验证的部分,证据均可复现:
- 检查点捕获的是沙盒中已安装的软件包和工作区文件,而不只是 git 树。各分支无需自行构建,就有一个可直接使用的
.venv;回滚则移除了智能体此前安装的一个软件包。在默认的 2 vCPU、4 GB 沙盒上,创建检查点耗时 27 秒。 - 相对于环境搭建,分支操作本身很快。一轮耗时 57 秒的搭建完成后,仅用 10.6 秒就派生出三个处于
ready状态的子会话。 - 各分支相互独立,也独立于父会话。三个子会话都在改代码时,父会话没有产生任何 diff;而每个子会话的
git diff --shortstat输出各不相同。 - 回滚能在 5.8 秒内把同一个会话原位还原,且会话 ID 保持不变。文件、常量和已安装的软件包全部恢复原状。
- 三路并行尝试在提示发出后 3 分 07 秒即告完成。整个实验从第一条搭建提示到最后一个分支出结果,共耗时约 4 分 42 秒(搭建 57 秒、检查点 27 秒、分支 11 秒、最慢的分支 187 秒)。同样的三次尝试若改为串行执行、每次都重新搭一遍环境,则大约需要 8 分 19 秒(3 × 57 秒的搭建,加上 49 + 92 + 187 秒的实际工作)。在搭建开销更大的仓库上,关键在于这个比例,而不是绝对的秒数。
未验证的部分,或存在局限之处:
- 至于“live memory”在沙盒暴露的内容之外还涵盖什么,我没有测量。可以确定的是:回滚后的智能体,其对话上下文是全新的——所以不要把工作流设计成依赖聊天记录能在分支后保留。
- 分支共享父会话的 spec、模型和权限策略。我没有测试分支到不同模型或不同智能体的情形;spec 是会话级别的,在创建时设定。
- 84.0 GB 这个检查点体积,是平台为该沙盒上报的数值。本次运行期间我没有看到存储相关的账单条目;定价页面目前将快照和检查点标价为每 GiB·月 0.05 美元。我没有测量一个会话最多能保留多少个检查点。不再需要的检查点,请及时删除。
- 所有耗时数据都来自某一天、某个区域的一个预览环境,且采集时实例规格 slug 尚未从
mv-*改为mars-*。把它们当作一份如实的样本即可,别当作承诺。
何时使用 checkpoint-and-fork,以及何时不使用
| 情形 | 是否使用? | 原因 |
|---|---|---|
| 您希望从同一起点比较两种或多种方法(提示、策略、重构) | 是 | 只需设置一次,基线相同,结果并排展示 |
| 设置成本高昂:容器、种子数据、构建、预热缓存 | 是 | 节省的成本随设置成本而增加;每个检查点只需付费一次,而不是每次尝试都付费 |
| 即将进行有风险的更改:依赖升级、模式迁移、大规模重构 | 是 | 先创建检查点;回滚只需 5.8 秒,且保持会话 ID 不变 |
| 长时间运行的代理会话需要每小时一个已知良好的恢复点 | 是 | 带标签的显式检查点创建和列出的成本很低 |
| 任务只是一次小的编辑,且设置只需几秒 | 否 | fork 命令本身所需的时间大约与设置相当;直接进行编辑即可 |
| 您需要代理在 fork 之后仍能记住对话 | 单独不行 | fork 会开启一个全新的转录。请先将上下文写入文件 |
| 您希望一次性进行超过四次的并行尝试 | 部分 | --count 每次命令的取值范围是 1 到 4;可以运行两次,并注意您的 并行会话限制 |
| 您希望保留可审查的代码更改永久历史 | 否 | 这就是 git。检查点是机器的保存点;提交获胜者的补丁 |
使该模式生效的习惯是:每次设置结束时写入一个文件。例如 BRIEF.md、NOTES.md、baseline.json。这只需代理调用一次 Write,就能把检查点从“只是被设置好的机器”变成“知道为什么被设置的机器”。
关于此主题的常见问题
1. fork 是否会复制代理的对话,还是仅复制文件?
文件、已安装的软件包以及整个沙箱机器。每次 fork 都会开启一个全新的转录记录;在我的测试中,回滚后的代理声称这是会话的开始。把聊天记录视为已消失,磁盘视为已保留。在进行 checkpoint 之前,将 fork 需要知道的任何内容放入一个文件中。
2. 这与 git stash 或每次尝试一个分支有何不同?
Git 会对你的源文件进行版本控制。而 checkpoint 会对整个机器进行版本控制:包括带有已安装软件包的 .venv、仓库外的文件、构建产出以及磁盘上的任何内容。在第 8 步中,回滚删除了代理曾经 pip install 过的一个软件包——这是任何 git 命令都无法完成的。因此,建议同时使用两种方式:对机器进行 checkpoint,对获胜的补丁进行 commit。
3. 84 GB 大小代表什么意思?我需要为它付费吗?
这是平台在默认 2 vCPU、4 GB 的会话上所报告的捕获沙箱镜像的大小。一个小型的 Python 仓库和虚拟环境远远达不到 84 GB,因此这个数字反映的是沙箱本身,而不是你的文件。Harness Runtime 定价页面 对快照和 checkpoint 按每 GiB‑月 0.05 美元计费,而保留的 checkpoint 在会话暂停期间会持续累计费用。我在本次运行中没有看到该费用项,因而无法确定是计费的 84 GB 报告大小还是实际数据量;按报告的大小计算,一个 checkpoint 每月大约需要 4.20 美元。如需删除不再需要的 checkpoint,可使用 doctl harness-runtime checkpoint delete 。
4. 我可以在不先创建 checkpoint 的情况下进行 fork 吗?
可以。使用 doctl harness-runtime fork 且不带 --from-checkpoint 参数时,会先对当前状态进行 checkpoint,然后从该 checkpoint 进行 fork。我使用了一个显式命名的 checkpoint,以便以后能够再次从该 checkpoint 进行 fork,并通过名称回滚到它。
5. fork 能否运行不同的模型或代理?
fork 继承父级的规格(在所有三个子进程中 config_id 完全相同),因此它们运行相同的代理和模型。你可以为每个 fork 控制的变量是提示词。若要从同一起点比较不同模型,先 fork,然后用指示其执行何种操作的提示词驱动每个子进程;若要比较不同代理类型,则分别启动独立的父进程。
6. Is there a limit on how many forks I can run?
--count 每个命令接受 1 到 4 的值,每个 fork 都会计入您团队的 并发会话限制,根据您的套餐,每团队最多可同时运行 100 个会话。删除您已完成的 fork;获胜者的价值在于其补丁,而非正在运行的会话。
7. Which agents support this?
文档列出了在 Codex CLI、OpenCode 和 Claude Code 适配器上支持 fork 的情况。本文使用了托管在 DigitalOcean 上的模型的 Claude Code。Harness Runtime 还运行 LangGraph 和 Hermes 代理以及自定义沙盒模板;请参阅 Harness Runtime 示例 了解这些内容,并在围绕它们规划实验之前,先查看其中的 fork 注意事项。
8. 回滚后,父级的控制台聊天仍然显示旧的回合。这是个 bug 吗?
控制台显示会话的事件历史记录,即日志。回滚替换了机器并重置了代理的工作上下文;它并未重写日志。将历史记录理解为“此会话 ID 随时间的变化情况”,将沙盒理解为机器当前状态的真实情况。
结论
Checkpoint-and-fork 将“尝试另一种方法”从重建转变为一条命令。在本实验中,一次 57 秒的设置步骤在 10.6 秒内生成了三个可直接工作的沙箱;三种不同的优化策略从字节相同的基线并行运行,分别返回了 40.7 毫秒、876.6 毫秒和 64.9 毫秒,而基线为 4,341.8 毫秒;所有结果具有相同的校验和以及相同的 15 项通过的测试;并且一个故意损坏的父进程在您询问后 5.8 秒恢复到了其保存点。使该模式可靠的唯一习惯是在进行检查点之前,将您的设置发现写入文件,因为机器在 fork 后会存活,而对话不会。
示例仓库位于 github.com/anishsingh20/harness-fork-lab。完整的 agents.yaml 在步骤 1 中打印,并且本文中的每个数字都来自 doctl 输出,您可以使用相同的命令重现。DigitalOcean Managed Agents 处于 公开预览,面向所有用户,因此您今天可以在自己的团队中运行此实验:从 Harness Runtime 快速入门 开始,然后按照 检查点、fork 和 回滚操作指南 使用您自己的仓库。
来源
- 使用 DigitalOcean Action Gateway 将 AI Agent 连接到 SaaS 工具而不共享您的凭据
- 代理永不看到密钥:在 DigitalOcean Action Gateway 中证明凭据代理
- DigitalOcean Managed Agents 产品文档(公开预览)



