介绍
考虑一个代理调用工具来提交支持工单。模型提供方返回 503,重试循环故障转移到备用提供方。备用方收到相同的请求并再次调用同一工具,因为没有任何信息告诉它第一次尝试可能仍在运行。结果是产生两张工单,或两次退款。代理工具的问题解释了为什么容易触发重复写入。
这种情况具有示例性,但其背后的建议是标准的:使用退避重试,然后故障转移到另一个提供方。该建议是为那些廉价、快速且可安全重复的请求而写的,例如数据库查询。推理请求不具备这些特性。它可能运行一分钟,按 token 计费,并且在任何人知道它是否会完成之前就开始流式输出。
当该重试逻辑遇到推理请求时,会出现两个问题:
- 负载会倍增。 每次重试都会再次发送完整的提示,并且应用、SDK 和网关层的重试会相互叠加。当提供方是慢而非不可用时,这些重试会叠加到仍在运行的工作上。
- 故障转移流量会落在同一位置。 那些基于相同信号(如公开价格和最近的故障)选择备份的应用,在某个提供方降级时都会转向同一少数几个备选方案。
为了衡量这一点的重要性,我在 DigitalOcean H200 GPU Droplet 上构建了一个故障注入装置并运行了六小时。它在六种故障场景下比较了三种重试策略:天真的、带退避的以及具备重试预算和断路器的纪律性策略。
本文内容包括:
- 重试如何导致推理时的负载和 token 成本倍增
- 该装置测量了什么
- 故障转移适得其反的四种方式
- 哪些错误应触发故障转移
- DigitalOcean 处理的内容以及应用中保留的内容
本文基于两篇配套文章。路由论文 讨论是否应该构建跨提供方故障转移。锁定问题文章 解释了为什么重试行为在不同提供方之间会有差异。本文聚焦于故障实际发生时的那几分钟。
TL;DR
- 在六种故障场景中,天真的重试和带退避的重试都导致后端负载倍增,平均分别为正常负载的 2.13 倍和 3.54 倍。
- 我的纪律性策略(重试预算加断路器)使平均负载控制在 1.02 倍,接近正常。
为什么重试在推理中代价更高
对数据库调用安全的重试,在推理调用中可能不安全。数据库重试成本低且速度快,第二次尝试不会在意第一次是否发生。推理调用可能运行一分钟,按 token 计费,并且在完成前就会流式输出结果,因此每次重试都会产生实际成本。
重试还会叠加:你的应用会重试,其下方的 SDK 也会重试,而位于两者前面的网关也可能进行重试。每一层都在解决自己的问题,而不会检查下层已经尝试了什么。
| 层 | 每次调用的尝试次数 |
|---|---|
| SDK(OpenAI 和 Anthropic 的 Python SDK 默认均会重试两次) | 3 |
| 你的应用(例如重试三次) | 4 |
| 单个用户请求的后端总尝试次数 | 12 |
下面是该扇出的示意图:一次请求,四次应用尝试,每次应用尝试内部包含三次 SDK 尝试。
flowchart LR
    U[1 user request] --> A1[App try 1] --> S1[3 SDK attempts]
    U --> A2[App try 2] --> S2[3 SDK attempts]
    U --> A3[App try 3] --> S3[3 SDK attempts]
    U --> A4[App try 4] --> S4[3 SDK attempts]
那是在网关甚至介入之前就已经发生的 12 次后端尝试。添加一个在相同错误上进行重试的网关,总数又会增加。选择一层来负责重试,让其他层直接把失败透传过去,而不是再重试一次。
这已经在规模上发生过。OpenAI 关于其 2026 年 2 月故障的事后报告描述了客户端重试如何将流量放大成反馈回路,导致某地区恢复变慢。断路器是修复方案的一部分。
重试的 Token 成本
每次重试都会重新发送完整的提示词。除非 提示词缓存 命中,否则提供方会再次处理该提示词。您也需要再次付费。
我在慢速故障场景中进行了测量。与理想情况相比,Naive 策略的成功响应多消耗了 87% 的 Token;Disciplined 策略则多消耗了 15%。Naive 多出的约三分之二来源于每次重试都会重新发送并处理提示词;剩余部分是客户已经放弃后,提供方仍继续生成的输出。
我检查的三家提供方(OpenAI、Anthropic、Google)均未说明取消流是否会停止生成和计费。如果您的重试放弃了请求,您将产生自身仪表盘无法显示的费用。
The DeepSeek 缓存可靠性文章表明,在 DeepSeek-V4.1-Flash 上,缓存未命中的价格是缓存命中的 50 倍。当重试导致故障转移到其他提供方时,会以冷缓存启动,因而需要再次支付完整的提示词价格。
我测量的内容
我针对三种重试策略(naive、backoff 以及我自己的 disciplined 策略)运行了六种故障场景。DigitalOcean H200 GPU Droplet 为我提供了一台机器,可在不影响他人工作负载的情况下运行全部 18 种组合。整个测试耗时六小时十九分钟。
- Naive: 最多 3 次重试,无延迟,在主备之间交替。
- Backoff: 在主上最多 3 次重试,采用指数退避,随后进行一次故障转移。
- Disciplined: 我的策略。它使用错误策略、一个使重试次数保持在请求总数 10% 以下的重试预算、每个提供方的断路器,仅在断路器打开时才进行故障转移。
两个模拟提供者替代了真实提供者,这样我就能精确控制故障何时开始。第二群体——次要系统自身的用户——从未在任何地方发生故障转移。他们的提供者状况良好,但也承担了故障转移流量。
下表列出了所有场景和策略。后端负载指每个用户请求的服务器尝试次数,其中 1.0x 表示没有额外负载。后端负载和成功率均在故障窗口内进行测量。
| 场景 | 策略 | 每用户请求的后端负载 | 故障期间成功率 | 故障后恢复正常的延迟? |
|---|---|---|---|---|
慢速故障(brownout) |
简单 | 1.96x | 100% | 否 |
慢速故障(brownout) |
退避 | 3.83x | 100% | 否 |
慢速故障(brownout) |
有纪律 | 1.01x | 77.3% | 是,0秒内 |
完全故障(blackout) |
简单 | 2.00x | 100% | 是,0秒内 |
完全故障(blackout) |
退避 | 3.99x | 100% | 是,0秒内 |
完全故障(blackout) |
有纪律 | 0.97x | 91.0% | 是,0秒内 |
速率限制(ratelimit) |
简单 | 1.53x | 100% | 是,0秒内 |
速率限制(ratelimit) |
退避 | 2.92x | 100% | 是,0秒内 |
速率限制(ratelimit) |
有纪律 | 1.11x | 47.8% | 是,0秒内 |
缓慢但存活(trickle) |
简单 | 1.98x | 100% | 否 |
缓慢但存活(trickle) |
退避 | 3.89x | 100% | 否 |
缓慢但存活(trickle) |
有纪律 | 0.99x | 89.7% | 是,0秒内 |
分层重试(brownout_layered) |
简单 | 3.83x | 100% | 否 |
分层重试(brownout_layered) |
退避 | 3.83x | 100% | 否 |
分层重试(brownout_layered) |
有纪律 | 1.01x | 77.4% | 是,0秒内 |
可取消感知(brownout_cancel) |
简单 | 1.48x | 100% | 是,0秒内 |
可取消感知(brownout_cancel) |
退避 | 2.81x | 100% | 是,30秒内 |
可取消感知(brownout_cancel) |
有纪律 | 1.00x | 85.7% | 是,0秒内 |
在每个“否”行中,请求一直成功;在六分钟的观察窗口内,延迟始终没有恢复。一个结果尤为突出:通常推荐的退避策略在六种场景中的五种实际上给后端带来的负载比天真策略更大。它在故障转移前一直向慢速主节点重试了三次。
下面的图表展示了慢速故障和速率限制测试的运行情况。
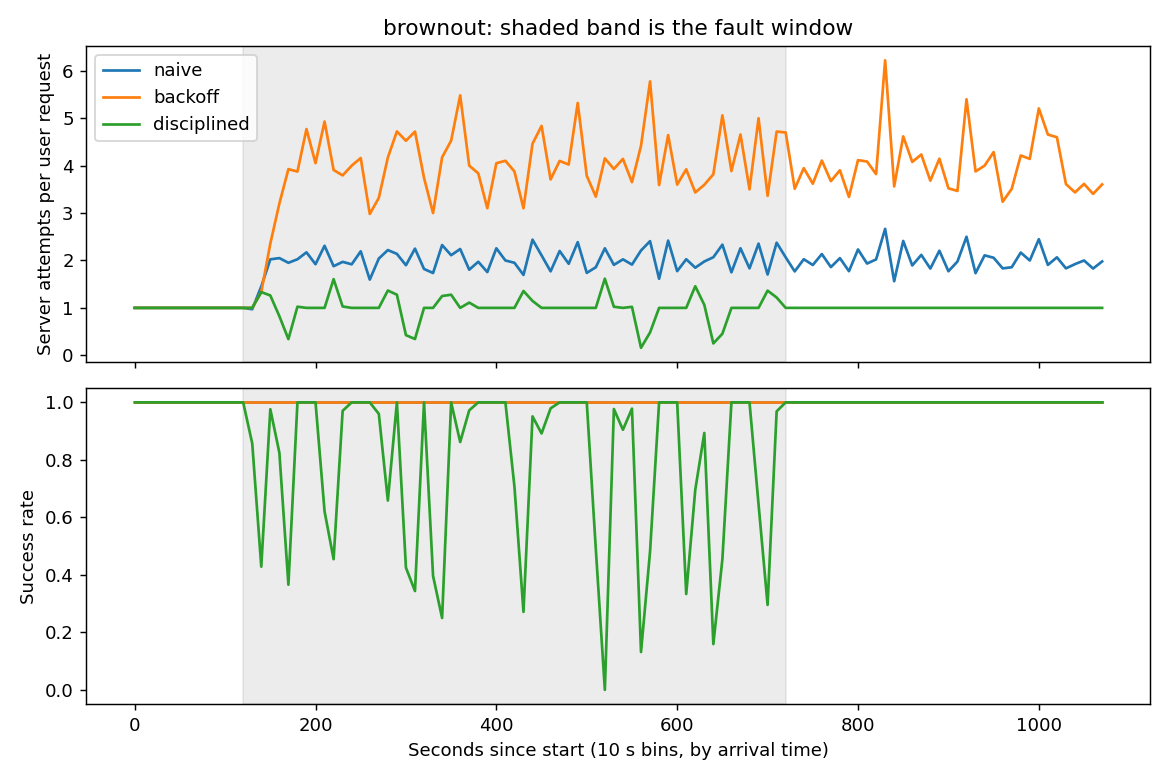
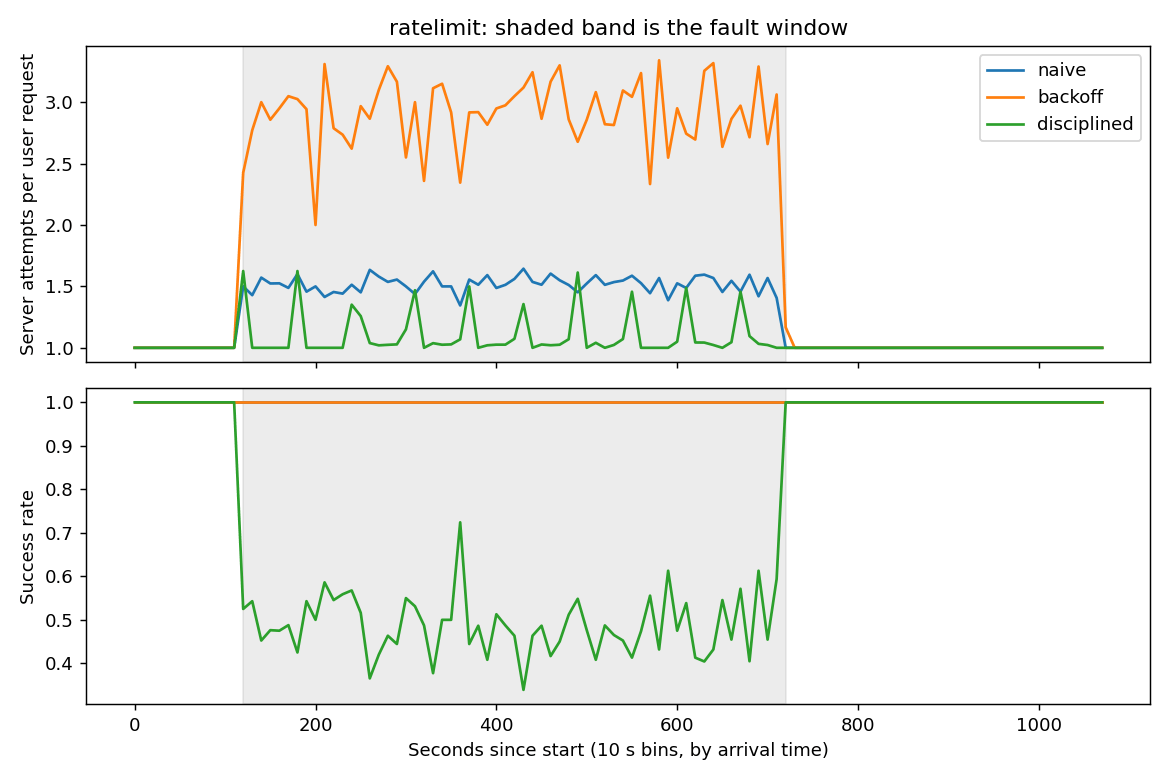
慢速故障可能在错误出现之前就表现为尾部延迟升高。p50 与 p99 延迟文章 解释了这一差距在 LLM 工作负载中如何形成。导致负载较高的提供方在不可用之前先变慢的调度原因在 为什么您的 vLLM p99 延迟会在生产环境中飙升 中有所说明。
在所有六种场景中, disciplined 负载削减策略都成功降低了负载并恢复了服务,且其故障期间的成功率始终低于天真策略。
What This Rig Did Not Test
- 提供方是模拟的。该 rig 测量客户端策略的行为,而非真实 GPU 后端的过载情况。
- 只有某一群体发生了故障转移。未测试众多租户同时故障转移到同一备份的情况。
- 未运行的三种设计包括:对请求中首个 token 时间作出反应的断路器、在持续速率限制下进行预算化的溢出到备份,以及 hedged 请求。
- 我的断路器仅从已完成的尝试中学习。在完整的 brownout 运行中,它在故障发生后 27 秒才打开。
除此之外,原始日志、确切的故障参数以及用于重现这里所有数字的代码均位于 证据仓库 中。
Four Ways Failover Backfires
1. Everyone’s Backup Is the Same Backup
一个多提供方网关记录了一种默认策略,即将流量加权向最健康且最便宜的提供方倾斜。这一默认策略本身是合理的。问题在于当其他所有应用同时采取相同行为时就会显现出来,因为大家都在读取同一套公开价格。
当某个提供方出现波动时,所有监控该信号的应用都会将流量重新路由到同一小组廉价替代方案。一种关闭该加权并将所有流量固定到单一最廉价选项的路由模式,会消除分散这种风险的唯一手段。
2. 网关自身可能成为故障点
如果网关宕机,所有经过它的应用都会随之宕机,不管其后面有多少模型提供商。
某网关的文档指出,多家提供商的综合可用时间优于直接依赖单一提供商,这一点是合理的。这也意味着网关又增加了一个需要考虑的故障域。
3. 某些错误在各处表现相同
如果请求超过模型的上下文窗口长度,对下一个提供商的相同模型而言也会太长;若请求因内容审核而失败,则会再次失败。在这类错误上进行故障转移不仅无法恢复,只会多一次同样会失败的调用。
解决办法是一条简短规则:仅在健康的不同提供商可能以不同方式处理的错误上进行故障转移。
4. 客户离开后工作仍在运行
当客户放弃并进行故障转移时,被遗弃的请求在原始提供商那里是否真的会停止?不一定。某网关的文档列出了在取消流时不会停止生成的提供商。此时,提供商会继续占用容量来生成客户永远不会收到的响应。
我测试了这两种情况。当故障提供商在断开后仍继续生成时,naive 策略在整个测试过程中留下了 3,743 个这样的僵尸请求。这些请求在客户断开后共生成了 959,232 个输出 token。当我将同一个模拟提供商配置为尊重取消时,浪费的输出降至 1,472 个 token,大约减少了 650 倍,而 naive 的策略完全未变。次要提供商的用户也感受到了这种差异。启用取消后,他们的成功率恢复到 100%。
我检查的三个模型提供商均未公布取消流是否会停止计量。在您了解自己提供商的情况之前,请假设它不会停止。
哪些错误应触发故障转移
不是所有故障都需要相同的处理方式。DigitalOcean 的无服务器推理深度解析 已经在服务器端将故障划分为不同类别。这里有一个它不需要自己回答的问题:您的应用何时应该真的切换到其他提供商?
| 错误 | 表现为 | 是否重试同一提供商? | 是否故障转移? |
|---|---|---|---|
| 损坏的请求 | 除 429 外的 4xx、错误的 schema、过长 | 永不 | 永不,到处都是同样的错误 |
| 内容策略拒绝 | 未生成输出 | 永不 | 永不,看起来像在规避策略 |
| 速率限制 | 带有重置头的 429 | 是的,等待后 | 不是按请求;这是您的账户问题,而非提供商健康状况 |
| 提供商过载 | 529 或类似,与 429 区分 | 是的,在预算内 | 仅在您的断路器打开后 |
| 服务器故障 | 5xx,连接重置 | 是的,在预算内 | 仅在您的断路器打开后 |
| 流中断 | 部分输出,然后断开 | 取决于提供商 | 仅凭此本身不足 |
在重试前等待重置头,遵循 DigitalOcean 自身的 429 指南(针对无服务器推理),并且在速率限制情况下绝不要按请求进行故障转移。您所在层级的每分钟请求上限,已在 DigitalOcean 的推理限制 中公布,这正是 429 所要告诉您的内容。
Anthropic 在 529 过载响应和 429 速率限制之间划清了界限。速率限制与您的账户相关,且永不应触发断路器。
在速率限制场景下,我严格执行的策略成功率降至 47.8%。按设计,它在遇到 429 时永不进行故障转移。看到这个数字促使我重新制定了这条规则。速率限制永不应打开断路器或在每个请求上触发故障转移。当限制持续存在时,通过重试预算将溢出流量转移到次要提供商是一个值得测试的设计。我在此未进行测试。
DigitalOcean 处理的内容及您仍需自行负责的内容
这不需要切换提供商。托管层已经为你做了以下事情,而以下内容仍然存在于你的应用中。
| 关注点 | DigitalOcean 处理的内容 | 你仍然负责的内容 |
|---|---|---|
| 速率限制 | 无服务器推理 返回带有重置头的 429,并提供 有文档的退避建议 | 遵循重置头,并且在收到 429 时永不按请求进行故障转移 |
| 重试量 | 推理路由器的 网关层 会为其路由的模型重试失败的调用 | 重试预算:将重试次数限制为请求的比例,而不是固定次数,这一想法来源于 Google 的 SRE 书籍。让一层负责重试,使得路由器、SDK 和你的应用不会相互乘倍 |
| 故障转移 | 推理路由器 会故障转移到备用模型,每个路由器任务最多 3 个模型 | 一个错误策略,决定哪些失败甚至被允许进行故障转移 |
| 丢失的流 | 丢失的流会返回部分响应,并附带重新发起完整请求的指导 | 将每个流的重试计入相同的重试预算 |
| 响应缓慢 | 没有文档化的托管超时策略 | 对首个 token 时间和总时长进行超时设置,而不仅仅是 SDK 默认值 |
| 降级模式 | 专用推理 可以在你控制的硬件上托管更小的备用模型 | 在你花费第二个提供商的容量之前,决定何时降级到更小的模型、更短的回答或使用缓存的回复 |
推理路由器为其路由的模型处理重试和熔断。它不会设置你的错误策略,不知道你的重试预算,也无法解决跨提供商的重试风暴,因为这需要只有你的应用才具备的上下文。
关于该主题的常见问题?
1. 在中断期间,LLM 提供商故障转移的最佳实践是什么?
首先对错误进行分类。损坏的请求或内容政策拒绝永不应触发故障转移,因为问题在于请求本身。仅在提供商过载或服务器故障的情况下保留故障转移,并且仅在断路器实际上已经打开之后才进行,而不是对每次失败的调用都进行故障转移。
2. 推理的重试逻辑应如何不同于通用 API 重试逻辑?
推理调用耗时长、按 token 计费且会流式输出部分结果,因此固定重试次数是错误的控制方式。应改用重试预算:即重试次数与请求次数的比率,这样一分钟的故障也无法消耗无限的重试。
3. 如何避免跨 LLM API 的级联故障?
结合使用三种控制措施。错误策略限制哪些错误甚至允许故障转移。重试预算和断路器共同限制策略可以产生的流量上限。降级模式梯队可以在不将负载发送到其他提供商的情况下吸收流量。
4. 您应该重试来自 LLM 提供者的 429 速率限制响应吗?
等待重置头部,然后在同一提供者上重试。不要按请求进行故障转移。速率限制是关于您账户的配额信号,而不是关于提供者健康状况的信号,因此它永不应触发断路器。
5. DigitalOcean 的推理路由器是否解决了这里描述的重试风暴问题?
不。它仅对其路由的模型处理重试和断路器。错误策略、重试预算、降级模式梯队以及跨提供商故障转移的取消处理仍然是您应用程序的责任。
结论
天真的故障转移将推理调用视为无状态的 API 请求:先重试,然后尝试其他地方。这一假设在调用运行时间长、按 token 计费并流式输出部分结果的瞬间就会崩溃。对快速 API 调用无害的相同重试,会在仅仅缓慢的提供商上放大负载。
在故障转移前,先对错误分类,并用预算上限代替固定次数的重试。为负载提供一个出口——比如更小的模型或缓存的答案——再让它落到另一家提供商的容量上。随后检查账单,比较生成的 token 与实际交付的 token,因为这能说明该策略是否真的降低了浪费。
本文属于更大系列的一部分。路由论文 决定跨提供商故障转移是否应纳入您的架构。锁定论文 解释此处重试逻辑为何是特定于提供商的,而不可移植。突发流量论文 讨论何时为预留 GPU 容量付费是值得的,而 量化的实际权衡 说明使用量化后备模型会在精度上付出什么代价。
参考文献
- OpenAI Python SDK、README 和参考文档. OpenAI 在 GitHub 上。
- 2026 年 2 月 3 日事件报告. OpenAI 状态页面。
- Python SDK. Anthropic 的 Claude API 文档。
- 错误. Anthropic 的 Claude API 文档。
- 应对级联故障. Google 的《站点可靠性工程》书籍。
- DigitalOcean 无服务器推理:深度解析. DigitalOcean 博客。
- 对于服务器无服务推理的 429 响应,我应该遵循什么重试或退避行为? DigitalOcean 文档。
- 推理限制. DigitalOcean 文档。
- 如何使用无服务器推理. DigitalOcean 文档。
- 如何使用专用推理. DigitalOcean 文档。
- 我们如何构建 DigitalOcean 推理路由器. DigitalOcean 博客。
- 使用推理路由器的多模型 API 成本治理. DigitalOcean 社区。
- 多模型路由是基础设施决策,而非功能. DigitalOcean 社区。
- 推理提供商锁定在生产环境中的实际表现. DigitalOcean 社区。
- p50 与 p99 延迟:为什么中位数基准会误导 AI 代理工作负载. DigitalOcean 社区。
- 为什么您的 vLLM P99 延迟在生产环境中激增,以及分块预填充和调度如何修复它. DigitalOcean 社区。
- 提示缓存如何工作以及何时实际上会降低 LLM 成本? DigitalOcean 社区。
- 为什么突发的推理流量会打破专用 GPU 的计算. DigitalOcean 社区。
- 量化的真实权衡:FP16、INT8 和 GGUF 在生产环境中按模型大小实际分歧的位置. DigitalOcean 社区。
- 代理工具的问题以及 DigitalOcean 的 Action Gateway 如何解决它们. DigitalOcean 社区。
- 缓存可靠性是一个定价术语:我在 DigitalOcean 无服务器推理上测量 DeepSeek-V4.1-Flash 时学到的. DigitalOcean 社区。
- GPU Droplets. DigitalOcean 产品页面。
- 故障注入工具、原始运行日志和结果. GitHub。



