知识传承历来有各种形式。在美索不达米亚(今伊拉克)发明文字之前,法律、历史、神话、歌谣等信息全靠口口相传,代代延续。传承方式要么是口述指导,要么是讲故事——尤其是民间传说和历代流传下来的事件。
但另一种常见的知识传承方式是师徒相授,无论正式与否。历史上这样的例子比比皆是:《圣经》记载耶稣有十二门徒,从传道之初直到受难,他每天都亲自教导他们。苏格拉底教出了柏拉图;柏拉图在雅典创办学院,花了二十年教导亚里士多德;而亚里士多德则彻底改变了科学、逻辑学和政治学。这样的例子不胜枚举。
到了21世纪,深度学习领域的师承关系就是这类传承的延续。20世纪AI寒冬期间,神经网络上被视为死路一条,正是这条师生传承的脉络让这个梦想得以延续。
Geoffrey Hinton 被誉为AI之父,他主持的实验室培养出了 Yann LeCun、Ilya Sutskever 等人。Yann LeCun 后来发明了卷积神经网络(CNN),Ilya Sutskever 则参与联合创立了 OpenAI,之后又转投 Safe Superintelligence Inc.。
人与人之间的知识传承我们都很熟悉,那机器与机器之间的知识传承呢?这就是所谓的“模型蒸馏”。
本文将深入剖析模型蒸馏的概念,介绍它所用的各种技术,并手把手带你用 PyTorch 从零实现。
读完本文,你将学会如何训练更小、更高效的模型,也能了解蒸馏与量化、剪枝等其他压缩技术相比有何优劣。
本文内容
前置知识
要跟着本文动手实践,你需要具备以下条件:
GitHub 仓库:项目的完整实现已放在 这里,建议先克隆下来再跟着操作。
对 Python 和面向对象编程有基本了解(比如用过类)。
了解深度学习基础概念,例如轮次(epoch)、前向传播、损失函数等。
PyTorch 基础:虽然我会逐段讲解代码,但如果你熟悉 PyTorch 的张量操作和训练循环,学起来会更轻松。
开发环境:本地需安装 Python。我用的是 Visual Studio Code,你用任何顺手的编辑器或 IDE 都可以。
硬件:本项目使用的数据集较小,普通 CPU 就足够了。
什么是模型蒸馏?
模型蒸馏(Model Distillation,也称知识蒸馏)的目标,是把一个大而准的模型学到的行为,迁移到更小、计算开销更低的模型上,让后者更适合实际部署。
蒸馏是一种模型压缩技术:较小的模型(称为学生模型)通过学习来模仿更大、更复杂模型(教师模型)的输出。目标是让学生模型在参数量大幅减少的情况下,达到接近教师模型的性能,从而更高效地部署。(来源)
为什么需要模型蒸馏?
截至本文撰写时,无论闭源还是开源模型,参数量都已达万亿级别。参数是模型从训练数据中自动学习到的内部配置变量,数量如此庞大,意味着没有充足资金根本跑不起模型——它既耗电,又依赖昂贵的硬件。
借助蒸馏,我们可以把这些前沿模型学到的东西迁移到更小、更高效的模型上,让模型更易用、成本更低。
模型蒸馏技术
具体采用哪种蒸馏技术,取决于要传递的是什么知识。有些方法只传递最终的预测结果,另一些则传递内部表示、注意力图、推理步骤,甚至教师模型的完整行为。
下面是几种常见的技术:
基于响应的蒸馏
这类方法最早由 Geoffrey Hinton 在论文 Distilling the knowledge in a neural network 中提出,是最经典的师生蒸馏方式。在深入讲解它的工作原理之前,你需要先了解两个模型训练中的概念:硬标签和软标签。
硬标签只处理固定的类别目标。比如给模型看一张狗的图片,让它判断这是狗、猫还是马,模型会给出狗(1)、马(0)、猫(0)这样的结果。至于这张图有多少比例像猫、哪些特征像马,硬标签一概不涉及。
而软标签则处理概率。同一张图片用软标签输入模型时,模型可以给出这样的预测:0.85 的概率是狗,0.10 的概率是猫,0.05 的概率是马。
在基于响应的蒸馏中,学生模型不是用硬标签来训练,而是同时学习教师模型输出的概率分布(即软标签)。学生模型不仅知道这张图是狗,还知道它有点像猫,只是几乎不像马。
这类附加信息被称为“暗知识”。它让小模型能够复制更大、更准确的教师模型的行为,同时保持高性能。
基于响应的蒸馏有几个优点:实现简单、非常稳定,在图像分类任务上表现出色。但它也有缺点,最主要的是忽略了网络内部发生了什么。
也就是说,这种蒸馏只关注输出层(即概率),学生与教师模型之间是一种“黑盒”关系:学生学到的是教师做出了什么决定,却不知道教师是如何得出这个结论的。回到前面的例子,学生学到了图片是狗、猫、马的概率,却不了解得出这一结论背后的原理和机制。
基于特征的蒸馏
这种技术传递的是大模型的内部特征表示,而不只是最终输出。
打个比方,你跟着一位数学名师学习。老师给你出了一道题,然后直接展示最终答案。你也许最后能猜对公式,但学到的多半只是死记硬背。
可如果老师要求你翻开他的笔记本,看看解题的每一步,你学到的就是老师完整的思考过程。
基于特征的蒸馏就是这样:训练时,学生模型必须让隐藏层的激活值与老师模型对齐,并采用均方误差(MSE)来衡量。这样一来,学生模型不只在猜对最终输出时获得奖励,只要其内部函数体系与老师模型不一致,同样会被扣分。
这种方法在卷积神经网络、视觉Transformer、目标检测等领域应用广泛。
它的缺点在于:每次训练迭代都要提取并保存老师模型的内部特征图,内存和功耗会迅速飙升,运行成本非常高。
注意力蒸馏
这种方式下,学生模型并不复制全部神经元,而是观察大模型把注意力放在哪里,然后只复制那些神经元。
Transformer 模型致力于理解整句话的含义,而非关注单个词语。在这类模型中,注意力图能表明模型做预测时认为哪些输入 token 或区域最重要。学生模型的任务就是复现老师模型的这些注意力图或其分布——相当于告诉学生:解题时该“看”哪里。
注意力蒸馏的缺点是训练时间和硬件资源的开销都相当大。因为需要计算均方误差(MSE)和 KL 散度(Kullback-Leibler divergence)等指标,它们作为损失函数,能精确告诉模型自己的预测或内部表示与老师模型相差多少。而要在海量的注意力张量上完成这些计算,资源消耗自然水涨船高。
自蒸馏
模型也能训练自己,具体做法是把知识从较早的版本迁移到较新的版本,也可以在网络内部不同层之间传递知识。
这样做的好处是,模型不必增大体积就能变得更强,省去了用更大的模型来训练学生模型的成本。
如何在 PyTorch 中实现知识蒸馏
为了实时展示模型蒸馏的原理,我们将用 PyTorch 和MNIST 数据集分类器,先训练教师模型,再训练学生模型。
该数据集包含约 70,000 张手写数字的灰度图像。我们先训练教师模型,然后将其冻结,再利用硬标签和教师模型输出的软目标来训练学生模型。
需要注意的是,MNIST 数据集规模较小,蒸馏带来的收益可能有限。但这个项目完整演示了蒸馏工作流,能为你日后处理更大数据集打下基础。
运行本项目需要安装以下 Python 包:
| 包 | 用途 |
|---|---|
torch |
核心深度学习框架,用于构建和训练神经网络。 |
torchvision |
提供 MNIST 等数据集和图像处理工具。 |
numpy |
数值计算与数组运算。 |
matplotlib |
绘制图表,可视化图像和结果。 |
tqdm |
在训练过程中显示进度条。 |
本项目使用 Visual Studio Code 编辑器,你也可以选择其他任意代码编辑器。
下面是项目结构,我会在讲解代码时逐一介绍各个文件夹和文件。
knowledge-distillation/
│
├── data/
│
├── models.py
│
├── engine.py
│
├── losses.py
│
├── train_teacher.py
│
├── train_student.py
│
├── train_distilled_student.py
│
├── evaluate.py
│
├── visualize.py
│
├── utils.py
│
├── plots.py
│
├── requirements.txt
│
└── README.md
目录结构中首先是data文件夹,里面存放着MNIST数据集。
models.py文件定义了项目中所有神经网络的架构,包含教师网络类和学生网络类。每个类都定义了网络层、前向传播,以及数据在网络中的流动方式。
import torch
import torch.nn as nn
import torch.nn.functional as F

class TeacherNet(nn.Module):

    def __init__(self):
        super().__init__()

        self.flatten = nn.Flatten()

        self.fc1 = nn.Linear(28 * 28, 1024)
        self.fc2 = nn.Linear(1024, 512)
        self.fc3 = nn.Linear(512, 256)
        self.fc4 = nn.Linear(256, 128)
        self.fc5 = nn.Linear(128, 10)

    def forward(self, x):

        x = self.flatten(x)

        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = F.relu(self.fc3(x))
        x = F.relu(self.fc4(x))

        logits = self.fc5(x)

        return logits


class StudentNet(nn.Module):
    """
    Smaller neural network (Student)
    """

    def __init__(self):
        super().__init__()

        self.flatten = nn.Flatten()

        self.fc1 = nn.Linear(28 * 28, 128)
        self.fc2 = nn.Linear(128, 10)

    def forward(self, x):

        x = self.flatten(x)

        x = F.relu(self.fc1(x))

        logits = self.fc2(x)

        return logits
utils.py文件负责准备数据集,回答“数据集从哪儿来”这个问题。我们会在这里下载MNIST数据集、对图像做归一化,并创建训练和测试的数据加载器。
from torchvision import datasets, transforms
from torch.utils.data import DataLoader


def get_dataloaders(batch_size=64):
    """
    Downloads MNIST (if needed) and returns
    training and testing DataLoaders.
    """

    transform = transforms.ToTensor()

    train_dataset = datasets.MNIST(
        root="data",
        train=True,
        download=True,
        transform=transform
    )

    test_dataset = datasets.MNIST(
        root="data",
        train=False,
        download=True,
        transform=transform
    )

    train_loader = DataLoader(
        train_dataset,
        batch_size=batch_size,
        shuffle=True
    )

    test_loader = DataLoader(
        test_dataset,
        batch_size=batch_size,
        shuffle=False
    )

    return train_loader, test_loader
engine.py文件包含可复用的学习算法,负责控制训练过程。它接收model.py的代码并对其进行训练。
import torch
from tqdm import tqdm


def train_one_epoch(
    model,
    dataloader,
    criterion,
    optimizer,
    device,
):
    model.train()

    running_loss = 0

    progress = tqdm(dataloader)

    for images, labels in progress:

        images = images.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        outputs = model(images)

        loss = criterion(outputs, labels)

        loss.backward()

        optimizer.step()

        running_loss += loss.item()

        progress.set_description(
            f"Loss {loss.item():.4f}"
        )

    return running_loss / len(dataloader)


def evaluate(model, dataloader, device):

    model.eval()

    correct = 0
    total = 0

    with torch.no_grad():

        for images, labels in dataloader:

            images = images.to(device)
            labels = labels.to(device)

            outputs = model(images)

            _, predicted = torch.max(outputs, dim=1)

            total += labels.size(0)

            correct += (predicted == labels).sum().item()

    accuracy = 100 * correct / total

    return accuracy


def predict(model, images, device):

    model.eval()

    with torch.no_grad():

        images = images.to(device)

        outputs = model(images)

        _, predictions = torch.max(outputs, dim=1)

    return predictions

def train_distillation_epoch(
    teacher,
    student,
    dataloader,
    optimizer,
    device,
    loss_fn,
    temperature=4.0,
    alpha=0.5,
):
    """
    Train the student using a frozen teacher.
    """

    teacher.eval()
    student.train()

    running_loss = 0

    progress = tqdm(dataloader)

    for images, labels in progress:

        images = images.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        # Teacher predictions (NO gradients)
        with torch.no_grad():
            teacher_logits = teacher(images)

        # Student predictions
        student_logits = student(images)

        # Combined loss
        loss = loss_fn(
            student_logits=student_logits,
            teacher_logits=teacher_logits,
            labels=labels,
            temperature=temperature,
            alpha=alpha,
        )

        loss.backward()

        optimizer.step()

        running_loss += loss.item()

        progress.set_description(
            f"Distill Loss {loss.item():.4f}"
        )

    return running_loss / len(dataloader)
losses.py文件定义了模型如何衡量自己的错误。神经网络通过最小化损失来学习,基线可视化部分使用CrossEntropyLoss,知识蒸馏部分则引入了distillation_loss()。
这个文件里,我们用交叉熵和KL散度把硬标签与软目标结合起来。Geoffrey Hinton的算法就体现在这里。
import torch
import torch.nn as nn
import torch.nn.functional as F

cross_entropy = nn.CrossEntropyLoss()


def distillation_loss(
    student_logits,
    teacher_logits,
    labels,
    temperature=4.0,
    alpha=0.5,
):
    """
    Geoffrey Hinton's Knowledge Distillation Loss

    Parameters
    ----------
    student_logits : output from student model
    teacher_logits : output from teacher model
    labels         : ground-truth labels
    temperature    : controls softness of probability distribution
    alpha          : weight between hard and soft losses
    """

    # Hard Label Loss
    hard_loss = cross_entropy(student_logits, labels)

    # Teacher Soft Targets
    teacher_probs = F.softmax(
        teacher_logits / temperature,
        dim=1
    )

    # Student Soft Predictions
    student_log_probs = F.log_softmax(
        student_logits / temperature,
        dim=1
    )

    # KL Divergence
    soft_loss = F.kl_div(
        student_log_probs,
        teacher_probs,
        reduction="batchmean"
    )

    # Final Distillation Loss
    loss = (
        alpha * hard_loss
        +
        (1 - alpha)
        * (temperature ** 2)
        * soft_loss
    )

    return loss
train_teacher.py用于训练教师网络。首次运行之后,教师网络无需再次训练。
import torch
import torch.optim as optim

from models import TeacherNet
from utils import get_dataloaders
from engine import train_one_epoch, evaluate
from losses import cross_entropy

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

teacher = TeacherNet().to(device)

optimizer = optim.Adam(
    teacher.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_one_epoch(
        teacher,
        train_loader,
        cross_entropy,
        optimizer,
        device,
    )

    accuracy = evaluate(
        teacher,
        test_loader,
        device,
    )

    print(
        f"Epoch {epoch+1}/{epochs}"
        f" | Loss: {loss:.4f}"
        f" | Accuracy: {accuracy:.2f}%"
    )

torch.save(
    teacher.state_dict(),
    "teacher.pth",
)

print("\nTeacher saved successfully.")
train_student.py文件用于训练学生模型。它与train_teacher基本相同,区别仅在于网络更小,而且这里没有引入教师模型的引导。由此可以得到学生模型在没有教师帮助时的基准准确率。
import torch
import torch.optim as optim

from models import StudentNet
from utils import get_dataloaders
from engine import train_one_epoch, evaluate
from losses import cross_entropy

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

student = StudentNet().to(device)

optimizer = optim.Adam(
    student.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_one_epoch(
        student,
        train_loader,
        cross_entropy,
        optimizer,
        device,
    )

    accuracy = evaluate(
        student,
        test_loader,
        device,
    )

    print(
        f"Epoch {epoch+1}/{epochs}"
        f" | Loss: {loss:.4f}"
        f" | Accuracy: {accuracy:.2f}%"
    )

torch.save(
    student.state_dict(),
    "student_baseline.pth",
)

print("\nBaseline student saved.")
train_distilled_student.py 是整套代码的核心。在这个文件中,我们同时利用标签和教师模型的知识来训练学生模型,实现基于响应的知识蒸馏。
import torch
import torch.optim as optim

from models import TeacherNet, StudentNet
from utils import get_dataloaders
from engine import (
    train_distillation_epoch,
    evaluate,
)
from losses import distillation_loss

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

# Load Teacher
teacher = TeacherNet().to(device)
teacher.load_state_dict(
    torch.load(
        "teacher.pth",
        map_location=device,
    )
)

teacher.eval()

# Student
student = StudentNet().to(device)

optimizer = optim.Adam(
    student.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_distillation_epoch(
        teacher,
        student,
        train_loader,
        optimizer,
        device,
        distillation_loss,
        temperature=3,
        alpha=0.7,
    )

    accuracy = evaluate(
        student,
        test_loader,
        device,
    )

    print(
        f"Epoch {epoch+1}/{epochs}"
        f" | Loss: {loss:.4f}"
        f" | Accuracy: {accuracy:.2f}%"
    )

torch.save(
    student.state_dict(),
    "student_distilled.pth",
)

print("\nDistilled student saved.")
evaluate.py用来衡量训练后模型的表现。这里我们只需加载模型和测试数据,进行预测,再计算准确率。
import torch

from models import TeacherNet
from utils import get_dataloaders
from engine import evaluate

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

_, test_loader = get_dataloaders()

teacher = TeacherNet().to(device)

teacher.load_state_dict(
    torch.load(
        "teacher.pth",
        map_location=device,
    )
)

accuracy = evaluate(
    teacher,
    test_loader,
    device,
)

print(
    f"Teacher Accuracy: {accuracy:.2f}%"
)
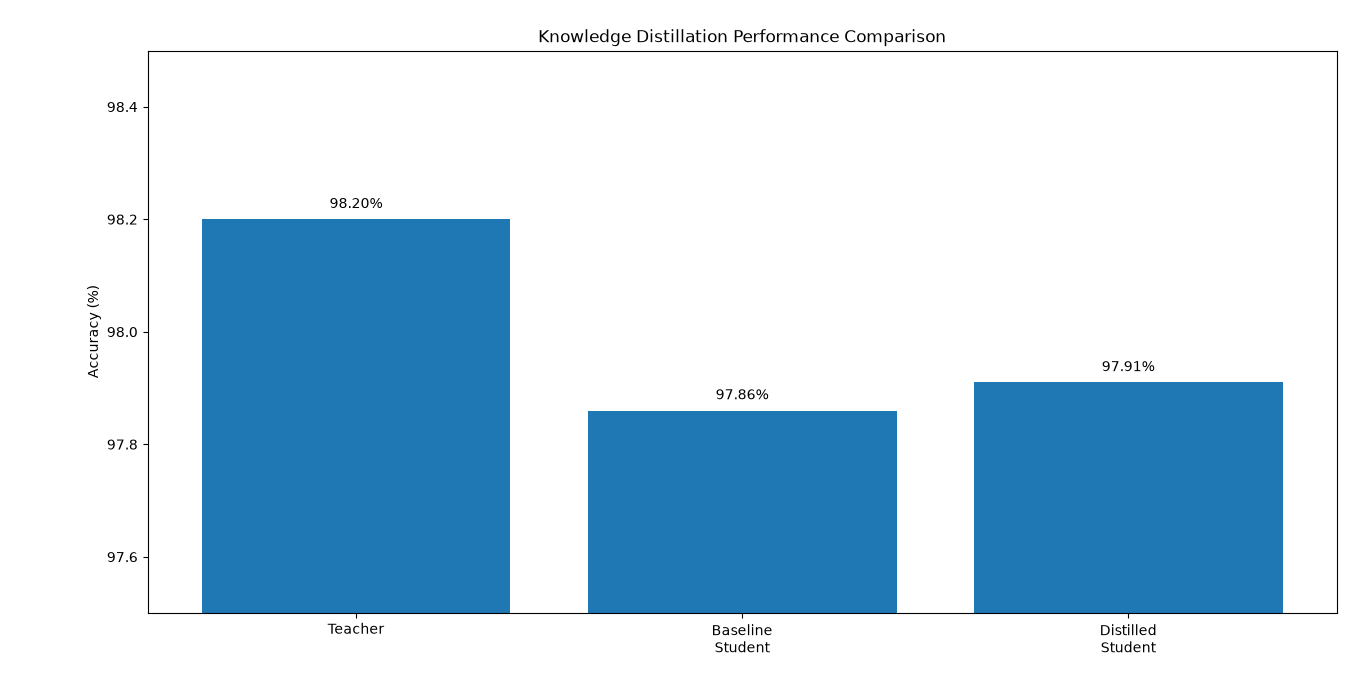
visualize.py文件用于把我们的结果以可视化方式呈现出来。我们借助Python库matplotlib,对教师模型、基线学生模型和蒸馏后学生模型的结果进行可视化展示。
import matplotlib.pyplot as plt

models = [
    "Teacher",
    "Baseline\nStudent",
    "Distilled\nStudent"
]

accuracy = [98.20, 97.86, 97.91]

plt.figure(figsize=(7,5))
plt.bar(models, accuracy)

plt.title("Knowledge Distillation Performance Comparison")
plt.ylabel("Accuracy (%)")

for i, v in enumerate(accuracy):
    plt.text(i, v + 0.02, f"{v:.2f}%", ha="center")

plt.ylim(97.5, 98.5)

plt.tight_layout()
plt.savefig("accuracy_comparison.png", dpi=300)
plt.show()
下面是我们程序的整体工作流,帮你了解各部分是如何协同运作的:
                       utils.py
                          │
                 Load MNIST Dataset
                          │
                          ▼
                     models.py
             TeacherNet / StudentNet
                          │
                          ▼
                     losses.py
  Cross Entropy + Distillation Loss Function
                          │
                          ▼
                     engine.py
    Generic Training and Evaluation Functions
             ┌────────────┼────────────┐
             │            │            │
             ▼            ▼            ▼
  train_teacher.py  train_student.py  distilled_student.py
             │            │            │
             ▼            ▼            ▼
   teacher.pth  student_baseline.pth  distilled.pth
                          │
                          ▼
                     evaluate.py
              Compute Final Accuracy
                          │
                          ▼
                    visualize.py
     Generate Charts and Experimental Figures
如何评估结果
下面来查看并评估我们的结果。以下截图分别是教师网络、学生网络和蒸馏后学生网络各自训练十轮的结果:
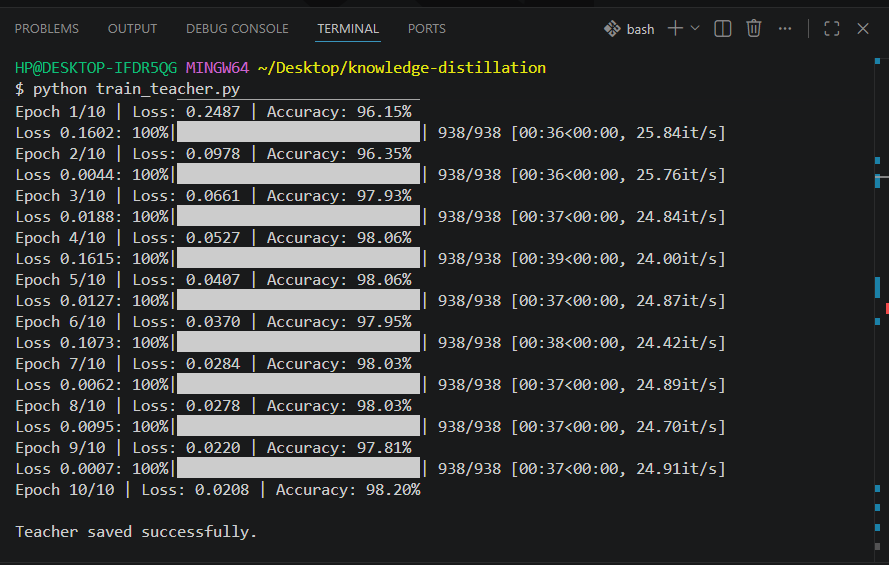
教师网络:完整跑完 10 轮后,准确率达到 98.20%。
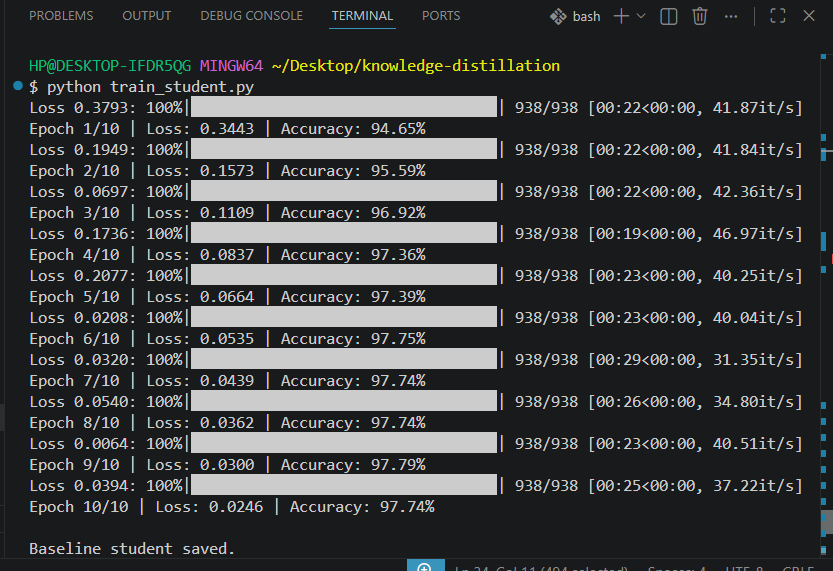
学生网络:完整跑完 10 轮后,准确率达到 97.74%。对于一个没有教师模型辅助的小型网络来说,这个成绩已经相当不错了。
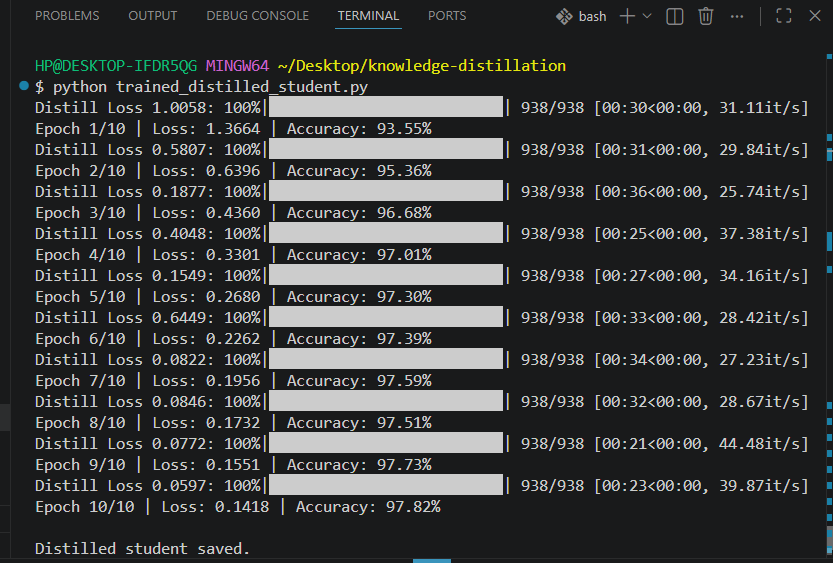
蒸馏后学生网络:完整跑完 10 轮后,准确率达到 98.20%。相比没有教师模型指导时的 97.74%,有了明显提升。
下图展示了各个模型的表现对比:
其他缩减模型体积的方法
前面我们通过实际代码示例了解了什么是模型蒸馏。接下来看看开发者们压缩大模型体积的其他方法——它们能降低延迟、减少内存占用和计算成本——以及它们与蒸馏的区别。
另外还有三种主流方法:
量化
量化的思路是大幅压缩神经网络中存储权重和激活值的数据类型位宽,从而提升效率。它针对的是内存带宽瓶颈,而不是模型架构本身。
简单来说,量化可以把 32 位数字转成 8 位数字,文件体积大约能省下 75%。
用一个现实中的类比来说明量化与蒸馏的区别:假如你想在印刷教科书时节省墨水和纸张——蒸馏相当于把教科书内容浓缩成摘要,而量化则是原样印刷,只是换用分辨率更低的字体来省墨省纸。
剪枝
剪枝基于这样一个原理:大模型中往往存在大量冗余且影响甚微的参数。通过移除这些弱连接,模型可以变得更小、更快。
沿用教科书的类比,剪枝就像通读全书,然后把那些你认为不需要的页码或章节直接撕掉。
低秩分解
这是一种数学方法,利用线性代数来简化深度学习架构中占主导地位的矩阵乘法运算。
放到教科书的例子上,这一过程相当于把复杂的长句改写成更简洁、更短,但含义相同的表达。
具体选择哪种方法,取决于你要解决的瓶颈是什么。量化一般适合应对内存问题,而剪枝和蒸馏则主要用于缩短计算时间。
结语
知识传承对人工智能的重要性,丝毫不亚于它在人类历史中的地位。正如亚里士多德承袭了柏拉图的学说,如今那些高效、可部署的神经网络,同样依赖于从大规模、高算力教师模型中提炼出的“暗知识”。
训练万亿参数的前沿大模型需要巨额的硬件投入和资金支持,而知识蒸馏则确保这些技术进步的实用价值不会被算力瓶颈所封锁,让更多人得以受惠。
正如我们在 PyTorch MNIST 实验中展示的那样,即便是简单的基于响应的蒸馏,也能让小网络通过学习大型教师模型的软概率,发挥出远超自身规模的实力。
再结合量化、剪枝等其他优化技术,蒸馏为在边缘设备、手机和消费级硬件上部署高性能 AI 提供了一条清晰的路径。
感谢阅读!欢迎访问我的 YouTube 频道,我在那里发布与 AI 相关的视频内容。
参考文献:
AI 洞察:来自英国科学、创新与技术部的模型蒸馏解读
Geoffrey Hinton 的《Distilling knowledge in a neural network》



