预处理一次快了上百倍:我实测区间求和的两种写法
今天 dev.to 热榜上有一篇《We Measured the 200x Claim, and Got It Wrong Twice First》,作者去验证一个"快 200 倍"的宣传,结果自己前两次都测错了。这篇文章戳到我了,因为"区间求和加一层前缀和预处理,查询从 O(n) 降到 O(1)"这话我给别人讲过不下十遍,自己却从来没在 Python 里认真量过:预处理那一步到底花多少时间,查询到底快多少倍,这笔账是不是真像教科书写的那么好看。不服就测。我写了个五十行的基准脚本,同一批数据、同一批查询,把朴素写法和前缀和写法扔到一起跑,跑完的数字比我想象的更极端,也更挑场景。
两种写法,加起来不到五十行
朴素写法是每个查询都切片再求和,老老实实把区间里的数重扫一遍;前缀和写法是先花一次 O(n) 把累加数组建出来,之后每个查询只做一次减法。数据用 5000 个 0 到 100 的随机整数,查询也是 5000 个随机区间,每种方法跑 3 遍取最快,免得调度抖动把结果带偏。完整脚本如下:
import random
import time

random.seed(42)

N = 5000      # array size
Q = 5000      # number of range-sum queries
REP = 3       # runs per method, keep the fastest

nums = [random.randint(0, 100) for _ in range(N)]
queries = []
for _ in range(Q):
    lo = random.randint(0, N - 2)
    hi = random.randint(lo + 1, N - 1)
    queries.append((lo, hi))


def naive():
    # rescan the whole slice for every single query
    return [sum(nums[lo:hi]) for lo, hi in queries]


def build_prefix():
    acc = [0]
    for v in nums:
        acc.append(acc[-1] + v)
    return acc


def with_prefix(acc):
    return [acc[hi] - acc[lo] for lo, hi in queries]


def bench(fn, *args):
    best = float("inf")
    out = None
    for _ in range(REP):
        t0 = time.perf_counter()
        out = fn(*args)
        best = min(best, time.perf_counter() - t0)
    return best, out
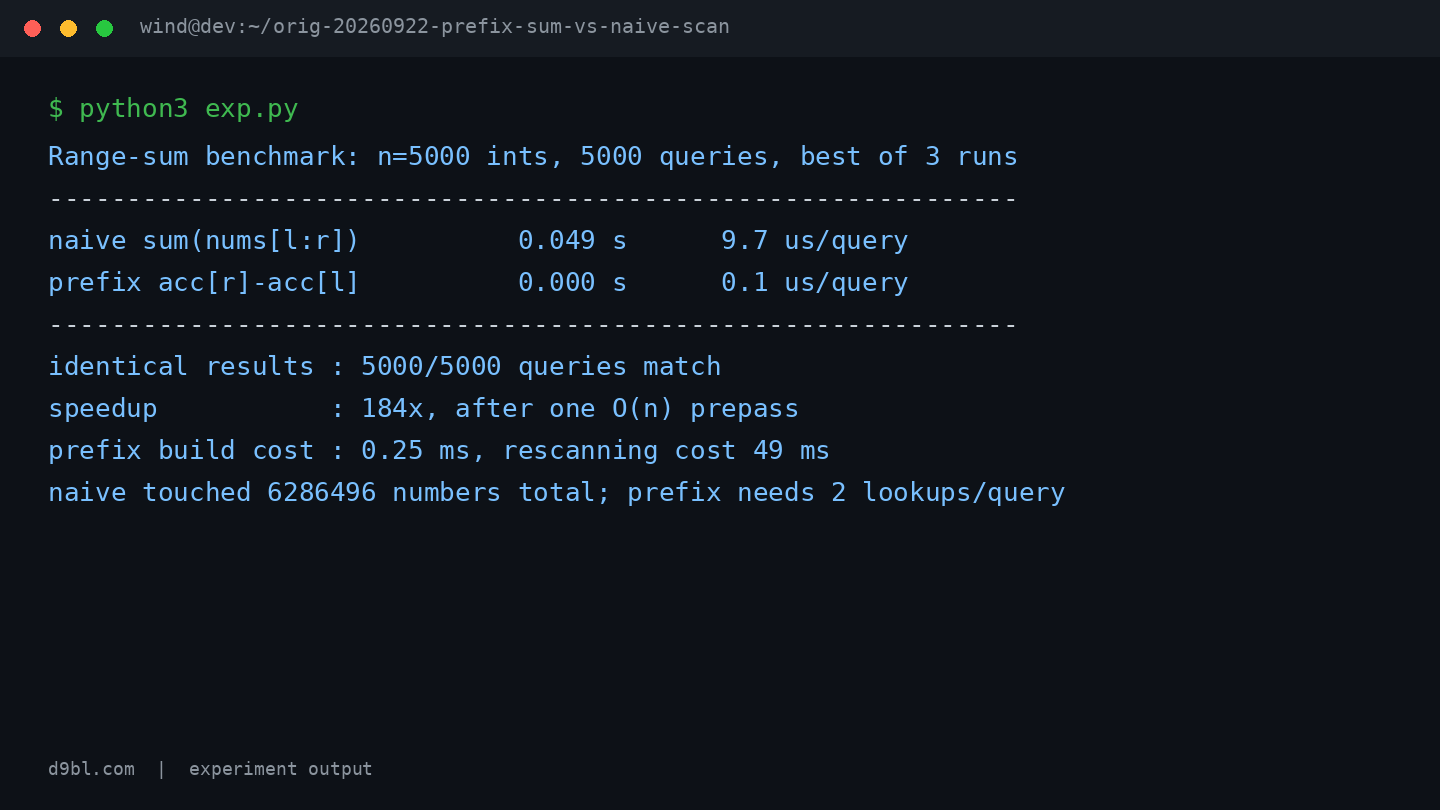
计时部分就是上面这个 bench 套上两个实现,最后一行一致性校验先按下不表,它在后面救过我一命。跑完的终端输出长这样:
184 倍是怎么来的
朴素版 5000 个查询总共花了 0.049 s,摊到每个查询 9.7 微秒;前缀和版整个列表处理完,秒那一栏显示 0.000 s,按微秒摊是每个查询 0.1 微秒。两种方法的结果 5000/5000 全部一致,提速 184 倍。再看前置成本:建前缀和数组只花了 0.25 ms,而朴素重扫花了 49 ms——预处理这一步便宜到几乎可以忽略,便宜才是它能换到 184 倍的前提。
倍数本身不难理解:朴素版这 5000 个查询总共摸了 6286496 个数字,平均每个区间扫 1257 个数,而且 sum(nums[lo:hi]) 在求和之前还得先切出一个临时列表,切片分配的隐藏开销也计在那 9.7 微秒里;前缀和版每个查询只做两次下标访问加一次减法。我顺手算了笔回本账:预处理 0.25 ms,按朴素版 9.7 微秒一次的单价,大约 25 个查询就把预处理的成本赚回来了,之后每一笔都是净赚。
我先把区间边界写反了
翻车就翻在那些"背过但没写对"的细节上。第一版我把查询写成 acc[hi+1] - acc[lo],脑子里想的是闭区间,跑出来一致性校验直接报出一大片不匹配——这份代码里 5000/5000 那行校验就是被这个 bug 逼出来的。这份实现里 acc[r] 的语义是"前 r 个数之和",和切片 nums[lo:hi] 的左闭右开正好对齐,两种约定各自都对,混着用就全错。没有那行校验,我会拿着一个错得整整齐齐的结果去讲 184 倍。
还有个反直觉的小坑:前缀和版总耗时那一栏印的是 0.000 s,我盯着看了好几秒,以为函数根本没跑。其实是总耗时太小,被 %8.3f 的格式四舍五入成了 0.000,真正的信息在旁边 0.1 us/query 那一列。测极快的代码时,报表格式化本身会吃掉精度,这不算 bug,但看数字的人得知道该看哪一列。
这个 184 倍的适用边界
把丑话说在前面:这份成绩有三个前提,缺一个倍数就会缩水。第一,数据是静态的。前缀和的命门在更新——nums 里改一个数,acc 从那个位置往后的值全部作废,要么 O(n) 重建,要么换树状数组。我的场景里 5000 个数重建才 0.25 ms,无所谓;换成频繁单点更新的负载,前缀和会把你拖下水。第二,查询是随机的,平均每个区间扫 1257 个数,朴素版单次成本被撑得很高;如果你的真实区间都很短,比如每次只碰 10 个数,朴素版单次会便宜一个数量级,184 倍会缩到十几倍。第三,这是 CPython 的地盘,0.1 微秒的查询几乎全是解释器开销,换 numpy 或者换语言,绝对值和倍数都会变。
所以我的建议很具体:写区间统计之前先估两个数——查询次数,和数据更新频率。查询是批量来的、数据基本只读,就花一次 0.25 ms 级别的预处理去换 184 倍,闭眼换;数据频繁变动,老老实实朴素扫,或者直接上树状数组,别硬套前缀和。至于这个 184 倍本身,按今天那篇热榜文章的态度,它也只是一个数据形状下的测量值——你把自己的区间长度分布和查询量代进去重跑一遍之前,别把它当成承诺。



