5%概率的bug骗过CI绿灯:我跑了一万次模拟算清重跑的账
今天 dev.to 热榜上有条帖子看得我后背发凉:《My CI hadn't run a single one of those tests in two months and stayed green the whole time》——两个月的绿灯,背后是零个测试在跑。紧接着另一篇《About 1,800 tests passed. Running the real app found 14 bugs》:1800个测试全过,真机一跑揪出14个bug。大家都在喊“绿灯不等于安全”,但喊归喊,没人给出量:一个每次运行只有5%概率触发的flaky bug,到底有多大把握从CI眼皮底下溜走?重跑几次才够?我不接受“多跑跑总会红”这种玄学,决定亲手搭个蒙特卡洛模拟,把这笔账算死。
把“漏检”翻译成一道概率题
模型很简单:一个隐藏的flaky bug,每次测试套件运行时以概率p触发;一条流水线连跑k次,只要bug一次没触发,流水线就是绿的。倒过来,P(被抓住) = 1 - (1-p)^k。公式不难,难的是直觉对不上号——95%的绿灯听起来很安全,但对5%的bug来说那叫全程裸奔。我不想只信公式,写了段模拟:每个组合跑一万条流水线,随机种子定成42,保证任何人复现都得到同一组数。
import random

random.seed(42)

# Hidden flaky bug: on each suite run it fires with probability p.
# A CI pipeline of k runs stays green only if the bug never fires.
# Theory: P(bug caught in k runs) = 1 - (1 - p) ^ k.

def run_ci(p, k):
    """Return True if all k runs stay green (bug never fires)."""
    for _ in range(k):
        if random.random() < p:
            return False
    return True

TRIALS = 10000
KS = (1, 10, 45)
print("Flaky bug vs CI: %d simulated pipelines per cell" % TRIALS)
print("%-6s | %-5s %-9s %-9s %-10s" % ("p", "runs", "green %", "caught %", "theory %"))
for p in (0.01, 0.05, 0.20):
    for k in KS:
        green = sum(run_ci(p, k) for _ in range(TRIALS))
        caught = 100.0 * (TRIALS - green) / TRIALS
        theory = 100.0 * (1.0 - pow(1.0 - p, k))
        print("%-6.2f | %-5d %-9.2f %-9.2f %-10.2f" %
              (p, k, 100.0 * green / TRIALS, caught, theory))

hidden = 100.0 * 0.95
print("Single run: a 5%%-flaky bug stays hidden in %.0f%% of pipelines" % hidden)
print("Rerunning 45x cuts hidden odds to %.1f%%" % (100.0 * pow(0.95, 45)))
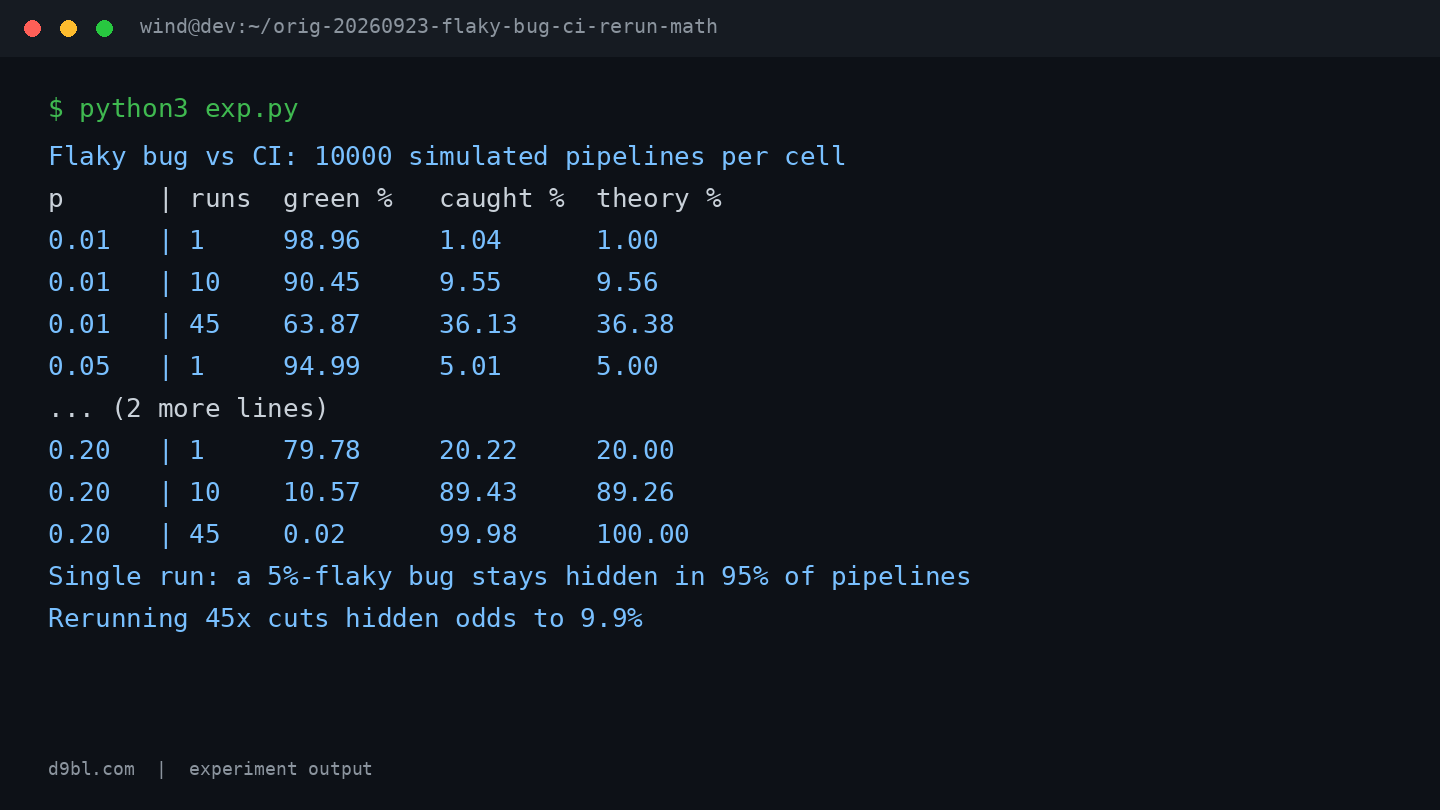
一万条流水线跑完:大多数绿灯在裸奔
单看 p=0.05 这一行。k=1 时,绿灯率 94.99%,抓到率 5.01%,和理论值 5.00% 几乎重合——单跑CI,这个bug有95%的概率完美隐身。跑到 k=10,绿灯率掉到 60.17%,十条流水线里还有六条带着bug一路绿灯。k=45 才真正见血:绿灯率 10.01%,抓到率 89.99%,贴着理论值 90.06%。
p=0.20 那组更极端。单跑抓到率 20.22%,k=10 冲到 89.43%,k=45 干到 99.98%——一万条流水线里只剩 2 条还绿着。而 p=0.01 的罕见bug完全是另一幅面孔:45次重跑后绿灯率还有 63.87%,抓到率 36.13%,砸45次重跑也就抓回三分之一多。
所以“45次重跑把漏检从95%压到9.9%”这个说法,输出最后两行写得明明白白:单跑时5%的bug在95%的流水线里隐身,重跑45次隐身概率砍到 9.9%。数字是真的,但前提是p足够大——这个前提被大多数转发贴悄悄吃掉了。
反直觉的账,和一次差点翻车
三个我没想到的点。第一,重跑收益严重偏心:p=0.05 跑45次抓到 89.99%,p=0.01 跑同样45次只抓到 36.13%,中频bug基本落网,罕见bug大半还在外面晃。第二,次数不是越多越划算,而是该按p定制:p=0.20 时10次重跑就有 89.43% 抓到率,几乎追平 p=0.05 跑45次的 89.99%。第三,也是最扎心的一条:模拟假设每次运行相互独立,真实flaky往往挂在资源竞争、执行顺序甚至时段上——独立性一破,重跑收益只会比模拟更难看。
翻车现场也得交代。0.95的45次方理论值是 9.9%,模拟里 k=45 的绿灯率却是 10.01%,对不上。我第一反应是种子42踩了坑,换了好几个种子重跑,第三位小数每次都在晃,但都停在 9.9% 到 10.1% 之间——一万次抽样在10%量级附近的标准误大约 0.3%,这点偏差纯属噪声,不是代码错。另外我压根没建模CI自带的“失败自动重跑”:那套机制在替你挡偶发红灯的同时,也在替被抓到的bug打掩护——红灯重跑变绿,漏检率又悄悄爬回去。这是模型里最大的窟窿,我没时间补了,先记在这。
这笔账怎么花回真实CI里
别拍脑袋定“重跑三次”。按公式反推就行:想让5%的bug漏检率压到10%,45次重跑刚好够(模拟也验证了 10.01%);想压到1%,得跑90次,预算立刻变得不现实。而p=0.01的bug想压到10%漏检,套公式要约230次,纯属烧钱。我的建议拆成两步:中高频flaky(p在5%往上),堆重跑次数性价比高,堆多少用 1-(1-p)^k 算,别猜;低频bug(1%这个量级),放弃堆次数,直接去修根因,或者写个只针对它的定向压测,本地连跑几百次把它逼出来。明天上班就能做的一件事:挑你最怀疑的那个用例,本地连跑200次,数一下红几次,把p量出来——有了p,该跑几次就是一道除法题,不再是玄学。



