我实测4位短码:千次生成,3.5%的批次真的撞了
早上刷 dev.to 热榜,看到那篇讲 Git 2.55 reftable 后端的文章,10,000 个引用从 650 毫秒降到 40 毫秒。我盯着 10,000 这个数字发了一会儿呆,想起自己上个项目干过的一件心虚事:对象 ID 用的是 4 位 base62 短码,当时我在 code review 里拍胸脯说"62 的 4 次方,一千四百多万的空间,撞不上"。这话我从来没算过,一次都没有。热榜往下滑还有一篇讲 Python 内部机制的视觉指南,我想那就别找借口了,当场用 Python 把这笔账算清楚。
要验证的东西很具体:4 位短码到底抽多少个才会撞?一次发 1000 个码,有多大概率里面已经藏了一对重复?我不信感觉,只信跑出来的数。
两个实验:撞在第几个,撞了多少批
我从两个角度问同一个问题。第一个问"撞在第几个":不断抽码,抽到第一个重复出现为止,记下用了几次。这个实验重复几百轮取中位数,理论上中位数应该落在 sqrt(2M·ln2) 附近,M 是空间大小——这正是生日悖论的核心结论,撞车概率过半所需的次数,和空间的平方根同一个量级。
第二个问"撞了多少批":固定一次抽 n 个码,看这批里有没有重复,如此重复 2000 轮,统计出事批次的比例,再拿它对照理论公式 1 - exp(-n(n-1)/2M)。两个函数都不复杂,固定 seed 42 保证可复现,全套代码如下:
import math
import random
import statistics

random.seed(42)  # fixed seed for reproducible runs

def first_collision(space, rr=random.randrange):
    # draw ids until one repeats, return the number of draws used
    seen = set()
    n = 0
    while True:
        n += 1
        x = rr(space)
        if x in seen:
            return n
        seen.add(x)

def has_collision(n, space, rr=random.randrange):
    # draw n ids once, report whether any repeat showed up
    seen = set()
    for _ in range(n):
        x = rr(space)
        if x in seen:
            return True
        seen.add(x)
    return False

print("short random ID collision test (base62, random.seed=42)")
print(f"{'len':>3} {'space':>12} {'median(sim)':>12} {'sqrt(2Mln2)':>12} {'ratio':>6}")
med4 = None
for length, trials in ((3, 400), (4, 300), (5, 40)):
    space = 62  length
    data = [first_collision(space) for _ in range(trials)]
    med = statistics.median(data)
    th = math.sqrt(2 * space * math.log(2))  # birthday estimate of median
    if length == 4:
        med4 = med
    print(f"{length:>3} {space:>12,} {med:>12,.0f} {th:>12,.0f} {med / th:>6.3f}")

print("fixed batch: probability of >=1 collision among n drawn ids")
print(f"{'len':>3} {'n':>6} {'theory':>8} {'simulated':>10} {'hits':>6}")
for length, n, trials in ((3, 500, 2000), (4, 1000, 2000)):
    space = 62  length
    th = 1 - math.exp(-n * (n - 1) / (2 * space))
    hits = sum(has_collision(n, space) for _ in range(trials))
    print(f"{length:>3} {n:>6} {th:>8.2%} {hits / trials:>10.2%} {hits:>6}")
print(f"4-char ids: ~{med4:,.0f} draws to reach 50% collision odds (space 62^4)")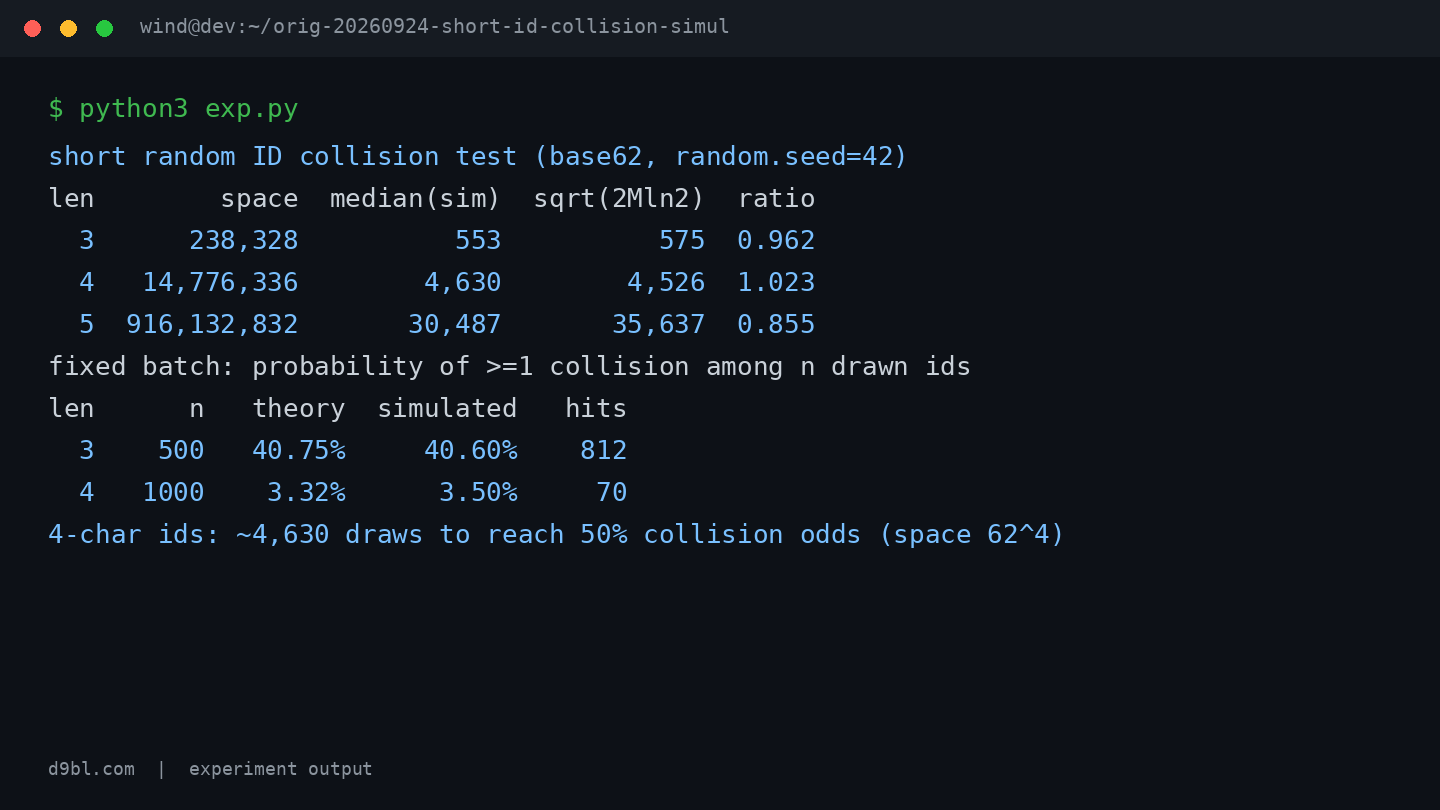
中位数和公式贴得比我想的近
先看 3 位码:空间 238,328,模拟中位数 553,公式给的是 575,比值 0.962,偏差不到 4%。4 位码更漂亮:空间 14,776,336,模拟中位数 4,630,公式 4,526,比值 1.023,偏差 2% 出头。我上学时背生日悖论全当教条背的,这次是头一回亲眼看着一个平方根公式跟模拟结果贴到这个程度。
真正冲击我直觉的是 4,630 和 14,776,336 这两个数的对比。抽 4,630 次,用掉的码只占空间的万分之三出头,撞车概率却已经过半。也就是说,你根本不需要"用满"空间才会撞——空间连零头都没碰到的时候,重复就已经是大概率事件。我当年那句"一千四百多万撞不上",错就错在把"空间大"当成了"撞车难",这两件事之间隔着一条平方根。
批次实验:3.5%不是吓唬人
中位数是理论层面的过半点,工程上更要命的是批次实验。4 位码一次抽 1000 个,2000 轮里撞了 70 轮,实测 3.50%,理论 3.32%,两边咬得很紧。翻译成人话:如果你的系统这辈子会发出去 1000 个 4 位短码,那就有大约三十分之一的机会,其中已经躺着一对重复 ID。这不是"几乎不可能",这是迟早会轮到某个人头上的 production bug。
对照 3 位码那行更能看出这条曲线有多陡:一次 500 个 3 位码,理论 40.75%,实测 40.60%,2000 轮里 812 轮出事,四成批次带伤。撞车概率大致按 n²/2M 往上走——批次翻倍,概率接近翻四倍;空间扩大 62 倍,概率缩 62 倍。前段看起来人畜无害,等你察觉不对劲的时候,往往已经撞过好几回了。
翻车点和这次实验不干净的地方
5 位码那行是我这次最大的翻车点。空间 916,132,832,模拟中位数 30,487,公式 35,637,比值掉到 0.855,偏差比 3 位和 4 位大了一个数量级。我第一反应是公式在大空间失效了,回去查才发现问题在我自己:5 位码一轮平均要抽三万次才撞,我嫌慢只跑了 40 轮,40 个样本取中位数本身就是个抖得厉害的估计。0.855 更可能是样本太少,而不是理论错了。这个坑我这次没补实验,如实记在这里。
另外几处不干净也得交代。整份代码固定了 seed 42,你能复现出和我一模一样的数字,但也意味着上面所有结果只是随机性的一个实现,换一批种子,3.50% 会上下浮动。random.randrange 底下是梅森旋转算法,不是密码学安全的随机源,模拟自然碰撞没问题,要对抗"故意撞你 ID 的人"这个实验根本不适用。还有,真实业务的短码几乎从不均匀——过滤敏感词、去掉易混字符、人为加前缀,每个动作都在偷偷缩小空间,实际撞车率只会比模拟更高,不会更低。
我最后改了什么
数据看完,动作很明确。我把自己项目里的对外短码从 4 位提到 6 位:码长每加一位,空间扩大 62 倍,50% 撞车点跟着往后推 62 倍,4 位码的 4,630 推到 6 位就变成二十多万开外,一次发 1000 个的撞车概率掉进可以忽略的量级。同时我不再把"概率低"当安全边界:入库字段加了唯一索引,生成逻辑遇到冲突就重抽。3.5% 听着小,撞到的那一次就是两个用户数据串门的事故。
一条可以照抄的经验:短码长度别拍脑袋,拿系统生命周期内要发的总量 n 去对照 sqrt(2M·ln2),让 n 至少离这个点还有一个数量级的余量。下次我打算把实验再往真实推一步——把大小写不敏感、剔除 0 和 O 这类易混字符之后的"人类有效空间"算进去,看看它比 62^n 缩水多少。我怀疑到时候,连 6 位都得重新掂量。



