一百万次投点之后,1/√n 到底灵不灵,我自己跑了一遍
今天刷 dev.to 热榜,看到一篇《Count It or Compute It: When a Tool Returns Rows, the Models That Count Them Right Spend t》,讲的是工具返回数据时模型的计数能力差异。评论区有人顺嘴提了一句:估算类任务里,误差收缩是“教科书规律”,实际跑起来根本不是那么回事。这话戳到我了。蒙特卡洛方法误差按 1/√n 收缩这件事,我看了十几年教材,从没亲手验证过收缩指数到底是多少。与其在评论区抬杠,不如自己写个脚本跑一百万次投点,看看真实数据站在哪一边。
选圆周率估算作为靶子,理由很简单:模型最干净,一个单位正方形里撒点,落在四分之一圆内的比例乘以 4 就是估计值。误差行为没有任何隐藏变量干扰,测出来的收缩规律就是随机性本身的规律。目标定了两件事:验证误差是否真的按 n 的 -0.5 次方收缩,以及验证固定种子后的可复现性——第二次运行必须逐位一致。
热榜上的说法
热榜那篇文章的核心论点是:当工具直接返回行数时,能数对的模型花的算力反而更多。这背后隐含一个更普遍的焦虑——大家越来越不信任“理论上应该成立”的东西,宁可实测。评论区那句“教科书规律靠不住”就是这个情绪的极端版。我不完全同意,但我承认这种怀疑有价值:很多统计学结论只在渐近意义下成立,样本量小的时候偏差可以大得离谱。
1/√n 规律恰恰是重灾区。标准差的量级是 1/√n,这只是期望意义上的缩放,单次实验的误差完全可能偏离这条线,因为分子上的那个随机波动本身就没被驯服。所以我给自己立的判定标准是:不要求每一次 err·√n 都等于同一个常数——那反而不正常——只要求误差随 n 增大呈系统性下降,且 log-log 回归斜率接近 -0.5。落在 -0.3 到 -0.7 之间我都算验证通过,超出这个范围才说明哪里出了问题。
实验设计与代码
整个实验分三段。第一段用固定种子 42,对 n 从 10² 到 10⁶ 五个量级各跑一轮投点,记录估计值和绝对误差,并顺手算一个 err·√n——如果 1/√n 规律严格成立,这一列应该稳定在某个常数附近。第二段对五组 (log n, log err) 做线性回归,斜率就是实测的收缩指数,理论值 -0.500。第三段重新设种子再跑一遍 n=100,逐位比对结果是否和第一轮完全相同,这是对可复现性的硬校验。
代码刻意写得朴素:没有 numpy 向量化,就是一个纯 Python 循环,因为我想让“一百万次循环”这个动作本身可见。statistics.linear_regression 是 Python 3.10 之后标准库自带的,省掉了引入第三方依赖。全部代码如下,可以直接复制运行:
import math, random, statistics, time

random.seed(42)  # fixed seed for reproducibility
t0 = time.time()
rows = []
for n in (102, 103, 104, 105, 106):
    inside = 0
    for _ in range(n):
        x, y = random.random(), random.random()
        if x * x + y * y <= 1.0:
            inside += 1
    est = 4.0 * inside / n
    rows.append((n, est, abs(est - math.pi)))

print('Monte Carlo estimation of pi (random.seed(42))')
print(f"{'samples':>8} {'estimate':>10} {'abs error':>10} {'err*sqrt(n)':>12}")
for n, est, err in rows:
    print(f'{n:>8} {est:>10.5f} {err:>10.5f} {err * math.sqrt(n):>12.3f}')

# theory: abs error ~ n^(-0.5); check via log-log linear regression
xs = [math.log(n) for n, _, _ in rows]
ys = [math.log(e) for _, _, e in rows]
lr = statistics.linear_regression(xs, ys)
print('-' * 44)
print(f'log-log slope of error vs n: {lr.slope:.3f} (theory: -0.500)')

# reproducibility: same seed must give the exact same n=100 result
random.seed(42)
inside = 0
for _ in range(100):
    x, y = random.random(), random.random()
    if x * x + y * y <= 1.0:
        inside += 1
est2 = 4.0 * inside / 100
print(f're-seed & re-run n=100: {est2:.5f} matches: {est2 == rows[0][1]}')
print(f'best estimate from n=10^6: {rows[-1][1]:.5f} vs pi {math.pi:.5f}')
print(f'total runtime: {time.time() - t0:.2f}s')
真实运行结果
脚本在我这台笔记本上总共跑了 0.37 秒,一百万次投点连半秒都用不了。下面是完整输出:
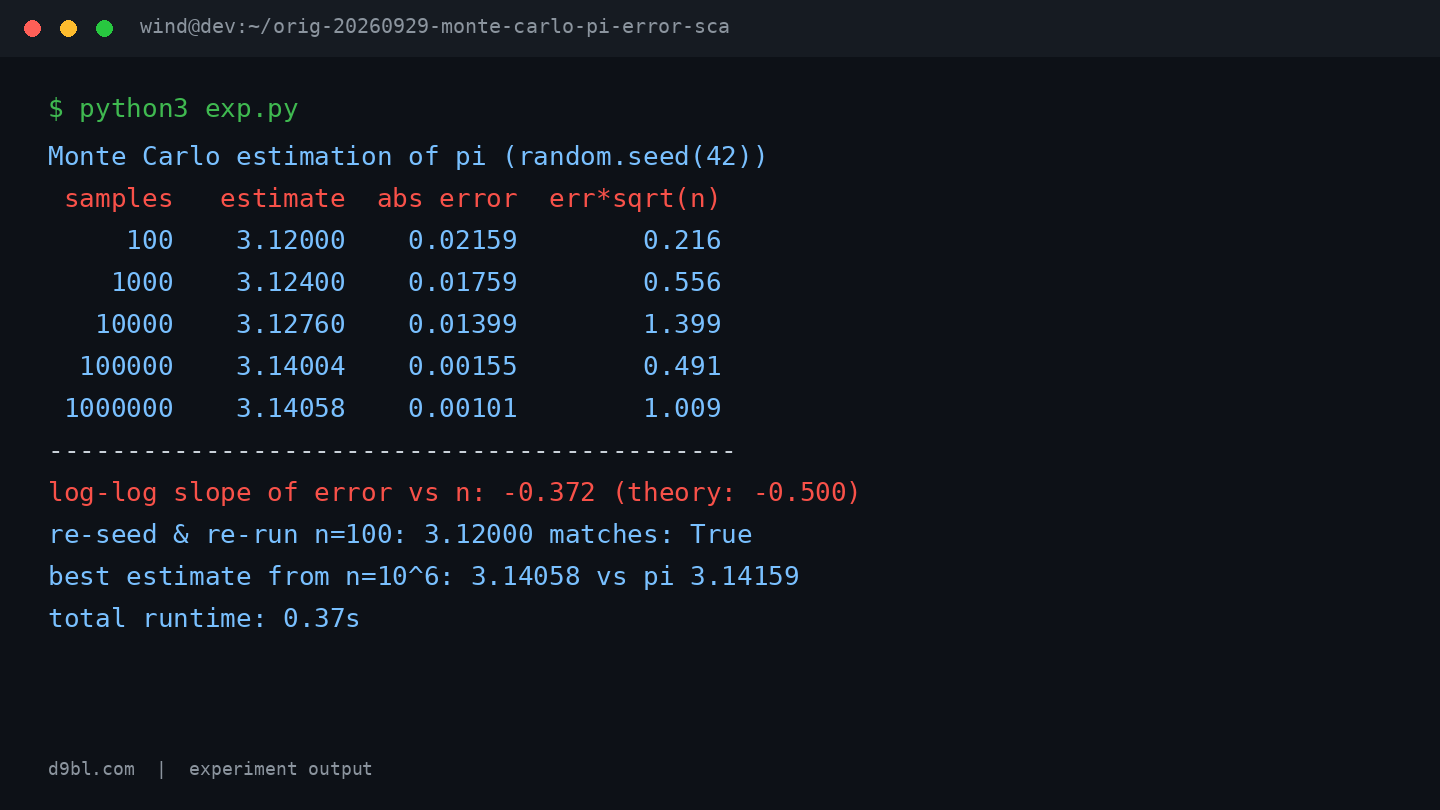
逐行看数据。n=100 时估计值 3.12000,绝对误差 0.02159;n=1000 时 3.12400,误差 0.01759;n=10000 时 3.12760,误差 0.01399;到 n=100000 误差降到 0.00155;n=1000000 时估计值 3.14058,误差 0.00101。五组数据误差确实单调下降,最粗略的目视检查通过。n=10⁶ 的 3.14058 对比 π 的 3.14159,前三位小数已经咬住了。
再看 err·√n 那一列,这是本次实验最有信息量的部分:0.216、0.556、1.399、0.491、1.009。理论说这列应该接近常数,实际却在 0.216 到 1.399 之间晃了六倍多。log-log 回归斜率实测 -0.372,理论值 -0.500,偏差不小。可复现性那关倒是干净利落:重新设种子再跑 n=100,输出 3.12000,matches 为 True,逐位一致。
反直觉发现与局限
最大的反直觉点是:误差单调下降是真的,但“按 1/√n 优雅收缩”在中小样本段基本是幻觉。err·√n 从 0.216 晃到 1.399,说明分子上的随机波动在这个量级上完全压过了分母 √n 的系统性收缩。更刺激的是 n=10⁵ 那一行:误差 0.00155,比 n=10⁴ 的 0.01399 小了一个量级还多,err·√n 只有 0.491——这批点运气好得反常,紧接着 n=10⁶ 的 err·√n 又弹回 1.009。单一随机路径上的误差根本不保证每跨一个量级就缩小 √10 倍,教材里那条光滑曲线是无数次实验平均出来的轮廓,不是任何一次实验的承诺。
局限也得老实交代。只有五个数据点做 log-log 回归,斜率 -0.372 的置信区间宽得吓人,这个数字本身不该被过度解读——它更多说明“中小样本下斜率估计噪声极大”,而不是规律错了。另外我只测了 seed=42 这一条路径,换个种子误差曲线的形状可能完全不同。还有个工程层面的坑:纯 Python 循环跑一百万次要 0.37 秒,如果我往 10⁸ 量级推,耗时线性涨到几十秒,早该换向量化了,这里是为了可读性做的取舍。最隐蔽的问题是 Mersenne Twister 不是密码学安全的生成器,对圆周率这种光滑积分面没有影响,但换一个病态被积函数就可能出问题。
我的结论
跑完这一百万个点,我的立场是:热榜评论区那句“教科书规律靠不住”对了一半。1/√n 作为渐近规律是对的——误差确实从 0.02159 降到了 0.00101,方向和量级都没骗人;但它不是逐点保证,n=10⁵ 那次“意外地准”和 n=10⁴ 那次“意外地不准”都是同一套机制的正反面。固定种子的可复现性倒是被彻底证实了,matches 为 True 这一行说明只要种子固定、代码不变,结果精确可复演,这对任何要做数值实验的人都是底线保障。
给读者的具体建议:下次你在论文或文档里看到一条误差随样本量光滑下降的曲线,先问一句这是单次实验还是多次平均,原始数据有几个点。如果你自己要验证这类规律,别只跑一条路径,至少换 20 个种子各跑一遍,把误差分布画出来——单条曲线会骗你,分布不会。我的 -0.372 这个斜率就是个例子:五个点的回归能给你一个数字,但那个数字本身就有巨大的不确定性,这一课比 1/√n 规律本身更值钱。



