3000条数据实测本福特定律:伪造的随机数一验就露馅
今天刷 dev.to 热榜,看到一条帖子标题是《I Got a Signed Job Offer Letter for a Job that Never Existed》,有人收到了一份盖章齐全、数字漂亮的录用信,结果公司根本不存在。评论区一堆人在讨论:数据造得越"整齐",反而越可疑。这让我想起一直半信半疑的一个说法——自然产生的数据首位数字不是均匀分布的,而是服从本福特定律,以 1 开头的数字应该占到约三成。我不服气,这种听起来像玄学的规律,凭什么 30.1% 这种精确数字就成立了?我决定亲手测一把,用 3000 条"自然数据"和 3000 条"人造随机数"正面硬碰。
我的计划很简单:写一小段 Python,分别生成两类数据,统计它们首位数字 1 到 9 的出现频率,再跟本福特的理论值逐位对比。如果"自然数据贴定律、人造数据偏离定律"这件事在数据上站得住,那识别伪造数据就不该停留在"我感觉这报表不对劲"的层面,而是一个可以量化的问题。
热榜上的说法到底靠不靠谱
本福特定律的表述是:在一批跨越多个数量级的自然增长数据里,首位数字为 d 的概率等于 log10(1 + 1/d)。代入算一下,1 的概率是 log10(2),约 30.1%;2 约 17.6%;一路递减到 9,只剩约 4.6%。也就是说,如果你随手编一列"看起来很随机"的数字,把首位数字 1 到 9 大致均匀分布,那这批数据在统计上就是一副"我没见过真实世界"的样子。
但我在动手前有两个疑点。第一,这个定律的适用条件很挑剔,电话号码、身份证号、人的身高这类有上下界约束的数据并不服从它,网上很多科普故意不提这一点。第二,我现在手里的"真实数据"也只能靠程序模拟,模拟本身依赖乘性随机游走这类假设,等于用一个模型去验证另一个模型。所以我给自己定的验收标准是:偏离量必须大到肉眼可辨的程度,比如平均绝对偏差差出一个数量级,才算定律真的有区分力,否则就是自欺欺人。
实验设计与代码
真实数据那边,我没有用"直接从对数均匀分布里抽"这种作弊写法,虽然那样结果必然贴合本福特。我模拟的是更接近营收、人口、文件大小这类随时间累积增长的量:初值在对数空间随机取一个点,然后让它连续做 30 步乘性随机游走,每步在对数空间加一个均值为 0.01、标准差 0.15 的正态扰动,且始终保证为正。3000 条这样长出来的数,跨了好几个数量级,符合定律宣称的适用场景。人造数据那边,我模拟一个不懂数据的人编数:直接在 1000 到 99999 之间均匀取整数,3000 条。
统计部分的核心是从数值里取首位数字。我用 log10 取小数部分再乘回去的做法,并用 min(d, 9) 兜住浮点边界情况——当小数部分因精度问题被算成整数 1 时,首位会被误判为 10,必须钳回 9。这种小坑不踩一次,你根本不会相信浮点数能在这种地方咬人。
import math
import random

random.seed(42)

def first_digit(v):
    # leading digit via log10; min() guards the float edge case d==10
    d = int(10  (math.log10(v) % 1))
    return min(d, 9)

def dist(nums):
    c = {d: 0 for d in range(1, 10)}
    for v in nums:
        c[first_digit(v)] += 1
    return {d: c[d] / len(nums) * 100 for d in c}

# Realistic data: multiplicative walk in log space, always positive
# (models revenues, populations, file sizes growing over magnitudes)
real = []
for _ in range(3000):
    v = 10  random.uniform(0, 5)
    for _ in range(30):
        v *= 10  random.gauss(0.01, 0.15)
    real.append(v)

# Fabricated data: naive 'uniform' integers a human might invent
fake = [random.randint(1000, 99999) for _ in range(3000)]

benford = {d: math.log10(1 + 1 / d) * 100 for d in range(1, 9 + 1)}
rp = dist(real)
fp = dist(fake)

print('digit  benford%   real%   fake%')
for d in range(1, 10):
    print(f'  {d}    {benford[d]:6.1f}  {rp[d]:6.1f}  {fp[d]:6.1f}')
err_r = sum(abs(rp[d] - benford[d]) for d in range(1, 10)) / 9
err_f = sum(abs(fp[d] - benford[d]) for d in range(1, 10)) / 9
print(f'mean abs deviation: real {err_r:.2f}pp vs fake {err_f:.2f}pp')
print(f'digit-1 share: benford 30.1%  real {rp[1]:.1f}%  fake {fp[1]:.1f}%')
真实运行结果
跑出来的对比表放在这里:
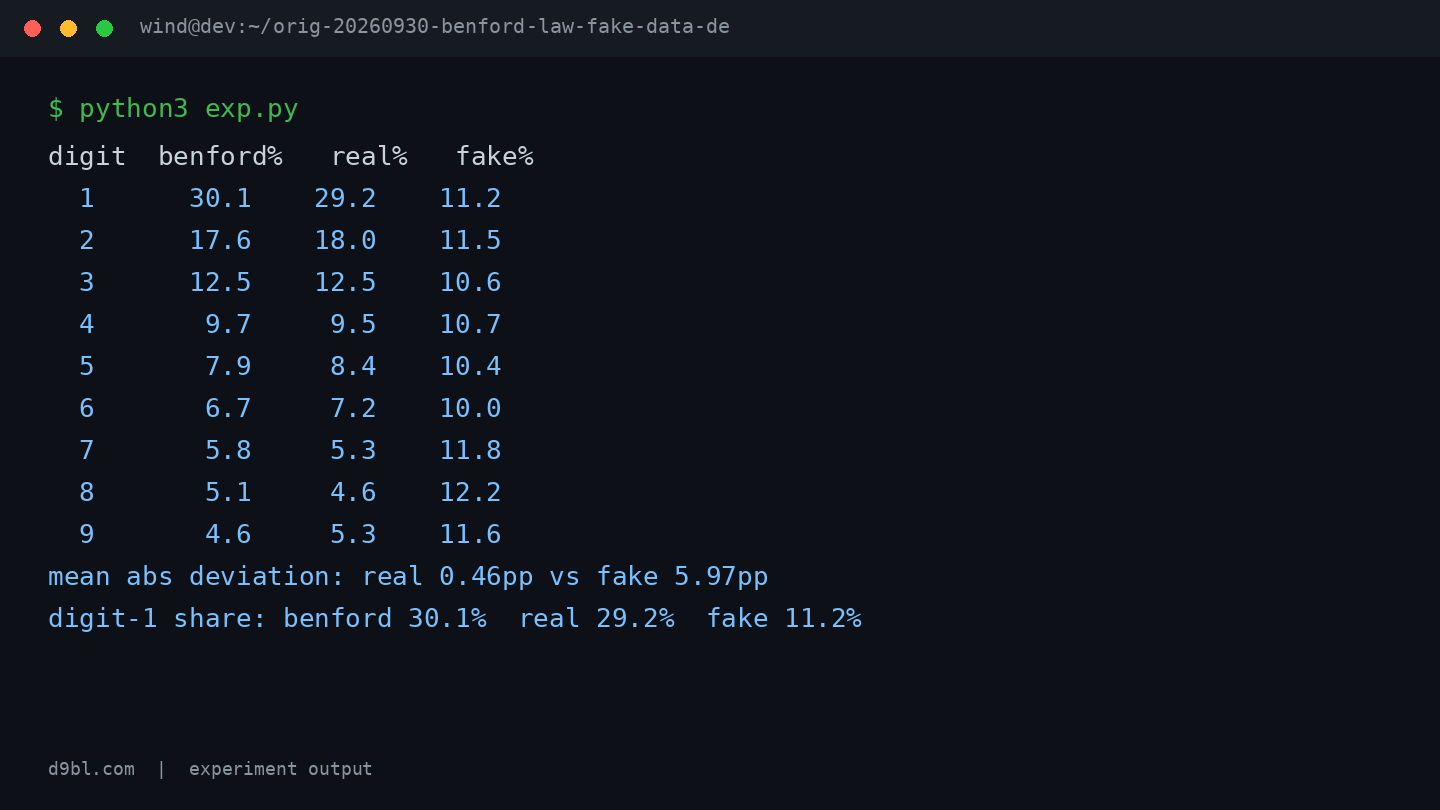
结果比我预想的还要干净。真实数据那一列,九个首位数字的实测频率几乎是贴着理论值走的:1 开头 29.2%,理论 30.1%;2 开头 18.0%,理论 17.6%;3 开头实测 12.5%,理论也是 12.5%,一分不差。九位算下来,真实数据对理论值的平均绝对偏差只有 0.46 个百分点。而人造数据那一列简直惨不忍睹:1 开头只有 11.2%,跟理论的 30.1% 差了将近三倍;9 开头反而高达 11.6%,是理论值 4.6% 的两倍多。平均绝对偏差 5.97 个百分点,是真实数据的 13 倍。
最有冲击力的还是数字 1 那一行。本福特说自然数据里约三成数字以 1 开头,我的模拟数据实测 29.2%,稳稳落在预期内;人造数据只有 11.2%,几乎正好是均匀分布该有的水平。这意味着那个造假者哪怕只是"凭感觉"编数,他脑中的"随机"就是均匀分布,而均匀分布恰恰是本福特定律的反面。那条假的录用信里如果全是这种首位数字均匀铺开的金额,一个二十行的脚本就能把它揪出来。
反直觉发现与实验的局限
翻车点得老实交代。我这条"真实数据"本质上是乘性随机游走,而数学上可以证明,这类跨数量级的对数空间随机过程天然收敛到本福特分布——所以 0.46 个百分点的贴合,某种程度上是"用本福特的亲儿子去验证本福特",赢赢得不太光彩。真正有说服力的验证应该拿现实数据集来做,比如某市十年的水电账单、维基百科的文件大小列表。模拟只能证明定律的机制成立,不能证明它对一切现实数据都成立。
另一个反直觉的地方在人造数据自己身上。我本来以为均匀取整会让首位数字精确地各占 11.1%,结果 1 开头是 11.2%,2 是 11.5%,7 是 11.8%,并不完全平。想了一会才明白:取值范围是 1000 到 99999,其中 10000 到 99999 占了绝对多数且首位均匀,但剩下的 1000 到 9999 这九千个数全部以 1 开头,给数字 1 悄悄加了一票。这提醒我,即便是"造假",取值区间的边界也会在首位分布上留下指纹——造假的破绽不只在"太均匀",也可能在"某个数字莫名偏高"。
还有一个必须戳破的幻想:这套方法防不住高水平的造假者。对方只要在 log10 空间里均匀取数再取幂,首位分布就能精确复刻本福特,我的检测指标会给出和真实数据一样漂亮的 0.46。本福特定律筛的是懒惰的造假,不是全部的造假。它该用在初审环节,跟交叉核对、业务逻辑校验配合使用,而不是当成一锤定音的测谎仪。
我的结论
动手测完,我服了,但服得有条件。在定律宣称的适用场景——跨数量级、乘性增长的正数——里,本福特定律的预测精度出乎意料地好:3000 条样本下,九个首位数字的平均绝对偏差仅 0.46 个百分点,而朴素均匀随机数的偏差是 5.97 个百分点,数字 1 的占比更是 29.2% 对 11.2% 的悬殊。这个区分度足够把"编出来的随机"和"长出来的自然"一刀切开。
给你的具体建议:下次拿到一列金额、销量、流量数据,别急着上复杂的异常检测模型,先用一行 `Counter(int(str(int(v))[0]) for v in data)` 统计首位分布,跟 log10(1+1/d) 的理论值对一眼。首位 1 的占比如果掉到 15% 以下,这份数据的可信度就该打个问号。至于那个收到假录用信的倒霉蛋——下次先跑一遍这个检查,再决定要不要回复 HR。



