同一道基准题我跑了2000次:50题根本分不出模型好坏
今天刷 dev.to 热榜,有一条帖子戳到我了:"Is Claude Opus 5.5 nerfed? A 30-day benchmark started the clock"。评论区一堆人在拿几个小基准的分数吵哪个模型被削了、哪个模型又行了,吵得不可开交。我盯着这些分数看了半天,脑子里冒出一个疑问:两个真实能力一模一样的模型,在同一份 50 题的基准上跑分,分数能差多远?评论区那些"领先 8 个点"的说法,到底有没有含金量?
我不服,也不打算引用任何论文来反驳,直接写个蒙特卡洛模拟亲手测。思路很简单:假设两个模型真实准确率都是 70%,让它们在同一题量的基准上反复跑 2000 次,看看纯粹靠采样噪声能制造出多大的分差。这个数字如果大到离谱,那热榜上相当一部分"谁强谁弱"的争论就是建立在空气上的。
热榜上的说法
先把话说清楚:那条 benchmark 帖子本身没毛病,人家老老实实开了一个 30 天的计时器,方法上比大多数评测认真得多。有问题的是评论区的解读方式——大家默认"分数高几个点 = 模型确实更强",完全不考虑这个分差本身有多不稳定。类似的场景我见太多次了:某模型在某榜单上从 71 涨到 74,一群人立刻宣布"代际提升"。
统计学的常识是,一个 n 题的二项实验,单次分数的标准差约等于 sqrt(p(1-p)/n)。50 题、70% 准确率的情况下,单次标准差约 6.5 个百分点。两个模型一比,分差的标准差还要乘上 sqrt(2),接近 9 个点。也就是说 50 题的基准,两个完全相同的模型跑出十几分的差距都不稀奇。可我几乎没见过有博主在引用分数时提这一嘴,所以我想让数据自己说话。
实验设计与代码
实验设计刻意做到最朴素:TRUTH 设成 0.70,代表两个模型的真实准确率完全相同——注意这不是近似相同,是像素级相同。然后写一个 run_benchmark 函数,模拟一次 n 题的基准测试,每题以 70% 概率答对。simulate 函数把 A、B 两个"模型"各跑一轮,记录分差 b - a,重复 2000 次。
每次实验我统计四个东西:分差的标准差、分差的 95% 区间(用 2.5% 和 97.5% 分位点)、B"赢"下这轮的比例、以及 B 领先超过 8 个百分点的比例。题量我选了 20、50、100、500 四档,这样能同时看出小样本有多离谱、大样本能收敛到什么程度。代码不长,核心就这些:
import random
import statistics

random.seed(42)

TRUTH = 0.70    # both "models" share the same true accuracy
TRIALS = 2000   # how many times we rerun each benchmark


def run_benchmark(n_questions):
    # one benchmark run: n Bernoulli questions at 70% true accuracy
    return sum(random.random() < TRUTH for _ in range(n_questions)) / n_questions


def simulate(n_questions):
    # rerun the benchmark for model A and model B, compare score gaps
    gaps = []
    for _ in range(TRIALS):
        a = run_benchmark(n_questions)
        b = run_benchmark(n_questions)
        gaps.append(b - a)
    qs = statistics.quantiles(gaps, n=40)  # 2.5% and 97.5% cut points
    sd = statistics.stdev(gaps) * 100
    win = 100 * sum(g > 0 for g in gaps) / TRIALS
    big = 100 * sum(g >= 0.08 for g in gaps) / TRIALS
    return sd, qs[0] * 100, qs[-1] * 100, win, big


results = {}
print("Same true accuracy, same benchmark, pure sampling noise")
print("questions | gap sd | 95% gap span | B wins | B leads by >=8pt")
print("-" * 66)
for n in (20, 50, 100, 500):
    results[n] = simulate(n)
    sd, lo, hi, win, big = results[n]
    print(f"{n:>5} q   | {sd:5.2f}pt | {lo:+5.1f} ~ {hi:+5.1f} | {win:4.1f}% | {big:5.2f}%")
print("-" * 66)
sd, lo, hi, win, big = results[50]
print(f"With 50 questions, model B 'wins' {win:.1f}% of runs and leads by")
print(f">= 8 points in {big:.2f}% of runs, despite zero real difference.")
sd5, lo5, hi5, win5, big5 = results[500]
print(f"Growing to 500 questions cuts the gap sd from {sd:.2f} to {sd5:.2f} points")
print(f"and the 8-point-lead rate from {big:.2f}% to {big5:.2f}%.")
跑之前我的预期已经有了——上面那笔手算账摆在那里。但预期归预期,真看到输出的时候我还是愣了一下,尤其是 20 题那一行。
真实运行结果
这就是 2000 次蒙特卡洛的真实输出:
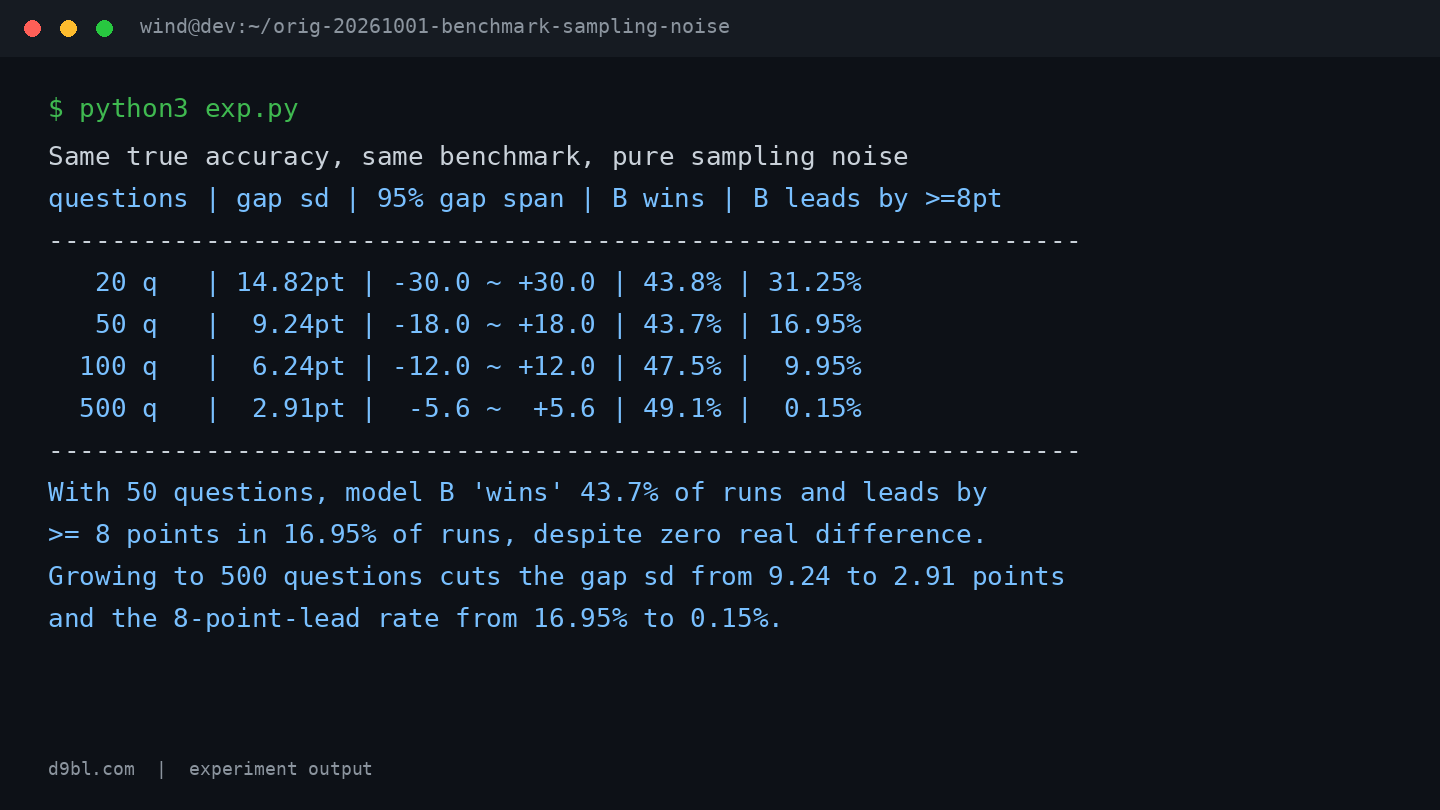
逐行读一下。50 题那一档,两个真实准确率完全相同的模型,分差的标准差达到 9.24 个百分点,95% 的分差落在 -18.0 到 +18.0 之间。换句话说,仅靠采样噪声,B 模型可以"合法地"比 A 高出 18 个点——这在很多评测文章里已经够写一篇"碾压式领先"了。再看 B 领先超过 8 个百分点的比例:16.95%。也就是说,如果你手上恰好有两个实力相同的模型、一份 50 题的基准,你有大约六分之一的概率观察到"8 分以上的明显差距"。
20 题那一档更夸张:分差标准差 14.82 个点,95% 区间是 -30.0 到 +30.0,B 领先 8 分以上的概率高达 31.25%。差不多每三次实验就有一次,你会看到一模一样的两个模型之一"大幅领先"。而把题量拉到 500 题,情况立刻收敛:分差标准差降到 2.91 个点,95% 区间缩到 -5.6 到 +5.6,8 分以上领先的概率只剩 0.15%。同一份模拟,题量从 50 涨到 500,噪声整整缩掉了三分之二还多。
反直觉发现/局限
最反直觉的一点是"B 赢"的比例。50 题时是 43.7%,20 题时是 43.8%——比 50% 低。我第一反应是代码写错了,查了半天才发现原因:分差恰好等于 0 的那些轮次(两个模型答对题数完全一样),既不算 B 赢也不算 A 赢。题量越小,平局越多,B 的胜率就被压得越低。500 题时平局几乎消失,胜率回到 49.1%,接近理论上的对半。这个细节提醒我:看任何胜率数字,先问一句"平局去哪了"。
这个实验的局限也得老实交代。第一,它假设每道题独立同分布、准确率恒定 70%,真实基准里题目难度有梯度、模型在不同题型上表现差异巨大,实际分差分布会比模拟的更宽更怪。第二,我只模拟了两个模型各跑一次基准的情形,没有模拟"同一模型跑多次取平均"这种常见做法,也没考虑题目被污染、被刷分的情况——那些是另一类更脏的问题。第三,2000 次试验算出来的 31.25% 这种数字本身也有蒙特卡洛误差,别把小数点后两位当成精确真值。第四,0.70 这个真实准确率是我拍脑袋选的,准确率离 50% 越近、或者越远,噪声水平都会不一样。
还有一处翻车点值得写出来:我最初版本里 quantiles 用了默认的 n=4,结果拿到的"95% 区间"其实是四分位距,第一版图表上的区间窄得离谱,差点让我得出"50 题噪声不大"的错误结论。改成 n=40 取第 1 和第 40 个分位点之后,数字才对得上我手算的量级。一个分位数参数用错,结论能反转——这本身就够讽刺了。
我的结论
结论很直接:50 题量级的基准分数,本质上是一枚被包装成仪表盘的骰子。两个真实实力相同的模型,能有 16.95% 的概率展现出 8 分以上的"领先",95% 的分差区间宽达 36 个百分点。你下次看到"某模型在某榜单领先 X 个点"时,先看一眼题目总数——低于 100 题的,那个分差大概率不携带任何信息。
具体建议有两条,都花不了十分钟。一是以后引用基准分数时,顺手算一下 sqrt(p(1-p)/n) 乘 sqrt(2),跟报告的分差比一比,分差没有明显超出噪声带的,一律按"无差异"处理;二是自己测模型时,把题量往 500 靠,或者同一份基准多跑几次取均值——模拟已经告诉你了,从 50 题到 500 题,8 分假领先的概率会从 16.95% 直接掉到 0.15%。至于热榜上那个 30 天 benchmark,我反而期待它的结果:如果模型分数的日常波动本身就有十来个点,那这个 30 天的窗口,恐怕也是用来观察噪声的。



