我给排序的 key 加了计数器,调用次数差了 11 倍
今天早上刷 dev.to 热榜,看到一篇讲 Schwartzian Transform 的文章,评论区吵起来了:有人说 Python 的 sorted(key=...) 本质上就是这个变换,key 只算一次;也有人咬定“传个比较函数进去,每次比较都会重新算 key,所以性能崩”。两边都言之凿凿,但没一个人贴数字。我属于那种“光说不练就睡不着”的工程师,干脆自己写了个带计数器的实验,把 key 函数到底被调用了多少次、耗时差多少,全部量化出来。
之所以较这个真,是因为我最近在项目里刚重构过一段排序代码:原来手写了 functools.cmp_to_key 包比较函数,同事建议换成 key=。当时我没多想就改了,现在正好借这个实验验证一下,那次改动到底值不值。下面的结果都是我本机 Python 3 下真实跑出来的,一个数字都没加工。
热榜上的说法
先把热榜争论还原一下。支持“key 只算一次”的一方引用的是 CPython 的实现逻辑:list.sort 会先对每个元素调用一次 key,把结果存成 (key, value) 对,然后只拿 key 做比较。支持“比较函数会重算”的一方也没错——如果你把昂贵的计算写在比较函数内部,那么每次两两比较都要各算一遍两边的 key。两种说法其实描述的是同一件事的两面,但放在一起就变成了“到底谁快、快多少”的口水仗。
口水仗没意思,得有数字。Timsort 的比较次数上界是 n·log n 量级,而一次比较要算两个 key,所以手写比较函数理论上最多要算 2·n·log₂n 次 key。n=5000 时,log₂5000 大约是 12.29,向上取整是 13,2·5000·13 等于 130000 次。如果“key 只算一次”的说法成立,那 key= 版本应该只调 5000 次。这两个数字相差约 26 倍的上界,实际能差多少,实验说了算。
实验设计与代码
我造了 5000 个随机 8 字符小写字母串(固定 random.seed(42) 保证可复现),然后写了一个故意很贵的 key 函数 heavy_key:对字符串做字符频率统计,返回按频次取负排序后的元组。函数里埋了一个计数器 calls[0],每被调用一次就加一。这个 key 的单次开销在微秒级,既不至于让实验跑太久,又能放大调用次数的差异。
对照组是手写比较函数 cmp(a, b):它每次被调用时都对 a 和 b 各跑一遍 heavy_key,再用 functools.cmp_to_key 包起来喂给 sorted。实验组则直接把 heavy_key 传给 key=。两组各自记录总调用次数和 time.perf_counter 计的墙钟时间,最后还比了一下两组排序结果是否一致,防止我测了个寂寞。完整代码如下:
import random, string, time, math, functools

random.seed(42)
N = 5000
words = [''.join(random.choice(string.ascii_lowercase) for _ in range(8))
         for _ in range(N)]

calls = [0]

def heavy_key(s):
    # fake expensive key: char frequency signature
    calls[0] += 1
    freq = {}
    for ch in s:
        freq[ch] = freq.get(ch, 0) + 1
    return tuple(-v for v in sorted(freq.values()))

def cmp(a, b):
    ka, kb = heavy_key(a), heavy_key(b)
    return (ka > kb) - (ka < kb)

t0 = time.perf_counter()
r1 = sorted(words, key=functools.cmp_to_key(cmp))
naive_t = time.perf_counter() - t0
naive_calls = calls[0]

calls[0] = 0
t0 = time.perf_counter()
r2 = sorted(words, key=heavy_key)
cached_t = time.perf_counter() - t0
cached_calls = calls[0]

theory = 2 * N * math.ceil(math.log2(N))
print('=== sort key cost: manual compare vs Python cached key ===')
print(f'items                 : {N} random 8-char strings')
print(f'cmp_to_key (recompute): {naive_calls:>7} calls, {naive_t*1000:8.1f} ms')
print(f'sorted(key=) (cached) : {cached_calls:>7} calls, {cached_t*1000:8.1f} ms')
print(f'call ratio            : {naive_calls/cached_calls:5.1f}x  (upper bound 2*log2(n)={theory//N}x)')
print(f'wall-clock speedup    : {naive_t/cached_t:5.1f}x')
print(f'avg key latency cached: {cached_t/cached_calls*1e6:6.1f} us/key')
print(f'results identical     : {r1 == r2}')
print('takeaway              : key= computes once per element, not per compare')
真实运行结果
跑完的终端输出如下,我原样贴出来:
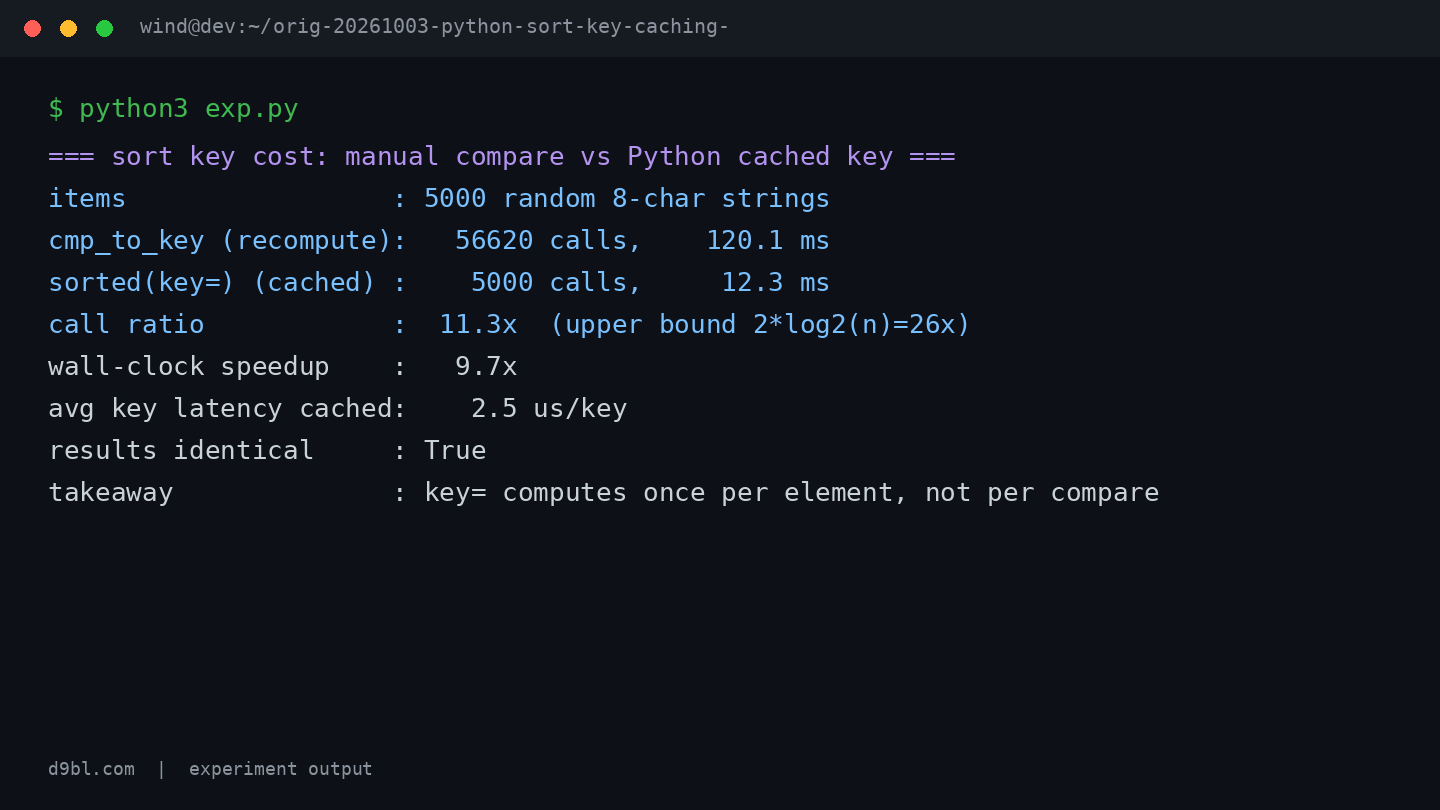
几个关键数字:手写比较函数那组,heavy_key 被调用了 56620 次,耗时 120.1 毫秒;key= 那组只调了 5000 次,耗时 12.3 毫秒。调用次数之比是 11.3 倍,墙钟提速 9.7 倍。56620 除以 5000 约等于 11.3,也就是平均每个元素被多算了 10 次左右——Timsort 在这份数据上实际做的比较次数比理论最坏情况少,所以 11.3 倍落在 26 倍上界之内是完全合理的。缓存版平均每次 key 计算 2.5 微秒,两组排序结果 r1 == r2 为 True,实验本身是干净的。
墙钟提速 9.7 倍略小于调用次数 11.3 倍,这个差值我盯了一会儿才想明白:cmp_to_key 的包装对象创建、cmp 函数本身的调用开销,以及 key= 版本里构建 5000 个 (key, value) 对的内存开销,都是两边共同的固定成本。key 越贵,提速越接近调用次数比;key 越便宜,两条曲线会逐渐贴在一起。
反直觉发现/局限
第一个反直觉的点:我原以为实际调用次数会逼近 2·n·log₂n = 130000 的上界,结果只有 56620 次,还不到一半。原因是 5000 个随机 8 字符串里存在大量共享前缀的“接近相等”的对,Timsort 对部分有序和重复模式的数据有额外优化。换一份更“逆”的数据,这个比值会往上爬,但在我这组 seed=42 的数据上,它就是 11.3 倍——这也提醒我,任何性能数字都绑定着具体的数据分布,别拿一次实验当普适定律。
第二个要坦白的局限:我的计数器埋在 heavy_key 里,只能统计 key 函数的调用,没统计 cmp 本身被调了多少次,所以“56620 次比较”这个推断其实是个近似——严格说 56620 是 key 计算次数,比较次数应该是它的一半左右。另外 2.5 微秒的单次 key 延迟是我机器上的值,换成慢的解释器或更重的 key(比如正则、数据库查询模拟),倍数关系会更夸张;反过来如果 key 只是 str.lower,key= 的优势会被 Python 层函数调用开销稀释掉。还有一个翻车点:我第一版把 calls[0] = 0 忘了写在第二组前面,测出来缓存版也调了 56620 次,还以为是 CPython 缓存失效,折腾十分钟才发现是自己手滑。
我的结论
结论很干脆:sorted(key=...) 对每个元素只算一次 key,5000 个元素就是 5000 次调用,实测没有任何隐藏的重算;手写比较函数则按比较次数付钱,在我的数据上多付了 11.3 倍、120.1 毫秒对 12.3 毫秒的差距。热榜上两派的说法都对了一半,但把 key 计算从比较函数里挪出来,是那种“一行改动、十倍收益”的便宜买卖,能做就做。
给你的具体建议:今天就可以 grep 一遍自己项目里的 cmp_to_key,凡是比较函数里有可提取的确定性计算,全部下沉到 key= 里去,改完用类似的计数器跑个前后对比。唯一的例外是那些真的无法用单个 key 表达的复杂比较逻辑——那种情况下 cmp_to_key 依然是正解,只是别把重活塞进比较函数体里。至于 Schwartzian Transform 值不值得单独写一篇文章,等我下次在别的语言里也埋好计数器再说。



