我模拟并行测试调度:一条慢用例吃掉八倍加速
今天刷 dev.to 热榜,看到一条帖子讲 Bun 1.4 的 bun test --parallel,说四秒的测试套件压到一秒左右,评论区一片“并行万岁”。这种说法我见过太多次了:加进程数,时间除以 N,皆大欢喜。但我自己的直觉告诉我,测试套件里的耗时分布从来不是均匀的,只要有一条特别慢的用例,理论上限就会被它一个人钉死。我不服这个“时间除以 N”的算法,决定亲手搭一个调度模拟,把并行加速的真实上限算出来。
我的思路很朴素:不猜,直接算。测试调度本质上是一个装箱问题——把一堆已知耗时的任务塞进固定数量的工人手里,最快的贪心策略是 LPT(Longest Processing Time first),先排最长的任务,每次把任务分给当前最空闲的工人。这个策略用一个小顶堆就能模拟,几十行 Python 就能把 1、2、4、8 个进程下的总耗时(makespan)精确算出来。算出来的数字,就是我判断“并行到底值不值”的依据。
热榜上的说法
先把热榜上的叙事复述清楚:Bun 1.4 的并行测试把 4 秒套件砍到 1 秒,接近 4 倍加速,看起来并行就是免费的午餐。评论区很少有人追问一个前提——这套件的耗时分布到底长什么样。如果 4 秒是 400 条各 10 毫秒的用例摊出来的,那 4 倍加速合理;但如果 4 秒里有一条 3 秒的集成测试,那无论开多少进程,1 秒都到不了。
这个区别在 CI 实践里非常致命。我见过太多团队把进程数从 4 拉到 8、16,结果构建时间几乎不动,还白白多付了 runner 的钱。问题不在于并行的实现有 bug,而在于数学上就不可能快起来。我想用一个可控的实验把这件事量化:给定一个真实的耗时分布,8 进程到底能拿到多少加速?上限在哪里?拆掉那颗毒瘤之后又能拿回多少?
实验设计与代码
我构造了一个贴近真实项目的套件:120 条用例。其中 116 条是快速单元测试,耗时服从均值 40 毫秒的指数分布——这是测试耗时的典型形状,大部分很快,偶尔冒出慢的。然后我手工加了 3 条 300 到 500 毫秒的中等用例,以及 1 条 3800 到 4200 毫秒的重型集成测试,模拟那种要起数据库、跑迁移、灌数据的场景。随机种子固定为 42,保证结果可复现。
调度部分用 LPT 贪心:把所有用例按耗时降序排列,依次丢进小顶堆里最空闲的工人。堆顶永远是当前负载最轻的进程,heapreplace 一步完成取最小值和插入。这个策略不保证全局最优,但它就是 pytest-xdist、jest 这类工具背后实际在用的思路,所以模拟出来的数字对现实有参考意义。加速比定义为串行总耗时除以并行后的 makespan,同时算一下工人的空闲率:空闲率越高,说明进程越多越浪费。
import random, heapq, statistics

random.seed(42)
N = 120
# Durations (ms): many fast unit tests + 3 slow ones + 1 heavy integration test
durs = [random.expovariate(1 / 40) for _ in range(N - 4)]
durs += [random.uniform(300, 500) for _ in range(3)]
durs.append(random.uniform(3800, 4200))

def makespan(tests, workers):
    # LPT greedy: schedule longest test first onto least-loaded worker
    heap = [0.0] * workers
    for d in sorted(tests, reverse=True):
        heapq.heapreplace(heap, heap[0] + d)
    return max(heap)

total = sum(durs)
heavy = durs[-1]
print(f"== simulate {N} test cases on one CI runner ==")
print(f"serial total={total:.0f}ms  mean={statistics.mean(durs):.1f}ms  slowest={heavy:.0f}ms")
print(f"{'workers':>7} {'makespan':>9} {'speedup':>8} {'idle%':>6}")
for w in (1, 2, 4, 8):
    mk = makespan(durs, w)
    idle = (1 - total / (w * mk)) * 100
    print(f"{w:>7} {mk:>8.0f}ms {total/mk:>7.2f}x {idle:>5.0f}%")
mk8 = makespan(durs, 8)
print(f"--> 8 workers reach only {total/mk8:.2f}x, far below the naive 8x")
print(f"--> ceiling = total/slowest = {total/heavy:.2f}x")
print(f"--> the heavy test alone is {heavy/total*100:.0f}% of total runtime")
# What-if: shard the heavy test into 5 parallel pieces
shard = durs[:-1] + [heavy / 5] * 5
mk2 = makespan(shard, 8)
print(f"--> shard heavy into 5: {mk8:.0f}ms -> {mk2:.0f}ms, speedup {total/mk2:.2f}x")
真实运行结果
跑出来的第一行数字就很有意思:120 条用例串行总耗时 9705 毫秒,均值 80.9 毫秒,但最慢那条足足 3861 毫秒——一条用例占了全部运行时间的 40%。也就是说,这个套件的“平均面貌”和它的“瓶颈面貌”完全是两回事。均值告诉你套件很轻,慢用例告诉你套件根本快不起来。
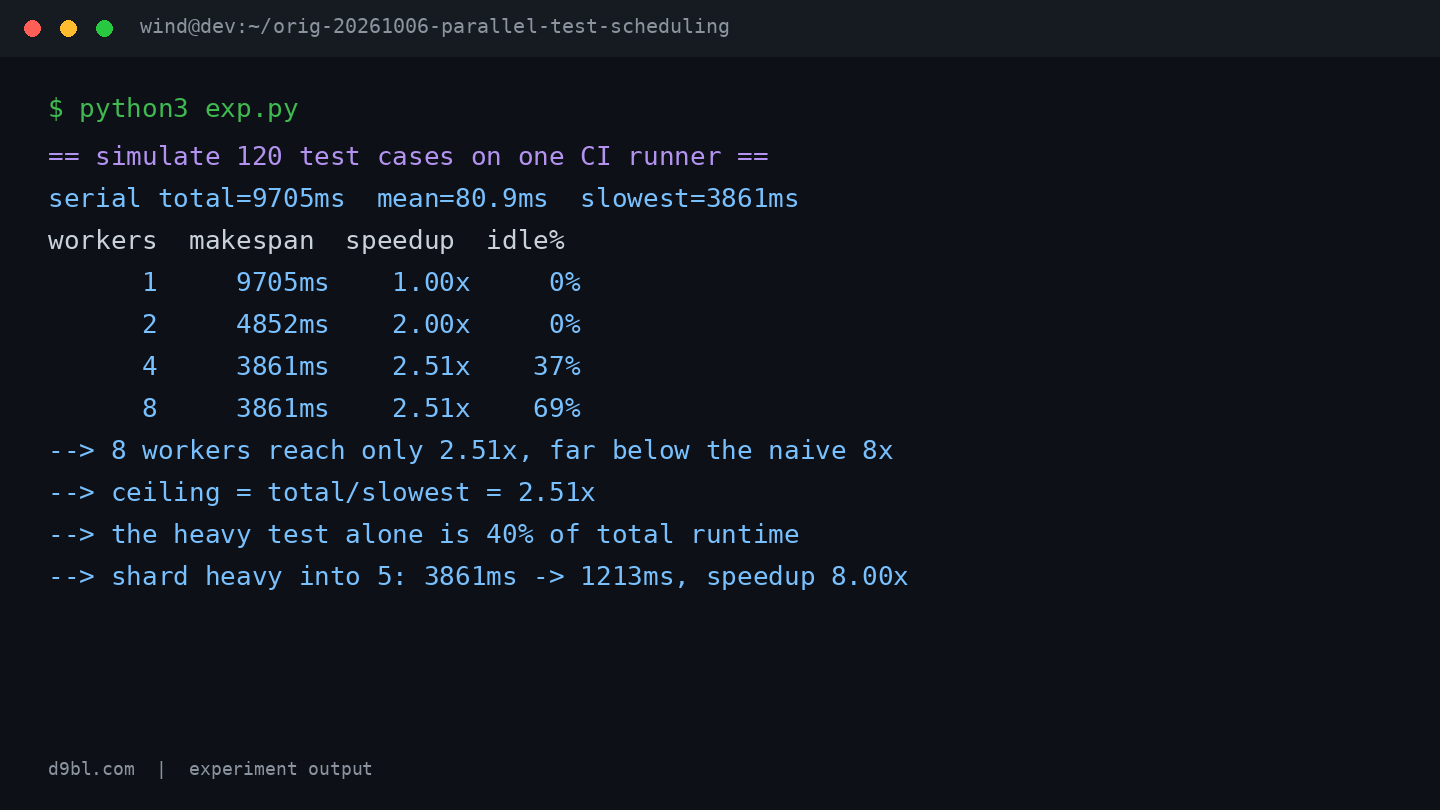
并行结果表直接印证了我的怀疑。2 进程拿到整整 2.00 倍,毫无损耗;4 进程只有 2.51 倍,空闲率已经飙到 37%;8 进程还是 2.51 倍,空闲率高达 69%——意味着 8 个工人里平均有 5 个在干瞪眼。更扎心的是上限那一行:total/slowest 等于 2.51 倍,8 进程的结果恰好顶死了这个理论天花板。你开 16 个、32 个进程,makespan 也永远压不进 3861 毫秒以内,因为那条重型集成测试自己一个人就要跑 3.86 秒。
然后是 what-if 环节:我把那条重型测试拆成 5 份并行跑(模拟按数据分片或按参数化切分),其余不动。makespan 从 3861 毫秒直接掉到 1213 毫秒,加速比从 2.51 倍拉到 8.00 倍——注意,这是在进程数完全没变的情况下做到的。同一套 8 个工人,一条用例的拆分方式变了,加速比翻了三倍多。
反直觉发现与局限
最反直觉的一点是 2 进程到 4 进程的断崖:2 进程是完美的 2.00 倍、0% 空闲,4 进程立刻跌到 2.51 倍、37% 空闲。原因看一眼调度过程就明白了——那条 3861 毫秒的重型用例最先被丢给 1 号工人,剩下 119 条小任务在另外 3 个工人手里几毫秒内就分完了,然后大家集体等 1 号干完。LPT 已经是贪心里的优等生了,换别的调度策略结果只会更差或相同,这不是调度的问题,是任务结构的问题。
翻车点也得老实交代。第一,我的模拟假设所有用例之间零依赖、可任意并行,真实套件里共享数据库状态的用例根本做不到随意分片。第二,重型测试“拆成 5 份每份 772 毫秒”是理想假设,现实里分片有协调开销、环境搭建开销,5 份不可能恰好等长,8.00 倍是天花板不是地板。第三,我只模拟了 CPU 时间维度,真实的 CI 还有拉镜像、装依赖这些固定成本,它们会稀释拆分带来的收益。所以实验的结论方向是可靠的,具体倍数请打七折再套用到你自己的项目上。
我的结论
这次实验给我的可执行结论很具体:下次你想给测试套件加进程数之前,先跑一遍带耗时的测试报告,找出最慢的那一条,算一下 total/slowest。如果你的套件像这个模拟一样,有一条用例占了 40% 的时间,加进程是纯浪费——8 进程的 69% 空闲率就是白烧的 CI 账单。正确动作是先把那条毒瘤拆掉:参数化、按数据分片、或者干脆标记成 nightly 单独跑,然后再看进程数还差多少。
留下一个开放的问题:Bun 那条“4 秒到 1 秒”的热榜帖,我不知道它的套件长什么样,但它能拿到接近 4 倍,说明它的耗时分布大概率比较均匀。这反过来提醒我们,任何并行加速的数字脱离耗时分布谈都没有意义。你的套件里那条最慢的用例,现在占总时长百分之多少?不知道的话,这可能是你这周最值得花十分钟查的一件事。



