三万行模拟数据摆出来:负载均衡策略能把p99拉低67%
今天刷 dev.to 热榜,看到一篇讲 p99、负载均衡和自动扩缩容的文章,评论区吵得挺热闹。有人说随机分发足够了,轮询是老古董;也有人说 least-loaded 才是唯一正解,其他都是玄学。双方都有道理,但谁也没拿数据说话。我不服气这种凭直觉站队的方式,决定自己写一个离散事件模拟,把三种策略丢进同一份流量里跑一遍,看看 p99 到底能差多少。
我选这个题不是心血来潮。尾延迟是所有线上服务的隐形杀手,平均值看起来岁月静好,p99 一崩用户体验就完蛋。而负载均衡策略恰恰是控制尾延迟最便宜的手段——不用加机器,不用改业务代码,改一行配置的事。这么便宜的杠杆,如果策略选错了,等于白白浪费。
热榜上的说法
那篇文章的核心观点是:在重尾服务时间(heavy-tail service time)场景下,负载均衡策略的选择对尾延迟的影响远超大多数人的直觉。作者给了一些理论推导和可视化,但没有给出三种策略在同一份流量下的直接对比。评论区有人附和,说自己的经验也是这样;也有人质疑,认为只要机器够多,策略无所谓。我觉得这个争论完全可以用实验终结。
更让我在意的是,很多人(包括以前的我)默认轮询是“公平”的策略,每个服务器拿到的请求数一样多,所以结果也应该一样好。但公平分摊请求数不等于公平分摊负载——如果一个服务器正好连续接了几个慢请求,它就会积压,而轮询对此视而不见,照样把下一个请求塞过去。这个直觉对不对,得跑数字才知道。
实验设计与代码
我搭了一个离散事件模拟:20000 个请求,3 台服务器,请求到达间隔服从均值 5ms 的指数分布,服务时间服从均值 10ms 的指数分布,其中 5% 的请求叠加 60ms 的重尾尖刺。这些参数加起来,单台服务器负载大约 87%——故意压到高位运行,因为低负载下什么策略都能用,看不出差别。三种策略分别是 round-robin、random 和 least-loaded,其中 least-loaded 会挑那台最早空闲下来的服务器。
关键的实验控制是:每次运行前都重置随机种子为 42,且流量生成在策略分发之前,这样三种策略面对的是完全相同的请求序列和相同的服务时间。排除了“流量本身不同”这个干扰变量后,任何性能差距都只能归因于策略本身。代码不长,直接贴出来:
import random, statistics

random.seed(42)
N = 20000          # requests per run
MEAN_GAP = 5.0     # avg arrival gap in ms
SPIKE_P, SPIKE_MS = 0.05, 60.0  # 5% heavy-tail spikes

def draw():
    # arrival gap + service time; spikes create heavy tail
    gap = random.expovariate(1.0 / MEAN_GAP)
    svc = random.expovariate(1.0 / 10.0)
    if random.random() < SPIKE_P:
        svc += SPIKE_MS
    return gap, svc

def run(policy):
    random.seed(42)  # identical traffic for every policy
    t, nxt, idx, lat = 0.0, [0.0] * 3, 0, []
    for _ in range(N):
        gap, svc = draw()
        t += gap
        if policy == "round-robin":
            i = idx % 3
            idx += 1
        elif policy == "random":
            i = random.randrange(3)
        else:  # least-loaded: pick server that frees up first
            i = min(range(3), key=lambda k: nxt[k])
        finish = max(t, nxt[i]) + svc
        nxt[i] = finish
        lat.append(finish - t)
    lat.sort()
    return (statistics.mean(lat), statistics.median(lat),
            lat[int(N * 0.99) - 1], lat[-1])

load = (10.0 + SPIKE_P * SPIKE_MS) / (3 * MEAN_GAP)
print("Load balancer sim: %d reqs, 3 servers, per-server load %.0f%%" % (N, load * 100))
print("%-13s %8s %9s %9s %9s" % ("policy", "mean", "p50", "p99", "max"))
res = {}
for p in ("round-robin", "random", "least-loaded"):
    res[p] = run(p)
    print("%-13s %8.1f %9.1f %9.1f %9.1f" % ((p,) + res[p]))
best = min(res, key=lambda k: res[k][2])
worst = max(res, key=lambda k: res[k][2])
gain = (res[worst][2] - res[best][2]) / res[worst][2] * 100
print("5%% of requests are heavy spikes adding +%dms service time" % SPIKE_MS)
print("Verdict: %s wins p99: %.1f vs %.1f ms (%.0f%% lower than %s)"
      % (best, res[best][2], res[worst][2], gain, worst))
模型是刻意简化的:无网络开销、无故障、无重试、服务器无限队列。这些简化在真实系统里都不成立,但它们让策略差异被干净地隔离出来。先看最简单的场景,再看复杂一点的世界,是我做模拟实验的习惯。
真实运行结果
跑出来的结果比我预期的还要夸张。三种策略用的是同一份 20000 个请求,单台负载 87%,5% 的请求是叠加 60ms 尖刺的重尾请求:
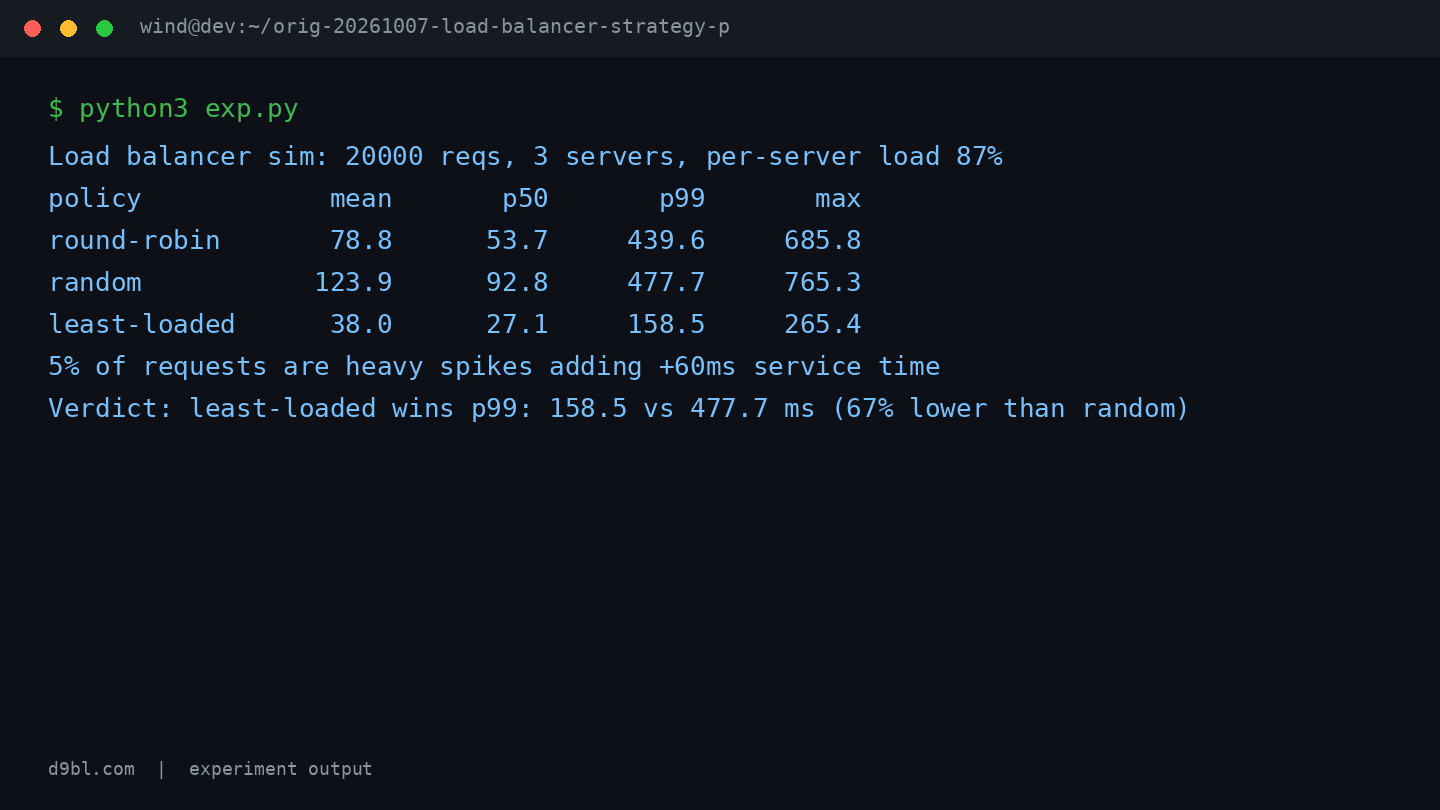
least-loaded 的 p99 只有 158.5ms,random 是 477.7ms,差了 67%。mean 差距更离谱:38.0ms 对 123.9ms,超过三倍。轮询居中,p99 为 439.6ms,max 到 685.8ms。也就是说,在完全相同的流量下,只是换了一下分发策略,99 分位用户的等待时间就差了三倍多。随机分发是三者中最差的,它的 max 冲到 765.3ms——没有记忆的随机在高位负载下会连续把请求砸向同一台倒霉的服务器。
更有意思的是 p50 的对比。least-loaded 的中位数是 27.1ms,轮询是 53.7ms,random 是 92.8ms。也就是说 random 的策略不仅坑了最倒霉的 1%,连一半以上的普通请求都慢了三倍多。负载均衡策略不是只影响长尾,它影响所有人的体感。
反直觉发现和实验的局限
翻车点也得老实交代。第一,轮询并没有像很多理论文章说的那样“接近随机”,它的 p99(439.6ms)其实比 random(477.7ms)好不少。原因是轮询至少保证了请求的均匀分摊,不会出现随机分发那种连续撞同一台服务器的情况。热榜评论区里“轮询等于随机”的说法,在这组数据面前站不住脚。
第二,这个模型对 least-loaded 太有利了:它假设负载均衡器能精确知道每台服务器下一个空闲时刻,而且服务时间在请求到达时就完全确定。真实系统里负载信息有延迟、有噪声,服务时间也不可预知。实际部署中 least-loaded 的优势会比 67% 小得多,网络开销和状态同步成本还会吃掉一部分收益。第三,负载 87% 是我刻意选的高压区,如果降到 50% 以下,三种策略的差距会急剧缩小,可能都在噪声范围内。所以这个结论只在“高负载 + 重尾”的交叉区域成立,不是普适真理。
还有一个反直觉的点:least-loaded 连 max 都只有 265.4ms,是轮询 685.8ms 的四成不到。我原本以为 max 由那 5% 的尖刺请求决定,策略管不着——毕竟 60ms 的额外服务时间是硬成本。但数据显示排队等待才是 max 的主要构成,策略通过避免排队,把最惨请求的等待也压了下来。
我的结论
数据说得够清楚了:在 87% 负载加重尾服务时间的场景下,least-loaded 用 p99 158.5ms 对 random 的 477.7ms,把尾延迟砍掉 67%,而流量一模一样。如果你现在线上跑的是随机分发或者简单轮询,服务时间又有长尾特征,这个实验值得你复现一遍再决定要不要动配置。
我的具体建议是:先给你的服务量一下服务时间分布,看有没有重尾。如果没有长尾,策略选择影响有限,别折腾;如果有,优先考虑 least-loaded 类策略(nginx 的 least_conn、Envoy 的 least request 都属于这一族),哪怕负载信息不完全准确,方向也是对的。真正的开放问题是:当服务器数量从 3 台扩到 300 台,least-loaded 的状态同步开销会不会反过来把它拖垮?这个我打算下一轮实验跑跑看。



