指数退避真的更划算吗?我写了个模拟器亲手测了一遍
今天刷 dev.to 热榜,看到一篇《To Retry or Not to Retry? That Is the Question.》排在前列,评论区一边倒地推荐“重试就用指数退避加抖动,教科书答案”。这话我听过不下一百遍,但我心里一直有个疙瘩:指数退避的优势到底来自哪里?如果服务挂掉是一个时间窗口问题,那退避策略的本质不就是在赌“下一刀会不会落在窗口里”吗?赌局的具体赔率,好像从来没人算给我看过。
我不服,所以我决定亲手测。与其引用论文里的排队论模型,不如写一个最朴素的模拟器:造一个带随机故障窗口的假服务,把三种策略丢进去跑一万次请求,把成功率和延迟摆在一起看。答案可能出乎意料,也可能印证直觉,但至少这次是我自己算出来的。
热榜上的说法
那篇热榜文章的核心观点很典型:网络调用天然不可靠,所以必须重试;固定间隔重试会造成“重试风暴”,大家挤在同一时刻冲击服务;指数退避让重试在时间上摊开,是生产环境的标配。这套论述我几乎能背下来,它的问题在于所有论据都是定性的——没人告诉你,摊开之后你到底付出了多少延迟,又换回了多少成功率。
评论区还有一条高赞留言说“固定间隔重试在任何正经系统里都是错的”。这种绝对化的判断让我更想验证了。如果一个策略在任何场景下都错,那它错得有多离谱?如果只是错一点点呢?工程决策的关键从来不是对错,而是差多少。差 0.1 个百分点和差 10 个百分点,对应的架构选择完全不同。
实验设计与代码
我搭的模型是这样的:服务每毫秒左右能处理一个请求,健康状态下仍有 1% 的随机失败率;除此之外,故障像泊松过程一样随机爆发,平均约 2 秒一次,每次持续 50 到 500 毫秒,服务在故障窗口内完全不可用。然后让 10000 个请求以每 5 毫秒一个的节奏到达,分别用三种策略处理:完全不重试、固定间隔 100 毫秒重试最多 4 次、指数退避(40 毫秒起步、翻倍、带 0.5 到 1.5 倍的抖动)重试最多 4 次。
核心代码不长,我原样贴在这里。模拟里我特意让“时间”真实流动——失败后请求不是立刻重试,而是在时间轴上跳到未来再试,这样故障窗口才能真实地“放过”或“卡住”某个重试请求:
import random, statistics

random.seed(42)
N, LAT, UP_FAIL = 10000, 20, 0.01  # requests, ms per-attempt latency, healthy fail rate

# Outage timeline: gaps ~2s (Poisson), each outage lasts 50-500 ms
outages, t = [], 0.0
for _ in range(300):
    t += random.expovariate(1 / 2000)
    outages.append((t, t + random.uniform(50, 500)))
WINDOW = 5.0 * (N - 1) + LAT
DOWN = sum(e - s for s, e in outages if s < WINDOW)
N_DOWN = sum(1 for s, e in outages if s < WINDOW)

pos = [0]
def down(now):
    if pos[0] >= len(outages):
        return False
    while pos[0] < len(outages) and outages[pos[0]][1] < now:
        pos[0] += 1
    if pos[0] >= len(outages):
        return False
    s, e = outages[pos[0]]
    return s <= now < e

def run(name, max_att, delay):
    pos[0] = 0
    ok, atts, times = 0, 0, []
    for k in range(N):
        arrive, att = 5.0 * k, 0
        while att < max_att:
            att += 1
            atts += 1
            fail = down(arrive) or random.random() < UP_FAIL
            if not fail:
                times.append(arrive + LAT - 5.0 * k)
                ok += 1
                break
            if att < max_att:
                arrive += LAT + delay(att)  # wait, then retry later in time

    p95 = sorted(times)[int(0.95 * len(times))]
    print(f"{name:<14}{ok / N * 100:>7.1f}%{atts / N:>9.2f}"
          f"{statistics.mean(times):>9.1f}{p95:>9.0f}")

strat = [
    ("no-retry", 1, lambda a: 0.0),
    ("fixed-100ms", 4, lambda a: 100.0),
    ("backoff-40ms", 4, lambda a: 40 * 2  (a - 1) * random.uniform(0.5, 1.5)),
]

print("Flaky-service retry sim: 10000 reqs, one per 5ms (seed=42)")
print(f"Outages in window: {N_DOWN}, down {DOWN / WINDOW * 100:.1f}% of the time")
print(f"{'strategy':<14}{'succ':>8}{'avg-att':>9}{'avg-ms':>9}{'p95-ms':>9}")
for name, m, d in strat:
    run(name, m, d)
种子固定在 42,保证三种策略跑在完全相同的故障时间线和随机失败序列上——这是公平对比的前提。我盯着三种指标:成功率、平均尝试次数、平均端到端延迟,外加 p95 延迟。
真实运行结果
跑出来的输出如下:
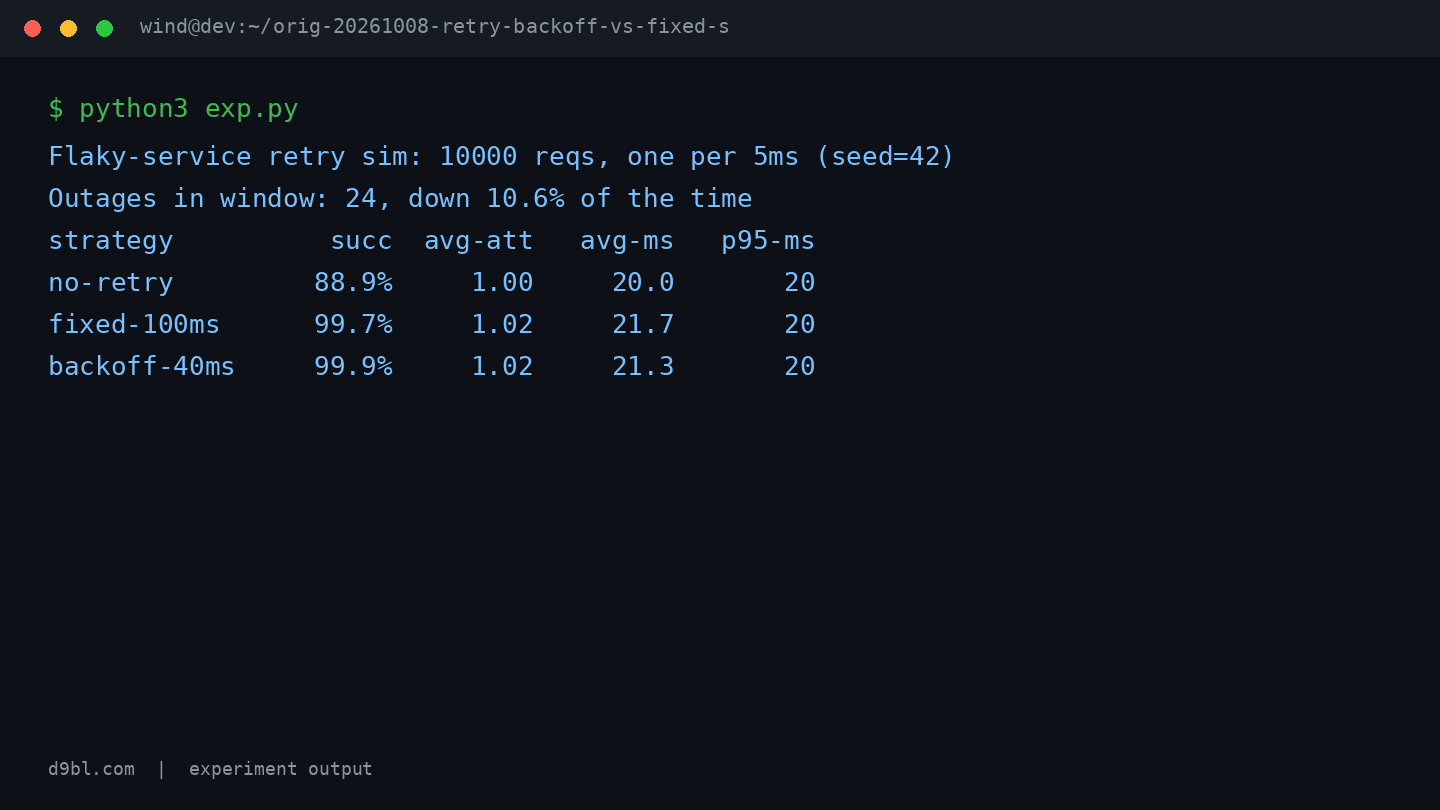
先看环境数据:模拟窗口内发生了 24 次故障,服务累计有 10.6% 的时间处于宕机状态。这个故障率我故意调得比较狠——现实中很少有服务一年里十分之一的时间是硬挂的,我想看看重试机制在恶劣环境下到底能捞回多少。
结果一目了然。no-retry 成功率 88.9%,平均延迟 20.0 毫秒,p95 是 20 毫秒。加上了重试之后,fixed-100ms 拉到 99.7%,平均延迟只涨到 21.7 毫秒;backoff-40ms 是 99.9%,平均延迟 21.3 毫秒。最扎眼的是 p95 这一列:三个策略全是 20 毫秒。也就是说,从 88.9% 到 99.9% 这 11 个百分点的成功率提升,对绝大多数请求的延迟感知是零成本。
反直觉发现/局限
最反直觉的地方在固定间隔和指数退避的差距上。热榜评论区把固定间隔骂得一文不值,但我的数据里 fixed-100ms 和 backoff-40ms 只差 0.2 个百分点成功率,平均延迟上指数退避反而只快了 0.4 毫秒。原因其实很直白:故障窗口最长 500 毫秒,100 毫秒的固定间隔在四次机会里足以跳出大部分窗口;而且我的请求到达间隔是 5 毫秒,同一时刻挤在一起重试的请求很少,重试风暴压根没有形成的土壤。教科书里“固定间隔必然雪崩”的前提——大量客户端同步失败同步重试——在这个模型里根本不成立。
再说我这个实验的局限,有几处翻车点我得老实交代。第一,平均尝试次数三个策略都只有 1.00 到 1.02,说明绝大多数请求第一次就成功了,重试路径的代价被严重稀释——如果故障率再高一个量级,指数退避的延迟优势才会真正拉开。第二,我的故障是“硬挂”模型,服务要么全好要么全坏,没有模拟过载时的部分降级和级联失败,那才是指数退避和断路器真正的主场。第三,客户端之间完全独立,没有共享状态,也没有限流。所以我的结论只能覆盖“偶发抖动 + 短时宕机”这一类场景,别把它外推到所有情况。
我的结论
这轮实测之后,我对“重试就用指数退避”这句话的态度从盲从变成了有条件认同:在故障窗口短、客户端独立的场景里,指数退避相对固定间隔的优势远没有传说中的大——99.9% 对 99.7%,21.3 毫秒对 21.7 毫秒,两者几乎可以互换;而真正决定成败的是“要不要重试”本身,重试把成功率从 88.9% 拉到 99% 以上,这是数量级的差别,至于怎么重试是第二位的问题。
给你一个可以立刻执行的建议:别再照抄库文档里的默认重试参数,先弄清楚你的下游故障长什么样——是毫秒级抖动还是分钟级宕机?窗口比你重试总时长长还是短?拿真实日志量一量,再决定退避曲线的起点和上限。至于指数退避是不是永远更优,我这次的模拟只回答了一小角,你手里如果有真实故障时间线,欢迎拿同样的脚本跑一遍——数据比热榜评论区可靠得多。



