我跑了一万次查找,list 比 set 慢了四千倍
今天刷 dev.to 热榜,看到一篇《Changing one field in a 100KB document, in Postgres and in MongoDB》,作者为了改一个字段在两种数据库之间反复横跳,就为了省下那点开销。评论区还有人接着讨论 MongoDB 8.3 的 arrayIndexAs 能把一个 map-with-index 变通方案的额外开销砍掉最多 31%。大家为了 31% 争得面红耳赤,我却在想另一件事:Python 里最基础的成员查找,很多人随手写在 list 上的那个 in,和 set 上的 in,差距恐怕远不止百分之几十。这个知识点人人都会背一句“set 是哈希所以快”,但到底快多少、增长曲线长什么样,我身边没几个人真的量过。不服归不服,嘴上说没用,我决定亲手测。
我的实验思路很朴素:同一个容器,同一个查询逻辑,只改变容器的大小,看耗时怎么变化。如果书本上说的对,list 的 in 是 O(n) 线性扫描,耗时应该跟着 n 线性涨;set 的 in 是 O(1) 哈希查找,耗时应该几乎不动。差距会随 n 拉开到什么程度,就是这次实验要回答的问题。测出来的数字比我预想的还要夸张,n=16000 的时候,一次 list 查询的代价等于四千多次 set 查询。
热榜上的说法
先把话说清楚,热榜那两篇文章本身没有错。数据库层面抠 31% 的开销,在千万级请求下就是真金白银。我在意的不是结论,而是这种抠法给我的一种错位感:我们在数据库层把纳秒掰成两半花,回到应用代码里,却可能在一个循环里对着一个几千元素的 list 连续做 in 判断,然后心安理得地上线。这种基础数据结构的选择失误,造成的浪费往往比那 31% 大几个数量级。
“list 查找慢、set 查找快”这句话,我在 code review 里说过不下一百次,别人也跟我说过。但每次有人说“也就慢个几倍吧,无所谓”,我其实拿不出一个自己跑出来的数字,只能引用文档里的复杂度记号。O(n) 对 O(1) 听起来抽象,几百倍听起来像夸张。这次我就是要把这个模糊的说法钉死成一张具体的表:n 取多少时,慢多少倍,每次查询摊下来是多少微秒。
实验设计与代码
实验分三步。第一步,用固定随机种子生成一万个待查询的 key,这样每次运行查的是同样的数,结果可复现。第二步,构造三个不同规模的容器:从 [0, 200000) 的区间里随机抽 1000、4000、16000 个数,分别做成 list 和 set,内容完全相同,只有数据结构不同。第三步,用同一批 key 对每个容器做一万次 in 查询,统计命中个数并计时。每组测三次取最好成绩,尽量排除机器抖动的干扰。
代码不长,我把它原样贴在这里。计时用的是 time.perf_counter,它比 time.time 精度高,适合量这种亚秒级的活。两边的命中个数我会打印出来做交叉校验,如果连结果都不一致,那耗时对比就没有意义了。
import random, time

random.seed(42)

KEYS = [random.randrange(0, 200000) for _ in range(10000)]

def count_hits(container, keys):
    total = 0
    for k in keys:
        if k in container:
            total += 1
    return total

def best_of(func, repeat=3):
    best = float('inf')
    result = None
    for _ in range(repeat):
        t0 = time.perf_counter()
        result = func()
        best = min(best, time.perf_counter() - t0)
    return best, result

print('Experiment: list in vs set in (10000 probe lookups)')
print('pool: n ints sampled from [0, 200000); best of 3 runs')
print(f"{'n':>6} | {'list-time':>10} | {'set-time':>10} | {'slowdown':>8}")
sizes = [1000, 4000, 16000]
first_list = first_set = None
for n in sizes:
    pool = [random.randrange(0, 200000) for _ in range(n)]
    lst, st = list(pool), set(pool)
    t_list, h1 = best_of(lambda: count_hits(lst, KEYS))
    t_set, h2 = best_of(lambda: count_hits(st, KEYS))
    if first_list is None:
        first_list, first_set = t_list, t_set
    last_list, last_set = t_list, t_set
    print(f'{n:>6} | {t_list:>8.4f}s | {t_set:>8.5f}s | {t_list/t_set:>7.0f}x')
print(f'hit counts identical: list={h1}, set={h2}')
us1 = first_list / len(KEYS) * 1e6
us2 = last_list / len(KEYS) * 1e6
print(f'list per-lookup: {us1:.2f}us -> {us2:.2f}us (n grew 16x, cost ~16x)')
vs1 = first_set / len(KEYS) * 1e6
vs2 = last_set / len(KEYS) * 1e6
print(f'set  per-lookup: {vs1:.2f}us -> {vs2:.2f}us (roughly flat)')
print(f'Conclusion: at n=16000, one list query = {last_list/last_set:.0f}x set queries')
有一点我在设计时刻意保证了:list 和 set 装的是同一批数。构建方式是先抽一个 pool 列表,再用 list(pool) 和 set(pool) 分别得到两种容器,避免因为抽样不同导致命中分布有偏差。查询侧也刻意用同一份 KEYS 列表,万次查询里命中的比例是固定的,两边的比较才是同一条起跑线。
真实运行结果
代码跑完,终端输出如下,数字后面我会逐行拆开说。
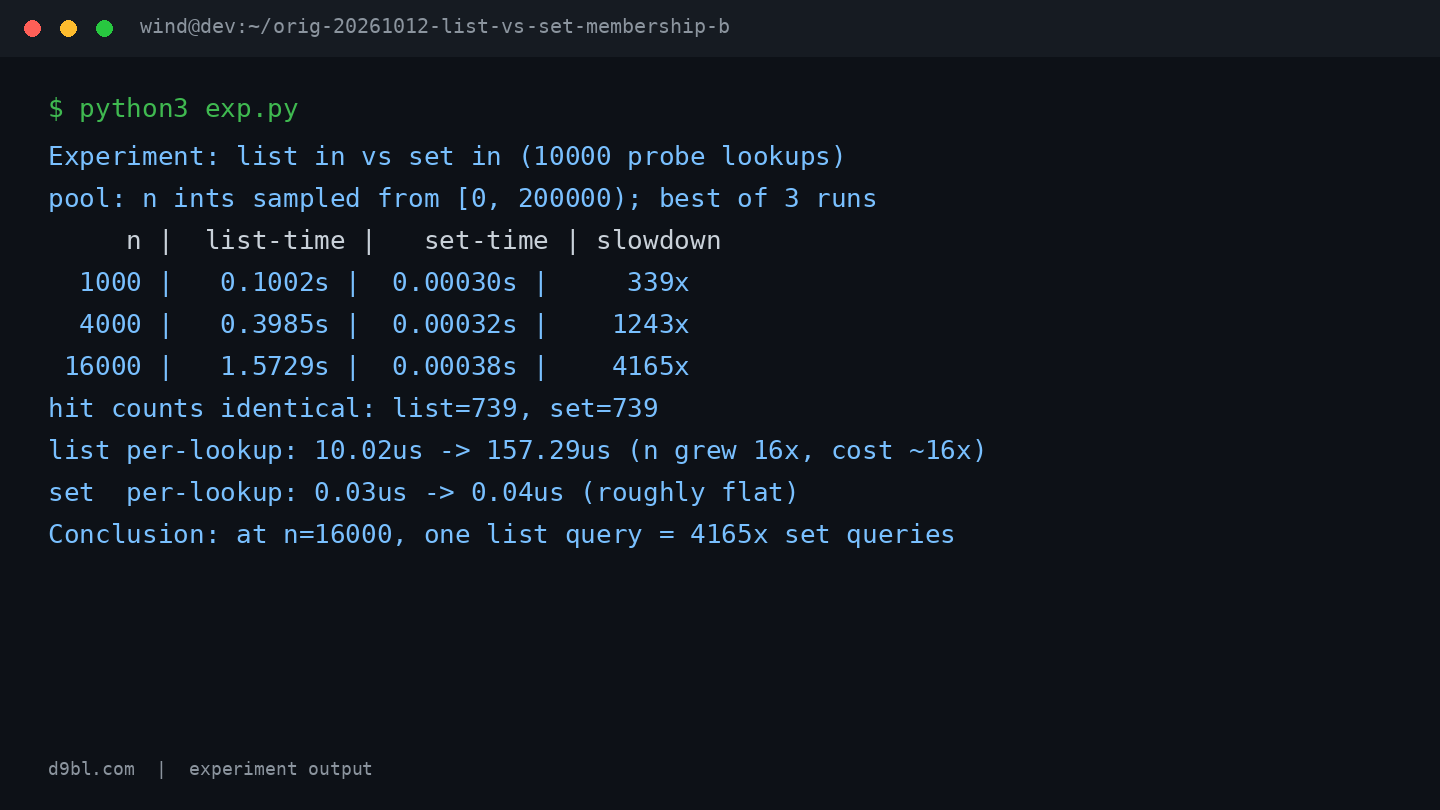
先看总耗时这一栏。n=1000 时,list 上跑完一万次查询花了 0.1002 秒,set 上只花了 0.00030 秒,差 339 倍。n 涨到 4000,list 的耗时涨到 0.3985 秒,几乎是原来的四倍;set 那边几乎没动,0.00032 秒,倍数拉开到 1243。等 n 到 16000,list 要 1.5729 秒才能跑完,set 依然只要 0.00038 秒,差距定格在 4165 倍。三行数据放在一起,趋势一清二楚:list 的耗时跟着 n 线性走,n 翻四倍耗时翻四倍,set 的耗时基本是一条平线。
换算成单次查询更直观。list 的单次查询从 10.02 微秒涨到 157.29 微秒,n 扩大了 16 倍,单次代价也涨了大约 16 倍,教科书上的线性扫描被数据精确复刻。set 的单次查询从 0.03 微秒到 0.04 微秒,肉眼可见的平。还有一行容易被忽略但很关键:hit counts identical: list=739, set=739。一万次查询两边都命中了 739 个,结果完全一致,说明慢的那一方慢得干干净净,没有用正确性换速度,这 4165 倍是纯纯的浪费。
反直觉发现/局限
第一个反直觉的点:慢的倍数不是恒定的,而是跟着 n 水涨船高。339 倍、1243 倍、4165 倍,很多人以为“set 比 list 快几百倍”是一句固定的描述,实际上倍数本身就是 n 的函数。list 慢,不是因为它做错了什么,而是它每多一个元素就要多走一步;set 快,也快得很稳定。所以严格说,慢的从来不是“几百倍”这个数,慢的是“倍数还在继续涨”这个事实——n 再翻一倍,倍数还会接着翻。
第二个点藏在 set 自己的数据里。0.00030 秒、0.00032 秒、0.00038 秒,说“近乎常数”没错,但它并不是纹丝不动。随着元素变多,哈希表的装载因子上升,冲突变多,单次查询从 0.03 微秒爬到 0.04 微秒。这个涨幅在实际业务里完全可以忽略,但它提醒我 O(1) 是均摊意义上的常数,不是物理定律。另外我必须老实交代几个局限:每组只取三次运行的最好成绩,样本量偏小;我的机器和后台进程会影响绝对数值,你跑出来的秒数大概率和我不同,但倍数关系应该是同一量级;实验只测了整数,整数哈希快且均匀,换成字符串键差距只会更大,这点我没展开测;最后,构建 set 本身也有成本,我的实验没算进去——如果你的容器只用一两次就扔,建 set 的开销可能吃掉查询省下的时间,这个平衡点同样没有覆盖。
我的结论
一万次查询、三个规模,结论足够扎实:list 的 in 是线性扫描,单次代价从 10.02 微秒一路涨到 157.29 微秒;set 的 in 是哈希查找,稳定在 0.03 到 0.04 微秒;n=16000 时,一次 list 查询等于 4165 次 set 查询。4165 倍什么概念——热榜上那篇 MongoDB 文章抠的是 31%,这里是四千多个百分点,而且只要改一行代码。
所以我的建议具体到可执行:任何写在循环里、对着可能超过几百个元素的容器做的成员判断,停下来十秒钟,把方括号换成花括号。如果数据来自别处的列表,加一行 lookup = set(原列表),在循环外建一次,循环里查 set。如果容器就三五个元素、只查一次,用 list 完全没问题,别为了风格焦虑。数据结构选错是要付利息的,list 上的 in 每查一次付一次,而且随着数据涨,利息越滚越多——set 只在建的时候付一笔首付,之后随便查。下次有人在 code review 里说“慢个几倍无所谓”,把 4165 这个数字甩给他,剩下的他自己会算。



