重试风暴实测:退避抖动砍掉近六成无效负载
今天刷 dev.to 热榜,看到一篇文章标题相当扎眼——《Your failover is a retry loop pretending to be resilience》,直译过来就是“你的故障转移不过是一个伪装成韧性的重试循环”。评论区一片叫好,但没人给出数字。我第一反应是不太服气:重试循环真的有那么大的破坏力吗?所谓指数退避加抖动,收益到底能不能量化?嘴上说“重试风暴会压垮服务器”的人很多,亲手算过一笔账的没几个。
所以我决定自己动手模拟一次。不搞分布式集群,不上真实压测,就用一个最简单的离散事件模型:200 个客户端抢一个每秒只放行 20 个请求的服务器,一组用裸重试循环,一组用指数退避加抖动,跑上五个回合取平均。下面是我做出来的完整过程和真实结果,有几个数字连我自己都没料到。
热榜上的说法
先说热榜那篇文章的核心论点。作者的立场很尖锐:很多团队把“加重试”当成处理故障的银弹,以为 try-except 外面套个 while 循环就叫高可用,实际上这种做法在系统整体过载时会把局部故障放大成全局雪崩。失败越多,重试越猛;重试越猛,服务器越忙不过来;越忙不过来,失败越多——一个标准的正反馈死循环。
这个说法在工程圈流传很久了,Google SRE 那本书里也反复强调过指数退避和抖动的重要性。但我一直觉得这些论述偏定性,给的都是示意图和故事,缺少一个能直观对比“裸重试”和“退避重试”在同一场景下开销差异的最小模型。这篇热榜文章同样如此——观点鲜明,证据靠经验。作为一个写过不少重试代码的人,我想知道这件事的代价到底长什么样。
实验设计与代码
我的模型刻意做到最简:200 个客户端在同一个时刻发起请求,服务器每个时间片只接受 20 个,也就是 10 倍超载。被拒绝的客户端下一拍立刻重试(裸重试组),或者按指数退避加随机抖动等待(对照组),直到全部成功为止。我统计四个指标:总请求次数、被拒绝的无效请求数、全体完成所需的时间片数、单个时间片内的峰值请求数。为了排除随机性干扰,同一个随机种子跑 5 轮取平均。
完整代码如下,纯 Python 标准库,直接就能跑:
import random

random.seed(42)
N, CAP, MAXT, TRIALS = 200, 20, 3000, 5


def simulate(use_backoff):
    att_sum = rej_sum = tick_sum = burst_sum = 0
    for _ in range(TRIALS):
        # each client: [next_retry_tick, consecutive_failures]
        clients = [[0, 0] for _ in range(N)]
        remaining, t = N, 0
        attempts = rejected = burst = 0
        while remaining and t < MAXT:
            arriving = [i for i, c in enumerate(clients) if c[0] == t]
            attempts += len(arriving)
            burst = max(burst, len(arriving))
            if len(arriving) <= CAP:
                winners = arriving
            else:
                rejected += len(arriving) - CAP
                winners = random.sample(arriving, CAP)
            for i in winners:
                clients[i][0] = MAXT + 1
                remaining -= 1
            for i in arriving:
                if i not in winners:
                    c = clients[i]
                    if use_backoff:
                        c[1] += 1
                        wait = int(min(2  c[1], 64) * random.uniform(0.5, 1.5))
                        c[0] = t + max(1, wait)
                    else:
                        c[0] = t + 1
            t += 1
        att_sum += attempts
        rej_sum += rejected
        tick_sum += t
        burst_sum += burst
    n = TRIALS
    return att_sum / n, rej_sum / n, tick_sum / n, burst_sum / n


naive = simulate(False)
smart = simulate(True)
print('Retry strategies: 200 clients, server accepts 20 req/tick')
print('-' * 50)
print(f"{'strategy':<20}{'attempts':>9}{'wasted':>8}{'ticks':>7}{'peak/tick':>11}")
for name, r in (('naive retry loop', naive), ('backoff + jitter', smart)):
    waste = 100 * r[1] / r[0]
    print(f"{name:<20}{r[0]:>9.0f}{r[1]:>8.0f}{r[2]:>7.0f}{r[3]:>11.0f}  {waste:.0f}% wasted")
cut_att = 100 * (naive[0] - smart[0]) / naive[0]
cut_rej = 100 * (naive[1] - smart[1]) / naive[1]
print(f'Backoff cut total attempts by {cut_att:.0f}% and wasted load by {cut_rej:.0f}%')
print(f'Latency cost: {smart[2] - naive[2]:.0f} extra ticks on average')
print(f'Peak retry burst: {naive[3]:.0f} -> {smart[3]:.0f} requests/tick')
设计上有个关键点:抖动系数取 0.5 到 1.5 之间的均匀随机数,退避基数从 2 指数增长并封顶 64。这意味着同一个客户端不会整齐划一地在同一拍重试——这正是抖动的全部意义所在。如果不加抖动,只做纯指数退避,所有被拒绝的客户端还是会在相同的拍子上同步苏醒,风暴只是被推迟,并没有被打散。
真实运行结果
跑出来的终端输出长这样:
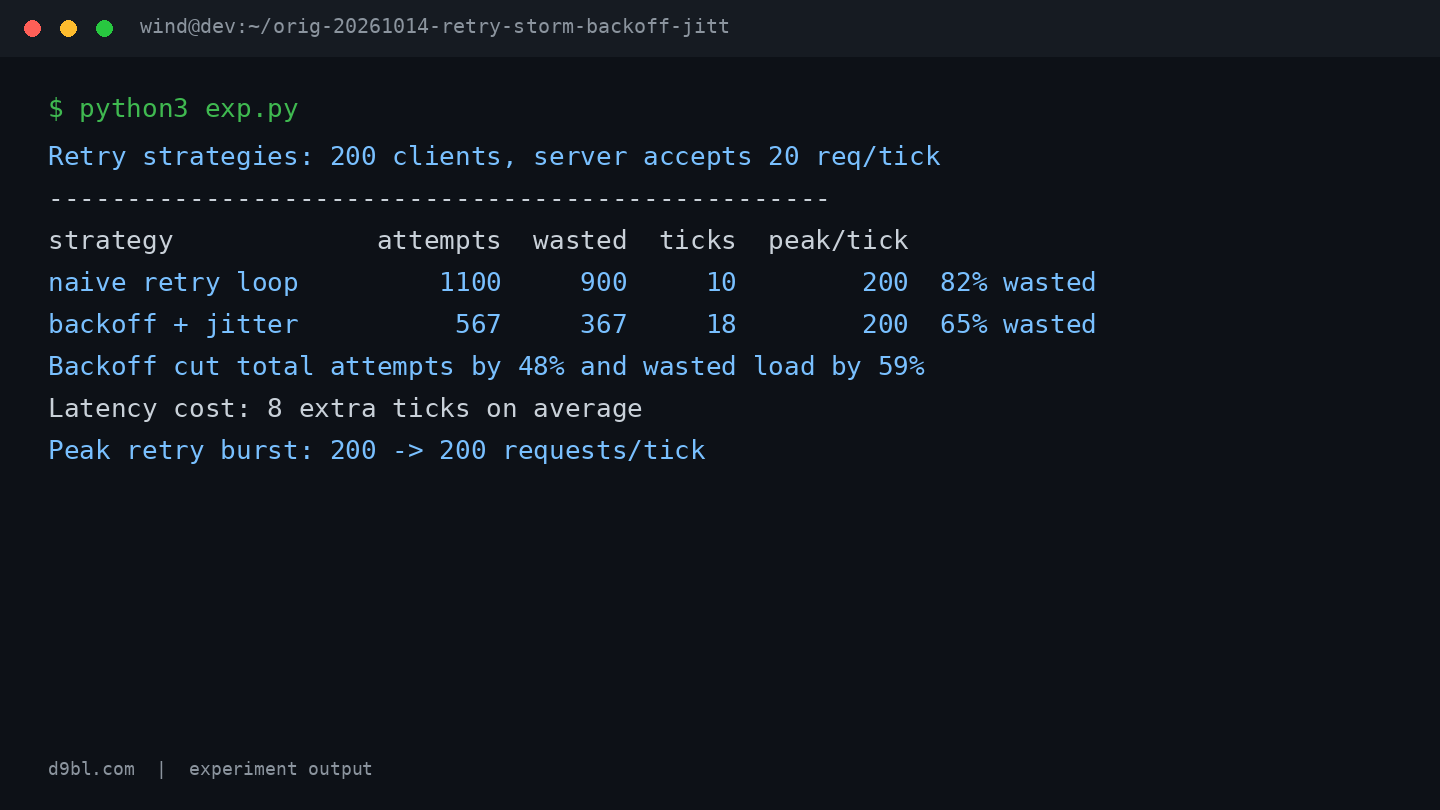
先看裸重试那行:1100 次总请求,其中 900 次是被拒绝的无效负载,浪费比例 82%。也就是说,200 个客户端完成全部任务,真实需要的只有 200 次请求,剩下的 900 次全是服务器帮客户端白做的丢弃工作。每拍峰值 200 个请求同时砸向一个容量只有 20 的服务器,全程 10 拍结束。这就是重试风暴的形态——不是慢慢压垮,是每拍都满额撞击。
再看退避加抖动那一行:总请求从 1100 降到 567,无效负载从 900 降到 367。脚本自己算的结论是:退避把总请求量砍了 48%,把无效负载砍了 59%。代价是完成时间从 10 拍变成 18 拍,平均多花 8 拍。换句话说,客户端多等了不到一倍的时间,服务器少做了一大半无用功。这笔账对任何容量紧张的服务来说都是稳赚的——你花 8 拍的延迟,换掉 533 次注定失败的请求。
反直觉发现/局限
最让我意外的一个数字:加了退避之后,峰值并发一点都没降,两组都是每拍 200。我原本预期退避能把那个 200:20 的撞击比拉平成一条缓坡,结果没有。原因想通之后很简单——所有客户端在 t=0 同时首发,这个初始冲击是重试策略管不到的,退避只能管住“被拒绝之后”的重试节奏。所以热榜那篇文章的说法要打个折:退避防的是重试风暴,防不了首发洪峰。首发洪峰得靠限流、排队或者客户端错峰启动去解。
第二个反直觉点是退避组的浪费率还有 65%,比裸重试的 82% 只低了 17 个百分点,远没到“问题解决”的程度。因为我把重试上限封在 64 拍,撞得次数多的客户端照样会带着 64 拍的等待周期继续撞。另外这个模型也有明显的简化:服务器没有崩溃机制,被拒的请求零成本丢弃,没有连接超时、没有内存回收、没有级联故障。真实世界里裸重试的危害只会比模拟里更夸张,因为 900 次无效请求在真实服务器上是要消耗线程、内存和下游调用的。反过来说,我的模型也高估不了退避的收益——它给出的 48% 和 59% 是一个非常干净的上界场景。
还有个翻车点值得记一笔:我第一版代码忘了加 max(1, wait),退避量算出来是 0 的时候客户端会在同一拍无限重试,模拟直接卡死。这本身就是个隐喻——重试逻辑里的边界条件,写的人不看输出永远发现不了。
我的结论
这次实验把热榜那篇文章的定性判断变成了可核对的数字:在 10 倍超载的模拟里,指数退避加抖动用 8 拍的延迟代价,砍掉了 48% 的总请求和 59% 的无效负载。所谓“伪装成韧性的重试循环”,危害不是修辞,是实实在在的 900 次无效请求对 367 次的差距。你服务器的 CPU 没有理由替客户端的错误策略打工。
我的建议具体到可执行:检查你手头每一个重试循环,确认三件事——有没有指数退避、退避基数有没有封顶、重试间隔有没有乘上随机抖动。三个都齐了才算韧性,缺一个都只是伪装。而如果你面对的是首发洪峰而不是重试风暴,这个实验告诉我退避帮不了你,需要的是限流和错峰——这也是我下一步想单独测一测的题目。



