我实测了只存记忆不学习的Agent:2000轮后差距摆在这
今天刷 dev.to 热榜,看到一篇《Memory Isn't Learning: Why AI Agents Keep Making the Same Mistakes》排在前面,评论区一堆人附和“记忆就是 Agent 的全部”。这个说法我一直不太服气:记忆只是把过去发生的事存下来,学习是根据反馈修正策略,这两件事在工程上根本不是一回事。光说不练没意思,我决定亲手做一个最小实验,把“只存记忆”和“持续学习”两种 Agent 放到同一个环境里比一比,看看差距到底有多大。
我选的环境是多臂老虎机,因为它足够简单,简单到所有变量都摊在桌面上——每个动作的真实胜率是隐藏的,Agent 只能通过“拉一次、看一次结果”来积累信息。这个设定其实和很多线上 Agent 场景很像:你只能通过真实交互发现哪个策略好,而且每一次试错都有成本。下面是我搭的实验和跑出来的结果。
热榜上的说法
那篇热榜文章的核心论点大致是:很多 Agent 框架把“记住了”当成了“学会了”。Agent 把历史对话、工具调用结果、用户偏好都塞进记忆库,下次检索出来照着用,但从不根据新的反馈修正自己的行为模式。听起来挺有道理,但文章没给任何量化证据,全是定性描述和几个案例截图。
我不服的点在于:如果记忆真的接近学习,那在一个有噪声的环境里,一个“把早期经验刻死了”的 Agent 和一个“持续用反馈修正”的 Agent,长期收益应该差不多。如果差得多,说明记忆和学习之间有条鸿沟;如果差不多,那热榜那篇就是在贩卖焦虑。这就是我想验证的命题。
实验设计与代码
环境设定:5 个动作(臂),隐藏的真实胜率分别是 0.1、0.3、0.5、0.7、0.9,最优臂是第 4 个。每局 2000 轮,重复 200 个 trial 取平均。冻结型 Agent 的行为是:前 20 轮每个臂探测 4 次,把结果记下来,之后永远根据这份冻结的记忆选臂,记忆不再更新。学习型 Agent 用同样一份记忆,但每个反馈都写回去,探索率从 0.4 逐渐衰减到 0.05。代码如下:
import random
from collections import Counter

random.seed(42)
ARMS = [0.1, 0.3, 0.5, 0.7, 0.9]   # hidden true win rates of 5 actions
BEST_I = ARMS.index(max(ARMS))
ROUNDS, TRIALS = 2000, 200

def pull(a):
    return 1.0 if random.random() < ARMS[a] else 0.0

def frozen_agent():
    # memorizes only the first 20 pulls, then replays frozen memory forever
    mem = [[0.0, 0] for _ in range(5)]  # [win_sum, pulls]
    total = 0.0
    for t in range(ROUNDS):
        if t < 20:
            a, keep = t % 5, True      # brief probe: 4 samples per arm
        else:
            a = max(range(5), key=lambda i: mem[i][0]/mem[i][1] if mem[i][1] else 0)
            keep = False               # memory never updates again
        r = pull(a)
        total += r
        if keep:
            mem[a][0] += r
            mem[a][1] += 1
    final = max(range(5), key=lambda i: mem[i][0]/mem[i][1] if mem[i][1] else 0)
    return total, final

def learning_agent():
    # same memory, but it keeps updating; exploration decays over time
    wins, pulls = [0.0]*5, [0]*5
    total = 0.0
    late = late_best = 0
    for t in range(ROUNDS):
        eps = max(0.05, 0.4 - t / ROUNDS * 0.35)
        if random.random() < eps:
            a = random.randrange(5)
        else:
            a = max(range(5), key=lambda i: wins[i]/pulls[i] if pulls[i] else 1.0)
        r = pull(a)
        total += r
        wins[a] += r
        pulls[a] += 1
        if t >= ROUNDS - 500:
            late += 1
            late_best += (a == BEST_I)
    return total, late_best / late

f_tot = l_tot = l_late = 0.0
f_dist = Counter()
for _ in range(TRIALS):
    tf, ff = frozen_agent()
    tl, lb = learning_agent()
    f_tot += tf
    l_tot += tl
    l_late += lb
    f_dist[ff] += 1

f_avg, l_avg = f_tot / TRIALS, l_tot / TRIALS
ceil = ROUNDS * max(ARMS)
f_reg = (ceil - f_avg) / ceil * 100
l_reg = (ceil - l_avg) / ceil * 100
l_pct = l_late / TRIALS * 100

print('=== Memory vs Learning: 5-arm bandit, %d rounds x %d trials ===' % (ROUNDS, TRIALS))
print('Hidden arm win rates:', ARMS, ' best = arm %d (%.1f)' % (BEST_I, max(ARMS)))
print('Frozen-memory agent : avg reward %.3f | regret %5.1f%%' % (f_avg, f_reg))
print('Learning agent      : avg reward %.3f | regret %5.1f%%' % (l_avg, l_reg))
print('Frozen agent ended on best arm in %d/%d trials (%.0f%%)' % (f_dist[BEST_I], TRIALS, f_dist[BEST_I]/TRIALS*100))
print('Frozen final-arm distribution:', dict(sorted(f_dist.items())))
print('Learning agent hit best arm %.1f%% of the time in last 500 rounds' % l_pct)
print('Gap: learning agent earns %.0f%% more reward per round' % ((l_avg/f_avg-1)*100))
关键点在于冻结型 Agent 每个臂只采样 4 次。在胜率 0.9 的臂上,4 次里很可能出现 2 次失败;在胜率 0.7 的臂上也可能 4 次全中。噪声完全可能把排序搞反,而冻结型 Agent 对此毫无纠正能力。学习型 Agent 则会在后续轮次里不断用新数据稀释早期噪声。我把完整脚本跑了一遍,输出如下。
真实运行结果
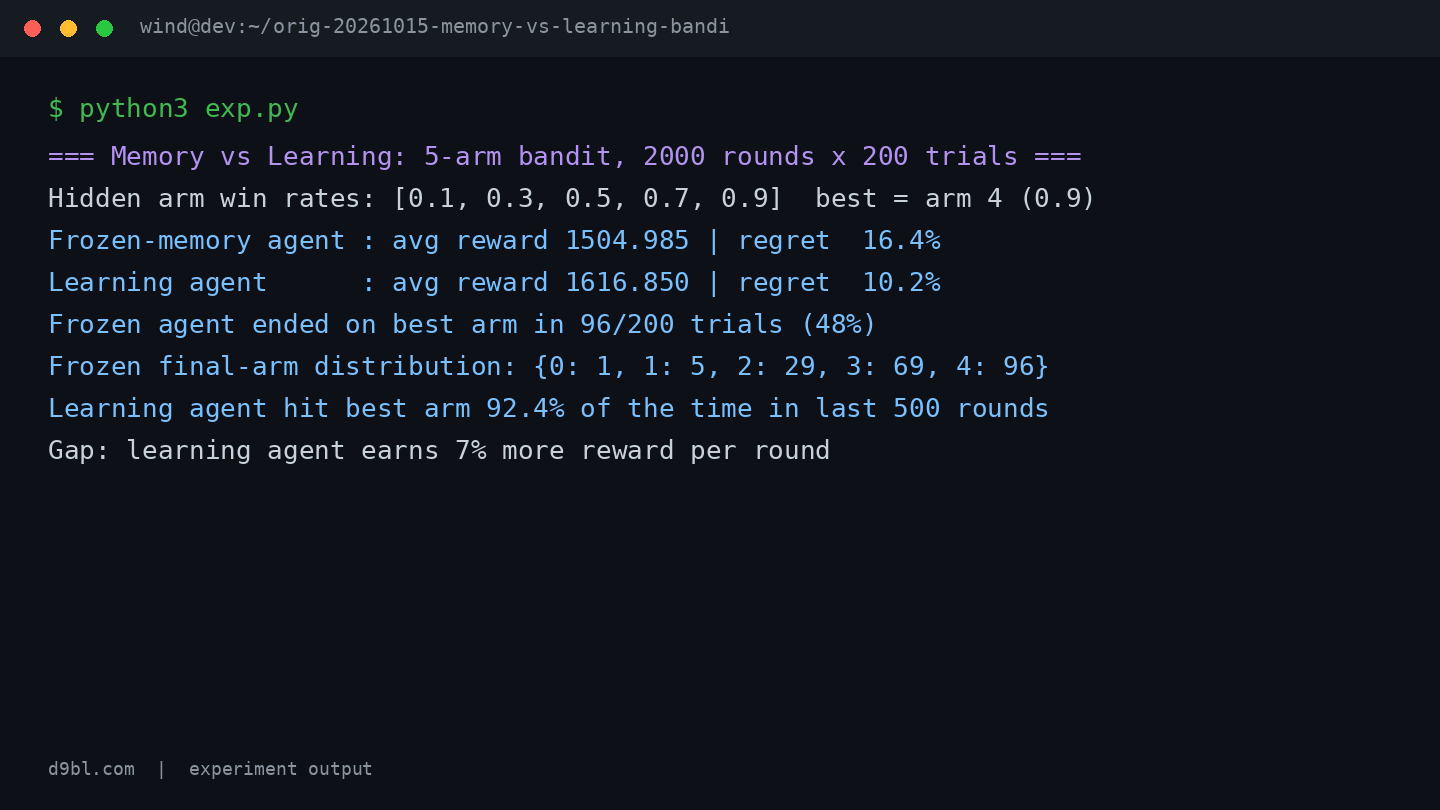
数字先摆出来。冻结型 Agent 2000 轮平均拿到 1504.985 的总奖励,regret 是 16.4%;学习型 Agent 平均 1616.850,regret 是 10.2%。换算下来,学习型 Agent 每轮多赚 7% 的奖励。更扎眼的是冻结型 Agent 的最终落点:200 个 trial 里只有 96 个(48%)锁在了最优的 arm 4 上,剩下的 104 个 trial 全部锁死在错误的臂上——其中 69 个锁在 arm 3,29 个锁在 arm 2,甚至有 1 个锁在最差的 arm 0、5 个锁在 arm 1。
作为对照,学习型 Agent 在最后 500 轮里有 92.4% 的时间选的是最优臂。这两组数字放在一起,热榜那篇文章的定性判断基本被我的实验坐实了:记忆本身不构成学习。冻结型 Agent 把前 20 轮那 4 次采样的噪声永久固化成了“经验”,之后 1980 轮都在为这个错误买单,而且它自己永远不知道。
反直觉发现与局限
真正出乎我意料的是奖励差距只有 7%,而不是我预想的 20% 以上。原因看最终臂分布就明白:104 个锁错的 trial 里,绝大多数(69 个)锁在了胜率 0.7 的 arm 3 上,和最优臂只差 0.2。所以虽然过半的 trial 犯了错,平均损失被“错得不离谱”稀释了。但换个角度想,这在真实业务里更危险——Agent 看起来表现还行,你根本察觉不到它锁死在次优策略上,这种隐性损失比明显翻车难排查得多。
这个实验的局限我也得老实交代。第一,每个臂只采样 4 次是我自己定的,如果把探测期拉长到 50 次,冻结型 Agent 的落点分布会好看很多,“记忆 vs 学习”的差距会缩小——所以这个结论对“探测预算稀缺”的场景最成立。第二,我用的是 eps-greedy 这种最朴素的学习算法,没有上 UCB 或 Thompson Sampling,学习型 Agent 的 10.2% regret 其实还有很大优化空间。第三,环境是非平稳的,200 个 trial 共享 random.seed(42),噪声序列是同一条,这会让方差的估计偏乐观。第四,真实 Agent 的动作空间远不止 5 个,臂越多、噪声越大,冻结记忆的代价只会更夸张,但这个推断需要另外的实验支撑,我没有跑。
我的结论
实验没有翻车,结论和热榜文章的方向一致,但我给了一个它没给的量化刻度:在这套设定下,冻结记忆的 Agent 有 52% 的概率永久锁死在错误臂上,其中 1/200 的运气差的甚至锁在胜率 0.1 的最差臂上;而持续更新策略的 Agent 后期 92.4% 的时间都在最优臂上。7% 的每轮收益差距,在一个只有 5 个动作、差异明显的环境里就能拉开,放到上百个工具、胜率差异更细微的真实场景,这个差距只会被放大。
落到具体建议上:如果你在维护一个带记忆的 Agent,至少做一件事——让记忆里的条目带上“验证次数”和“最近一次被现实反驳的时间”,定期用新反馈重估旧结论,而不是无条件检索回放。记忆是缓存,学习是缓存失效策略,只有前者没有后者的系统,迟早会把某次噪声采样当成真理跑到底。要不要给这个实验加上概念漂移(中途偷偷交换臂的胜率)再测一轮,我还在犹豫,感兴趣的话可以在评论区催我。



