1万次请求喂下去,LFU比FIFO多命中13.4个百分点
缓存淘汰策略到底选哪个,我在两个群里看到了完全相反的答案。一边的人说FIFO实现最简单、常数最小,够用了,命中率损失可以忽略;另一边的人说LFU才配得上"倾斜流量"这个词,FIFO在热点面前就是个摆设。两边都言之凿凿,谁也不给数字。我不想再继续吵下去,干脆自己写个模拟,把同一份请求流分别喂给三种策略,跑一万次请求看命中率,用实验定论。
这篇文章记录的就是这次实验的全过程:实验怎么设的、数字长什么样、翻车点在哪里,以及最后我自己会怎么选。所有结论都来自下面那段真实跑出来的输出,不接受口头站队。
两个做法的分歧点
分歧的核心其实是一个假设:你的流量到底倾不倾斜。FIFO阵营的默认假设是请求分布比较均匀,谁被淘汰都差不多,那用最简单的队列就够了;LFU阵营的默认假设是少数热点撑起了大部分流量,必须把热数据钉在缓存里不放走。两个假设在各自的场景里都成立,所以网上才会吵不出结果。
还有一个隐蔽的分歧点是缓存大小和物品总数的比例。如果缓存能装下所有物品,什么策略都是100%命中,讨论毫无意义;如果缓存小到接近于零,三种策略都趋近零命中。有意思的区间恰恰是"缓存只能装下一小部分"的时候——这时候策略的优劣才会拉开差距。我的实验就设在这个区间里,让分歧真正暴露出来。
对比实验怎么设
我把参数钉死成这样:1000个物品,缓存只有50个槽位,也就是只能装下5%的物品;请求总量10000次。倾斜流量用截断的Zipf分布生成,指数取1.2,这是文献里模拟Web访问热度的常用配置;均匀流量用等概率随机生成,作为对照组。随机种子固定为42,保证任何人在本地重跑都能得到和我一模一样的数字。
三种策略都用了各自的标准实现:FIFO用deque加一个set做成员判断;LRU用OrderedDict,命中就move到尾部,满了就从头部弹;LFU用了频次桶加桶内插入顺序的结构,淘汰时先找最小频次,再弹桶里最老的那个。每个策略函数只接受请求序列、返回命中次数,接口统一,跑完换算成百分比。
import random, collections, itertools
random.seed(42)
ITEMS, CAP, N = 1000, 50, 10000
def zipf_load():
    # exact truncated Zipf via inverse-CDF sampling
    w = [i  -1.2 for i in range(1, ITEMS + 1)]
    cum = list(itertools.accumulate(w))
    return random.choices(range(ITEMS), cum_weights=cum, k=N)
def run_fifo(reqs):
    q, mem, hit = collections.deque(), set(), 0
    for r in reqs:
        if r in mem:
            hit += 1; continue
        if len(q) >= CAP: mem.remove(q.popleft())
        q.append(r); mem.add(r)
    return hit
def run_lru(reqs):
    od, hit = collections.OrderedDict(), 0
    for r in reqs:
        if r in od:
            hit += 1; od.move_to_end(r); continue
        if len(od) >= CAP: od.popitem(last=False)
        od[r] = True
    return hit
def run_lfu(reqs):
    # least-frequent first, oldest inserted breaks ties
    cnt, hit = {}, 0
    buckets = collections.defaultdict(collections.OrderedDict)
    for r in reqs:
        if r in cnt:
            f = cnt[r]; hit += 1
            del buckets[f][r]
            if not buckets[f]: del buckets[f]
            cnt[r] = f + 1; buckets[f + 1][r] = True
        else:
            if len(cnt) >= CAP:
                mf = min(buckets)
                k, _ = buckets[mf].popitem(last=False); del cnt[k]
                if not buckets[mf]: del buckets[mf]
            cnt[r] = 1; buckets[1][r] = True
    return hit
policies = [("FIFO", run_fifo), ("LRU", run_lru), ("LFU", run_lfu)]
zipf_reqs = zipf_load()
uni_reqs = [random.randrange(ITEMS) for _ in range(N)]
res = [(n, 100.0 * fn(zipf_reqs) / N, 100.0 * fn(uni_reqs) / N)
       for n, fn in policies]
cnt = collections.Counter(zipf_reqs)
print("params: %d requests, %d items, cache = %d slots" % (N, ITEMS, CAP))
print("hottest item alone takes %.1f%% of traffic"
      % (100.0 * cnt.most_common(1)[0][1] / N))
top = 100.0 * sum(c for _, c in cnt.most_common(CAP)) / N
print("top %d items take %.1f%% of traffic" % (CAP, top))
for n, hz, hu in res:
    print("%-4s zipf hit %5.1f%% | uniform hit %5.1f%%" % (n, hz, hu))
b, w = max(res, key=lambda x: x[1]), min(res, key=lambda x: x[1])
print("zipf load: %s beats %s by %.1f pp" % (b[0], w[0], b[1] - w[1]))
print("uniform load: all near %.1f%%, cache policy barely matters"
      % (100.0 * CAP / ITEMS))
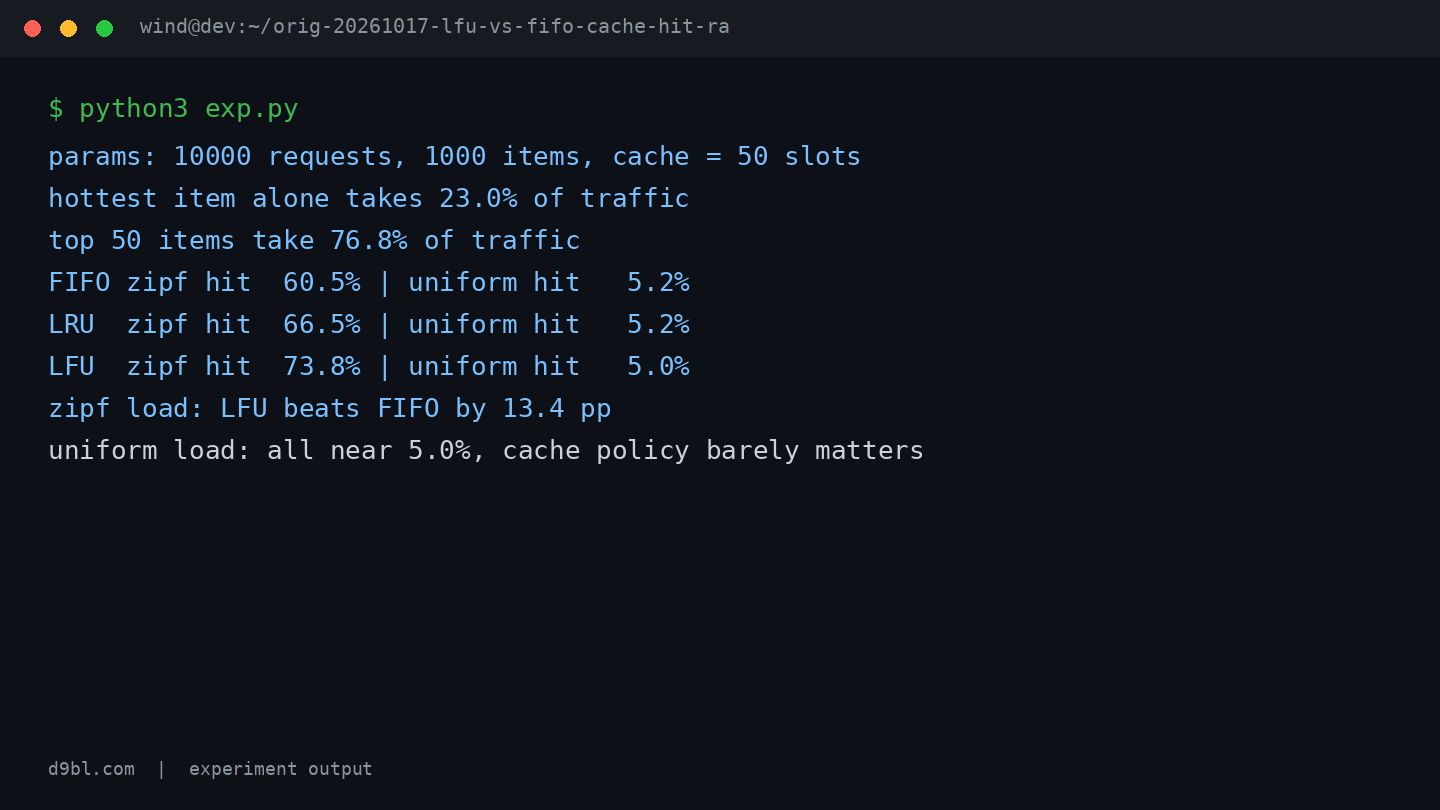
跑完的输出在这里:
数据摆出来
先看流量长什么样:单个最热物品就占了全部流量的23.0%,而访问频率最高的50个物品合计吃掉76.8%的流量。也就是说,一个只装50个槽位的缓存,理论上限就是76.8%——只要策略足够聪明,把该留的都留下。这个背景数字很关键,它说明我的实验确实落在了"流量高度倾斜"的区间。
倾斜流量下的结果分层非常清楚:FIFO命中60.5%,LRU命中66.5%,LFU命中73.8%。LFU比FIFO整整高出13.4个百分点,LFU离76.8%的理论上限也只差3个百分点——它几乎把热数据全留住了。LRU居中,比FIFO好6个百分点,但离LFU还有一段距离。
对照组的结果才是这次实验里最扎心的:均匀流量下,FIFO和LRU都是5.2%,LFU是5.0%,三者几乎重叠,而且都贴着5.0%这条线——正好是缓存容量50除以物品总数1000。换句话说,流量不倾斜的时候,缓存策略随便选,命中率就是这个理论上限,谁也救不了谁。缓存的收益来自流量倾斜本身,而不是来自某个聪明的算法。
结论之外还要看什么
翻车点得老实交代。第一,我的LFU是"全历史计数",一个物品一旦热过就永远背着高频计数,如果真实系统里有"昨天的热点今天凉了"这种场景,LFU会被旧热点占着槽位不放,反而不如LRU。生产级的LFU通常要做频次衰减或分时间窗计数,我这里为了对比干净没有加,所以13.4个百分点的优势是"静态热点"下的数字,不能直接外推到热点会轮换的场景。
第二,我只测了命中率的数字,没测实现开销。LFU那次频次桶的实现代码量是FIFO的三倍,还要维护最小频次的查找;在纯内存场景里这些开销通常无所谓,但如果每次计数更新都要跨进程或跨网络去写,账就要重新算了。第三,10000次请求、1000个物品毕竟是小规模模拟,随机种子固定只有一个,换个种子数字会在小数点后波动,量级不会变,但别把73.8%当成铁律,当成量级参考更合适。
我会选哪个
落到选型上,我的判断是:先别急着选算法,先花十分钟确认你的流量倾不倾斜。做法很土但有效——把线上访问日志跑一个Counter,看看top 50的物品占多少流量。如果像实验里这样能占到七成以上,LFU多出来的13.4个百分点是真实收益,值得为它多写那点代码;如果占比和均匀分布没差多少,那三种策略都在5%附近趴着,选FIFO,把省下的复杂度花在别的地方。
如果你的热点会随时间轮换——比如内容平台按天换话题——那这组数字就不能直接用,建议把实验里的计数器改成带衰减的版本再跑一遍,看看LFU的优势还剩几个百分点。数据比争论便宜,一次模拟的成本远低于线上换错策略的代价。



