正则里多套一层括号:22个字符把匹配拖慢了135万倍
上个月我在线上排一个诡异的问题:某个校验接口偶发超时,超时的请求有个共同点——用户在输入框里粘了一长串同一个字符。我第一反应是锁竞争,第二反应是 GC 抖动,还顺手查了那个时段的监控,都没发现问题。接口里唯一有点历史的就是一个老正则,但当时我觉得正则匹配短字符串能慢到哪去,就没往那边想。
感觉不能代替证据,尤其是这种“偶发”的问题,凭直觉下结论很容易把锅甩给基础设施。我把接口里那段正则抽出来,剥掉业务前缀,收敛成一个最小可复现的实验:同样的输入,两种写法,一种多套了一层括号,各跑一遍计时。结果比我预想的夸张得多——多出来的那层括号,在 22 个字符的输入上把匹配拖慢了 1352253 倍。
我遇到的现场
那个接口做的事情很简单:校验用户提交的标签串,允许一段一段的字母,最后必须以一个特定字符结尾。写正则的同事(包括很久之前的我)当时想表达“一段或多段字母”这个语义,顺手写出了嵌套量词的形状——外层一个 +,里层的分组里还有一个 +。语义上它和扁平写法完全等价,字面上只差一层括号和一个加号,review 的时候没有任何人觉得这有问题。
正常输入下它确实没问题,几微秒就返回。坏就坏在匹配失败的那条路径上:只要末尾缺那个结尾字符,正则引擎就会穷举所有可能的切分方式来确认“真的匹配不上”,而切分方式的数量随输入长度指数增长。用户粘一大串相同字符进来,恰好就是最恶劣的输入。当时我盯着日志里超时的 payload,还没意识到这一点,只是纳闷为什么失败的校验反而比成功的更耗时——这个反常本身就是最大的线索。
还原实验怎么设
为了把变量控制干净,我没有用线上那段正则,而是构造了两个形状完全对应的最小样本:^(a+)+b$ 是嵌套量词的陷阱版,^a+b$ 是语义等价的扁平版。输入全部是 n 个 a、没有结尾的 b——故意让两个模式都走失败路径,因为回溯的代价恰恰在失败时爆发。n 从 14 开始,每次加 2,一直加到 22。
import re
import time

# Pitfall demo: nested quantifier (a+)+b vs flat a+b on strings of 'a'
# Both fail on input without a trailing 'b', but backtracking cost differs hugely.
bad = re.compile(r'^(a+)+b$')   # nested quantifier, exponential backtracking
good = re.compile(r'^a+b$')     # flat quantifier, linear time

def bench(pat, s, reps):
    t0 = time.perf_counter()
    for _ in range(reps):
        pat.match(s)
    return (time.perf_counter() - t0) * 1000.0 / reps
计时策略上我做了区分:嵌套版本是指数级的,跑一次就能看出量级变化,reps 取 1;扁平版本太快了,单次测量误差占比太大,重复 2000 次取平均,拿到一个稳定的读数。两个模式都在循环外预编译,排除编译开销的干扰。这样每组对比里,唯一变化的变量就是正则的写法本身。
跑出来的数据
print('len | nested (a+)+b ms | flat a+b ms |   ratio')
rows = []
for n in range(14, 23, 2):
    s = 'a' * n
    tb = bench(bad, s, 1)          # exponential: one run is enough
    tg = bench(good, s, 2000)      # linear: repeat to get a stable reading
    rows.append((n, tb, tg))
    print(f'{n:>3} | {tb:>16.4f} | {tg:>11.5f} | {tb/tg:>7.0f}x')

factors = [rows[i + 1][1] / rows[i][1] for i in range(len(rows) - 1)]
avg = sum(factors) / len(factors)
last_n, last_b, last_g = rows[-1]
print(f'avg growth per +2 chars: {avg:.1f}x -> exponential, not linear')
print(f'flat pattern at len {last_n}: {last_g:.5f} ms, basically flat')
print(f'same input, nested/flat ratio now {last_b / last_g:.0f}x')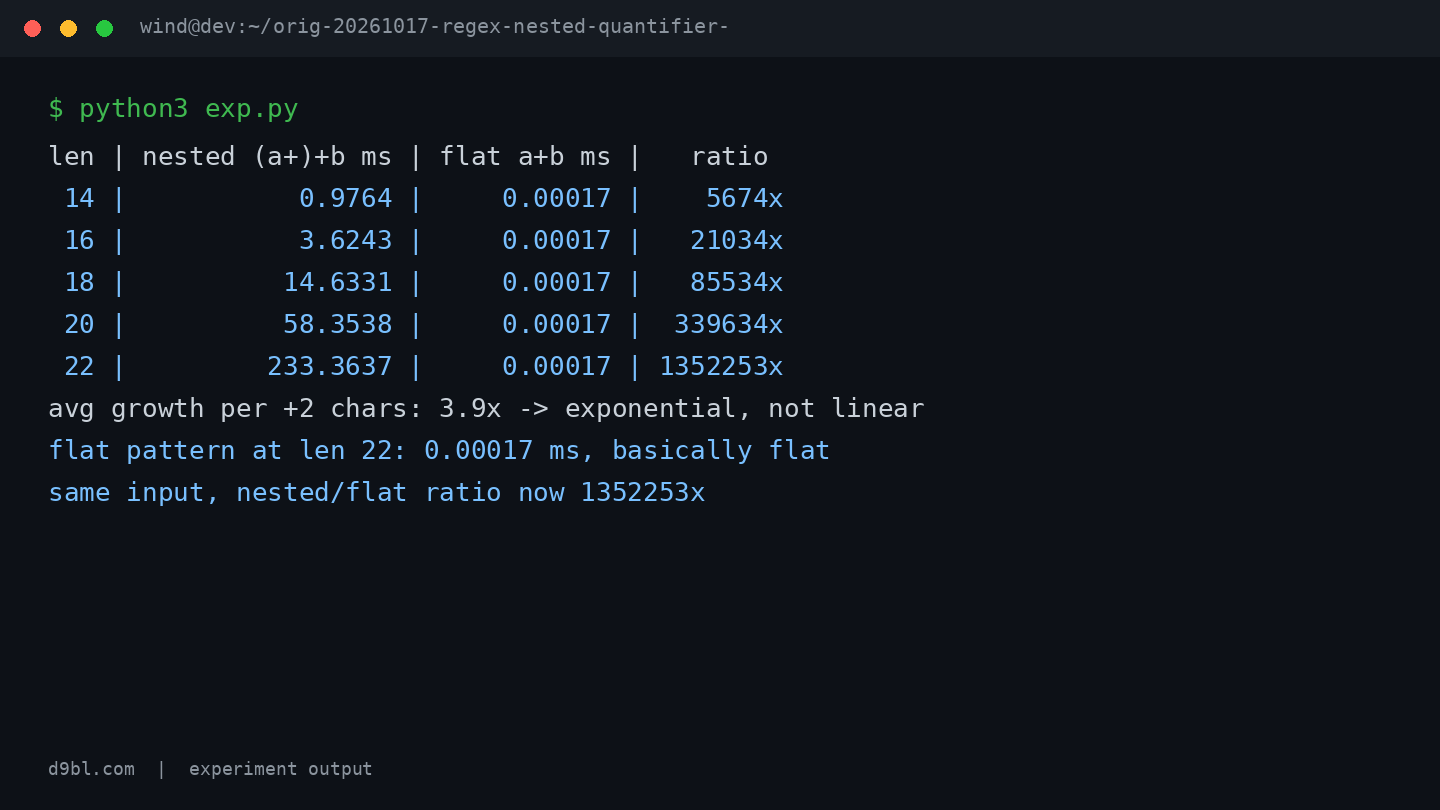
数据比任何解释都有说服力。嵌套版本的耗时从 14 个字符时的 0.9764 毫秒,一路涨到 22 个字符时的 233.3637 毫秒;每增加 2 个字符,平均放大约 3.9 倍——这正是指数增长的指纹,如果是线性增长,每加 2 个字符应该只增加一个近似恒定的时间。而扁平版本在同样的输入下,五个长度点全部稳定在 0.00017 毫秒,曲线基本是平的。
两边的比值是最扎眼的一列:5674x、21034x、85534x、339634x、1352253x。同一个输入、同一个 Python 进程、语义相同的两个正则,只差一层括号,22 个字符的输入上差距已经到了一百万倍以上。而且这个差距还在以每 2 个字符约 4 倍的速度继续拉大——线上那次超时我算是找到凶手了,用户只要粘 40 来个字符,一次匹配就够吃掉一个 CPU 核几十秒。
我原来想错在哪
我最开始想当然的两个判断都错了。第一,我以为正则的时间复杂度跟模式长度挂钩,模式就十几个字符,输入也就几十个字符,怎么算都不该慢——实际上决定成本的是回溯路径的数量,嵌套量词让引擎必须枚举内层 a+ 每种可能的切分长度与外层每种可能的分组组合,这个数量是 2 的 n 次方级别的。第二,我以为慢的是“匹配成功”,恰恰相反,成功路径往往很短,失败路径才要求引擎穷举所有可能性之后才能宣告失败,这也解释了为什么线上是“校验失败的长输入”在拖垮服务。
还有一个反直觉的发现:这 3.9 倍的平均增长比理论上的 4 倍略低,说明除了回溯本身,Python 的 re 引擎还有一些固定开销被摊在测量里,短长度下这部分占比不小。也就是说如果用更长的输入测,指数趋势只会更陡。我原本还想测到 n=30,但在 n=24 附近单次匹配就要接近 1 秒,测下去纯粹浪费时间,这也侧面印证了问题的严重程度——实验本身就被指数曲线逼停了。
这个实验当然有局限。我只测了失败路径,没测成功路径的对比;只测了纯 a 的字符串,没测混合字符下回溯树的差异;Python 的 re 是回溯型引擎,Go 的 RE2 或 Rust 的 regex crate 用自动机实现,理论上不受这个问题影响,我的结论不能直接搬过去。另外 0.00017 毫秒这个读数受机器状态影响,绝对值仅供参考,但“五 个长度点完全持平”这个行为是稳定的。
下次怎么绕开
把这次的经验压缩成几条可以立刻执行的检查。写量词之前先问自己:这个 + 或 * 的里面,还有没有另一个量词?如果 (a+)+、(a*)*、(a|aa)+ 这种形状出现了,先想想能不能用扁平写法表达同样的语义——我这次实验里,扁平的 ^a+b$ 不但快,而且语义完全没损失。改不动写法的时候,加输入长度上限是最便宜的保险,22 个字符就要 233 毫秒的服务,绝不该允许用户提交任意长的输入。
更系统一点的做法,是把可疑正则丢进自动化测试里跑一组长度递增的输入,断言耗时不随长度陡增——这比靠 review 抓出嵌套量词可靠得多,因为嵌套往往藏在几层分组和分支中间,肉眼很难看全。最后留一个开放的思考给你:所有回溯型正则引擎都背着一颗指数级的雷,只是平时的输入太温和没引爆。你项目里那个跑了三年没出事的老正则,是它真的安全,还是那个最恶劣的输入还没被用户粘进来?



