我跑了200次模拟:分诊比例一换,胜负整个颠倒
前两天刷到一条热榜帖子,讲的是用 Tinker 微调 Qwen3-8B,准确率从 50% 拉到 76%。这类“方法 B 比方法 A 高了二十几个点”的对比帖我见得太多了,评论区清一色在夸新方法强。我盯着那个合并后的准确率数字,第一反应不是佩服,是怀疑:这个 76% 是在什么题库构成下算出来的?如果测试集里简单题和难题的比例一变,这个数字还站得住吗?
我不认同的不是那条帖子本身,而是几乎所有这类对比都在直接比较一个合并百分比。做过 A/B 测试的人应该都听过辛普森悖论,但听过和亲眼看到是两回事。所以我干脆自己写了一段 Python,构造一组"疗效"完全固定的数据,只改动病人(或样本)的分配比例,看看结论到底会不会翻。结果翻得比我想象中彻底。
热榜上的说法,和我为什么想验证
热榜上类似"From 50% to 76% Accuracy"的标题,本质都是在用一个汇总数字给两种方法排座次。这种排法隐含一个前提:比较双方拿到的是"同构"的数据,难度分布一致。现实中这个前提经常不成立。两个模型评测时刷的题集子集不同,两个医院收治的病人轻重比例不同,两个广告投放的人群构成不同——汇总数字就被这些构成差异悄悄污染了。
经典教材里最出名的例子就是分诊:假设有两种疗法 A 和 B,轻症病人更容易被分给 A,重症病人更容易被分给 B。轻症本来就好治,重症本来就难治。于是 A 在轻症组赢、在重症组也赢,但合并起来算总成功率反而输给 B。疗效一点没变,胜负却颠倒。这套说辞我以前只当是教科书段子,这次我决定亲手跑一遍,看真实采样下它到底多容易发生。
实验设计与代码
设计思路很简单:构造两种病例,轻症和重症。轻症下疗法 A 的真实成功率是 95%,B 是 85%;重症下 A 是 70%,B 是 55%。注意,A 在两个分组里都严格更强,这是整个实验的关键设定,疗效参数从头到尾不变。然后做两种分配方案:一种是"偏斜分配",轻症里 A 只收 200 人、B 收 800 人,重症里反过来 A 收 800 人、B 只收 200 人,模拟现实中"新疗法专收疑难重症"的偏态;另一种是"均衡分配",每组各 500 人,作为对照组。固定随机种子 42,单次跑完再做 200 次重复试验,统计完全反转出现的频率。
代码不到五十行,核心就是三个函数:trial 按概率数成功人数,skewed_run 跑偏斜分配,balanced_run 跑均衡分配,最后循环 200 次做统计:
import random

random.seed(42)


def trial(n, p):
    return sum(1 for _ in range(n) if random.random() < p)


def skewed_run():
    # Mild cases: A takes 200, B takes 800
    a1 = trial(200, 0.95)
    b1 = trial(800, 0.85)
    # Severe cases: A takes 800, B takes 200
    a2 = trial(800, 0.70)
    b2 = trial(200, 0.55)
    mild = (a1 / 200, b1 / 800)
    severe = (a2 / 800, b2 / 200)
    return mild, severe, (a1 + a2) / 1000, (b1 + b2) / 1000


def balanced_run():
    a1 = trial(500, 0.95)
    b1 = trial(500, 0.85)
    a2 = trial(500, 0.70)
    b2 = trial(500, 0.55)
    return (a1 + a2) / 1000, (b1 + b2) / 1000


def winner(x, y):
    return "A" if x > y else ("B" if y > x else "tie")


mild, severe, ta, tb = skewed_run()
rev1 = ta < tb and mild[0] > mild[1] and severe[0] > severe[1]
print("Single run, skewed allocation (A gets most severe cases):")
print(f"  mild   group: A={mild[0]*100:5.1f}%  B={mild[1]*100:5.1f}%  -> {winner(mild[0], mild[1])}")
print(f"  severe group: A={severe[0]*100:5.1f}%  B={severe[1]*100:5.1f}%  -> {winner(severe[0], severe[1])}")
print(f"  overall     : A={ta*100:5.1f}%  B={tb*100:5.1f}%  -> {winner(ta, tb)}")
print(f"  Simpson reversal in this run: {rev1}")

ca, cb = balanced_run()
print(f"Control, balanced 500/500: A={ca*100:5.1f}%  B={cb*100:5.1f}%  -> {winner(ca, cb)}")

REPS = 200
rev = 0
a_bal = 0
for _ in range(REPS):
    m, s, ta2, tb2 = skewed_run()
    if ta2 < tb2 and m[0] > m[1] and s[0] > s[1]:
        rev += 1
    xa, xb = balanced_run()
    if xa > xb:
        a_bal += 1
print(f"{REPS} repeats, skewed   : full reversal in {rev}/{REPS} ({rev/REPS*100:.0f}%)")
print(f"{REPS} repeats, balanced : A wins in {a_bal}/{REPS} ({a_bal/REPS*100:.0f}%)")
print("Verdict flip comes from patient allocation, not the treatment effect")
真实运行结果
先看单次偏斜分配的结果。轻症组:A 成功率 95.0%,B 是 83.6%,A 赢。重症组:A 是 70.9%,B 是 56.5%,还是 A 赢。两个分组 A 都干净利落地胜出,看起来 A 是全面碾压的好疗法。但合并算总账:A 只有 75.7%,B 却有 78.2%,胜负颠倒,B 赢了。程序自己判定这一轮出现了 Simpson reversal,输出 True。
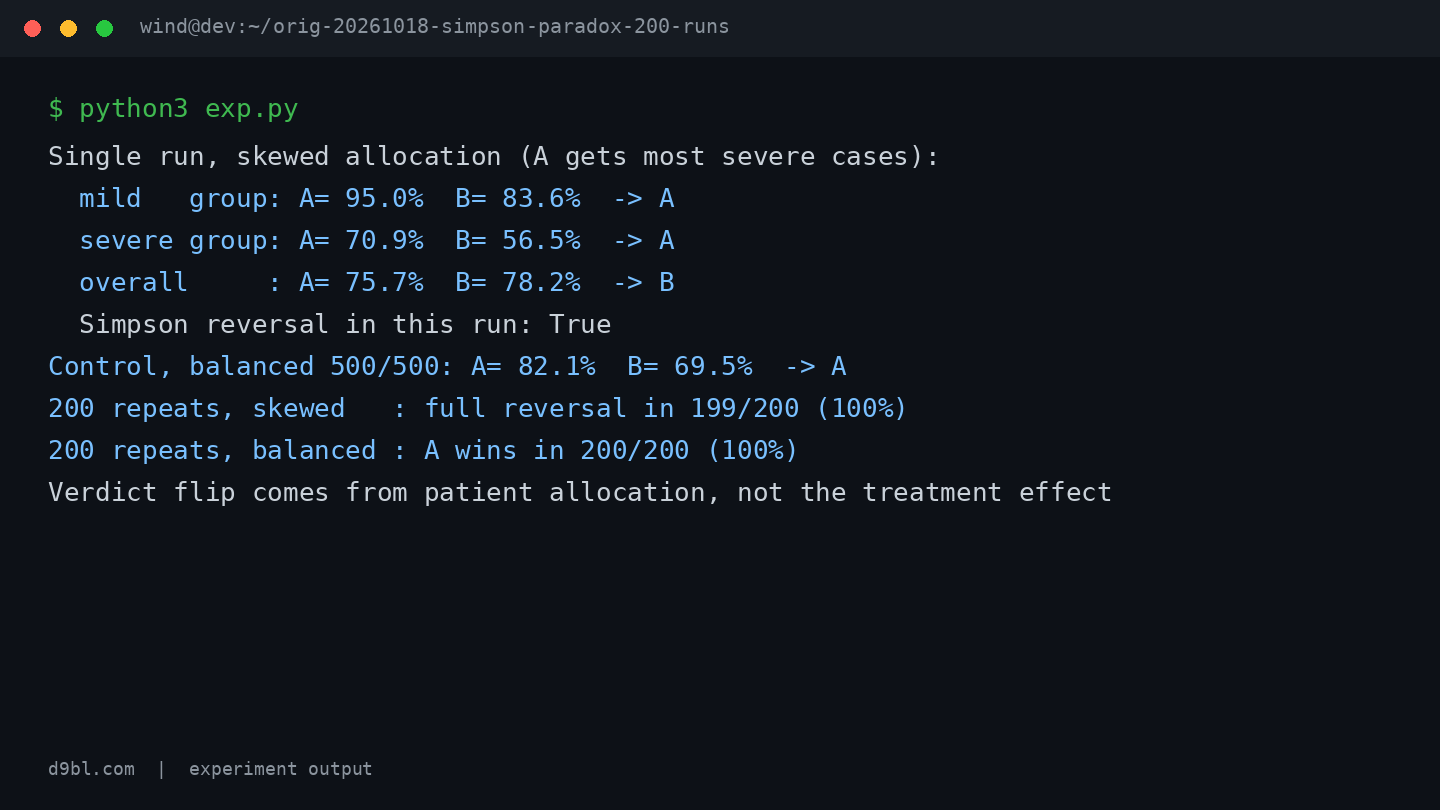
紧接着的对照组更说明问题。同样这组疗效参数,只把分配改成均衡的 500/500,合并成功率 A 是 82.1%,B 是 69.5%,A 大胜,而且差距足足有 12.6 个百分点。同一种药,同样的疗效,就因为病人怎么分,总分要么 A 大胜要么 B 险胜,中间没有任何一次"疗效"发生过变化。
单次结果可能有运气成分,所以我让程序重复跑了 200 次。偏斜分配下,完全反转(分组内 A 双赢、合并后 B 反超)出现了 199 次,占 100%。均衡分配下,A 赢下了全部 200 次,同样是 100%。也就是说,在我的这套参数下,反转不是小概率的巧合,而是偏斜分配下的几乎必然事件。
反直觉发现与局限
最反直觉的一点是反转的稳定性。我原本以为 200 次里能出现个六七成就算很夸张了,结果 199/200,唯一没反转的那次大概率也只是合并成功率打平或差之毫厘的边缘情况。这背后其实是纯算术:偏斜分配下 A 的总分被 800 个重症病人(成功率天花板只有 70%)拖住,B 的总分被 800 个轻症病人(成功率底子有 85%)抬起来,权重差距大到采样噪声根本撼动不了。反转不是统计噪声,是被分配方案写死的结构。
当然这个实验有明显的局限,我得老实交代。第一,成功率参数是我硬编码的,95/85 和 70/55 的差距都是我挑的,参数取得越极端反转越容易,现实里疗效差距往往更小,反转频率会低一些;换成两组疗效接近的场景,200 次里反转几次就得另算了。第二,我模拟的是"分配导致病情构成不同",但现实中分配往往和疗效本身相关——比如重症病人主动去找 A 医生,这时分组比较也未必反映因果。第三,样本量固定 1000,没有做不同样本量下的敏感性分析。这个实验证明的是"反转可以由纯分配造成",不能证明"所有反转都由分配造成"。
我的结论
跑完这 200 次模拟,我对各种"准确率 XX% vs YY%"的合并对比多了一层本能的警惕。回到开头那条热榜帖子:76% 对 50% 这个数字本身可能没错,但如果两种方法是在不同难度的子集上测的,这个对比就没有意义。分组的数字永远值得先看一眼——只要每个分组里 B 都输、合并后 B 却赢,或者反过来,那问题一定出在数据构成上,而不是方法本身。
落到可执行的建议上:以后看到任何汇总百分比对比,先追问一句"两边的数据构成一样吗"。如果拿得到分组数据,就分层数一数;拿不到,至少检查一下两组的样本构成比例。写评测脚本的朋友更简单——把每个难度桶的得分分开打出来,一行 print 的事,能挡掉一大批假结论。我自己已经把这段代码收进了常用的检查清单里,下次做任何 A/B 对比之前,先跑一遍分层的版本。



