每张牌都随机交换过一次,为什么牌堆还是没洗匀?
“把每张牌都和随机一张牌交换一次,牌堆就洗匀了。”这句话我背了很多年,写法牌、抽卡、乱序播放逻辑的时候都这么用过:一个 for 循环,每位和随机一位换一下,看起来每张牌都“动过”,公平得很。直到某天我盯着这段代码突然较真起来——这句话是从哪来的?有人亲手验过吗?我决定用四张牌、二十四万次洗牌,把这条常识放到统计的显微镜下看一遍。
选四张牌不是偷懒。四张牌的全排列一共 4! = 24 种,每种理想概率 1/24,24 万次实验下每种排列期望出现 10000 次,样本量足够把任何系统性偏差从随机涨落里揪出来。牌数再多了排列爆炸,统计就没法看得这么干净。
这条规则是从哪来的
所谓“朴素洗法”的直觉来源很好理解:一张牌只要参与过一次交换,它就“被随机化”了,四张牌都动过,整副牌自然就乱了。这个说法在面试题、老教材甚至一些生产代码里都能见到影子,因为它的代码写出来最顺——正向遍历,每个位置随便挑一个对象交换,逻辑一目了然。
而教科书上真正的答案是 Fisher-Yates:从最后一位往前走,第 i 位只跟它自己或它身后的位置交换。两条规则看着只差一个细节——交换对象是“全范围随便挑”还是“只挑身后的”——但对概率分布来说这个细节是生死攸关的。我把两种洗法都实现了,代码短得可以贴在眼前盯着看:
import random

N = 4

def naive_shuffle(deck):
    # tempting rule: every slot swaps with ANY random slot
    d = deck[:]
    for i in range(N):
        j = random.randrange(N)
        d[i], d[j] = d[j], d[i]
    return d

def fisher_yates(deck):
    # correct rule: slot i swaps only with slots i..n-1
    d = deck[:]
    for i in range(N - 1, 0, -1):
        j = random.randrange(i + 1)
        d[i], d[j] = d[j], d[i]
    return d
两者的随机源完全相同,都是 random.randrange,唯一的区别就是 j 的取值范围。这正好构成一组干净的对照实验:变量只有一个,结果差异全都能归因到这个变量上。
按它推算出的预期
动手跑之前,我先在纸上推了一遍理论预期。朴素洗法的每一次完整洗牌对应一条“交换脚本”:四个位置各挑一个目标,总共 4 的 4 次方 = 256 条脚本,每条等概率出现。但最终状态只有 24 种排列,256 除以 24 等于 10.67,除不尽。这意味着必然有几种排列分到的脚本多、几种分到的少,偏差是数学上写死的,不是运气问题。
Fisher-Yates 那边恰好相反:4 次选择分别有 4、3、2、1 种取法,总共 4! = 24 条脚本,和 24 种排列一一对应,每条排列恰好一条脚本,理论上严格均匀。另外我给自己定了一条判据:24 个自由度下的卡方统计量,95% 置信水平的临界值是 38.1,算出来超过这条线就能拍板说“不是均匀分布”。理想情况下“牌堆纹丝不动”的概率是 1/24,约 4.17%,这两个数后面都要拿来对账。
实验验证过程
实验本体很朴素:固定随机种子 42 保证可复现,两种洗法各跑 240000 次,用 Counter 统计 24 种排列各出现了多少次,再算四个指标——卡方值、最高频与最低频排列的次数之比、“牌堆没变”的频率、以及偏离期望最远的排列的偏差百分比。统计部分的核心代码如下:
from collections import Counter

TRIALS = 240000
PERMS = list(itertools.permutations(range(N)))
EXPECT = TRIALS / len(PERMS)   # 10000 each

cnt = Counter()
for _ in range(TRIALS):
    cnt[tuple(naive_shuffle(list(range(N))))] += 1

chi2 = sum((c - EXPECT)  2 / EXPECT for c in cnt.values())
worst = max(abs(c / EXPECT - 1) for c in cnt.values()) * 100
ident = cnt[tuple(range(N))] / TRIALS * 100
print(f"chi2={chi2:.1f} worst_dev={worst:.1f}% P(id)={ident:.2f}%")
240000 次循环乘两种洗法,在我的笔记本上几秒钟就跑完了。完整的运行结果如下:
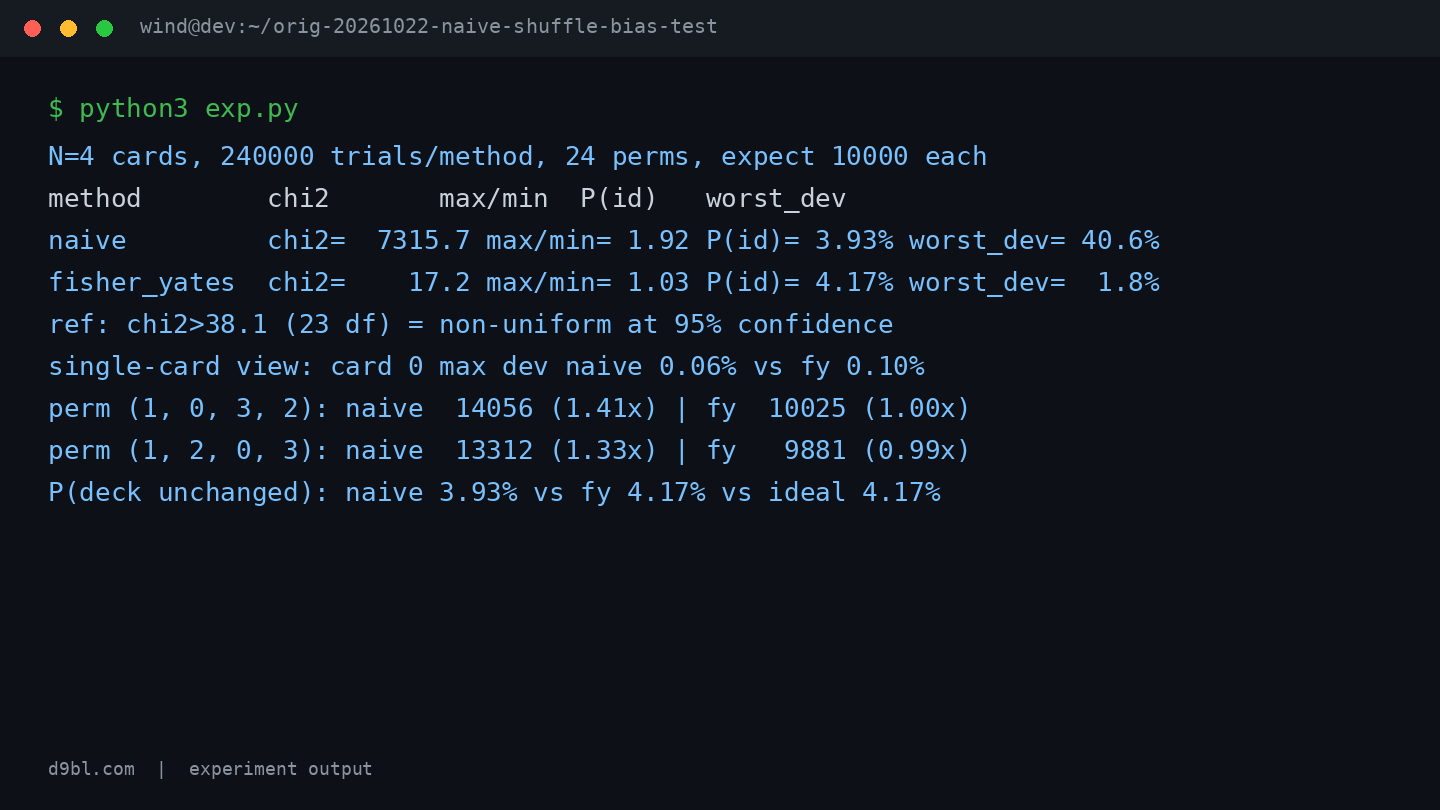
输出第一行确认了实验配置:N=4,每种洗法 24 万次,24 种排列,每种期望 10000 次。真正有意思的是后面那两行对照——两列数字放在一起,差距大到我第一眼以为是统计代码写错了。
数据与理论对上没有
朴素洗法的卡方值是 7315.7,而临界线只有 38.1,超了将近两百倍,均匀假设直接死刑。worst_dev 达到 40.6%,也就是说偏差最狠的那种排列,出现频率比期望值高出四成;最高频和最低频排列的次数比是 1.92,快接近两倍的差距。具体的“重灾区”也找到了:排列 (1, 0, 3, 2) 出现了 14056 次,是期望的 1.41 倍;排列 (1, 2, 0, 3) 出现了 13312 次,1.33 倍。这两种“两对相邻牌互换”的形态被朴素洗法显著偏爱。
Fisher-Yates 那一行完全是另一幅图景:卡方值 17.2,落在 38.1 的置信线以内,worst_dev 只有 1.8%,max/min 为 1.03。抽出来看个别排列,(1, 0, 3, 2) 出现 10025 次(1.00 倍),(1, 2, 0, 3) 出现 9881 次(0.99 倍),和期望几乎严丝合缝。“牌堆纹丝不动”的频率同样是铁证:朴素洗法是 3.93%,Fisher-Yates 是 4.17%,后者和理想值 1/24 分毫不差。纸上推的 256 除不尽 24、必有偏差,和实测的 40.6% 最大偏差,方向和量级都对上了。
边界在哪
这次实验里最反直觉的发现藏在输出末尾:单独看第 0 张牌落在哪个位置,朴素洗法的最大偏差只有 0.06%,甚至比 Fisher-Yates 的 0.10% 还要小。也就是说,如果你只关心“某一张牌在哪”,朴素洗法几乎是合格的;但只要你看整副牌的联合分布,它的卡方就爆表。这解释了为什么这种错误算法能存活这么多年——它骗过了所有只抽查单张牌的测试,只在统计全排列频率时才原形毕露。
实验本身的局限也得说清楚。我只测了 N=4 这一种规模,24 种排列是个便于精查的最小样本,更大的牌数下朴素洗法的偏差形态会不会变化,这次没有覆盖;种子固定为 42,严格说我只检验了一条随机流;随机源是 CPython 的 randrange,伪随机数生成器的品质也被默认为合格。另外卡方检验在 24 万次的样本量下极其灵敏,理论上任何一点微小偏差都会被判死刑,所以真正有说服力的不是“超没超过 38.1”,而是 7315.7 对 17.2 这个两百倍的悬殊对比。
落到可执行的建议只有一句:写洗牌永远用 Fisher-Yates,从后往前遍历,第 i 位只和 i 到 n-1 里挑的位置换,别图省事写全范围交换。更值得带走的是那个教训——“每张牌都动过一次”是一种只在单点视角下成立、在联合分布上彻底失守的均匀,你的测试如果只抽查个体,就永远抓不到这类偏差。



