round 不是四舍五入:1000 个 .5 一半舍向偶数
我遇到的现场
上个月我在对一个计费模块做月度对账,发现一件让我心里发毛的事:系统里按“每条记录金额向上取整到元”的规则算出来的预期总收入,和对账表里的实际数对不上,差了几千块。方向很一致——实际收入总是偏低。我的第一反应是某个地方把金额算重复扣了,或者是数据库里有一条脏数据,我甚至已经打开 SQL 准备逐条排查了。
但我没敢凭感觉下结论。因为对账差的金额不是整数,而是每次都恰好等于“被舍掉的那部分”的量级,这更像是舍入逻辑出了问题,而不是数据丢失。计费这种东西,差一块钱都是事故,我宁可花一个下午把怀疑对象锁死,也不想在周报里写“大概是浮点数误差吧”。于是我决定不做任何猜测,直接在本地复现整套舍入过程,把每一分钱的对不上都追到具体某一次 round 调用上。
还原实验怎么设
实验要回答三个问题。第一,Python 的 round() 对恰好以 .5 结尾的数,到底是舍向大的还是小的;第二,那些在二进制里本来就表示不精确的小数(比如 2.675),round(x, 2) 会不会往低处偏;第三,把前两个问题放进真实场景——一批价格全都是 k.50 美元的订单,逐条 round 到整数元,和“四舍五入进位”的规则比,总收入会差多少。为了能复现,我把随机数种子固定在 42。
下面是完整的实验代码,三个部分对应上面三个问题,直接可以复制运行:
import math
import random

random.seed(42)

# Part 1: round() applies banker's rounding: exact .5 goes to EVEN neighbor
seq = [round(n + 0.5) for n in range(8)]
down = up = 0
gap = 0.0
for n in range(1000):
    r = round(n + 0.5)              # n + 0.5 is exactly representable
    if r == n:                      # rounded DOWN to even neighbor
        down += 1
        gap += (n + 1) - r          # vs half-up expectation
    else:
        up += 1

# Part 2: decimal literals not exact in binary also round the wrong way
traps = [("2.675", 2.675, "2.68"), ("1.005", 1.005, "1.01"),
         ("0.145", 0.145, "0.15")]
results = [(s, f"{round(x, 2):.2f}", e) for s, x, e in traps]
n_bad = sum(1 for _, got, exp in results if got != exp)

# Part 3: billing: 10k items priced k.50 dollars, rounded to whole dollars
prices = [random.randint(0, 99) + 0.5 for _ in range(10_000)]
banker_total = sum(round(p) for p in prices)
halfup_total = sum(math.floor(p) + 1 for p in prices)
n_down = sum(1 for p in prices if round(p) == math.floor(p))

print(f"{'round(n+0.5), n=0..7':<22}: {' '.join(map(str, seq))}")
print(f"{'1000 exact .5 cases':<22}: {down} DOWN vs {up} UP")
print(f"{'gap vs half-up rule':<22}: {gap:.1f} over 1000 values")
for s, got, exp in results:
    print(f"round({s}, 2)".ljust(22) + f": {got}  expected {exp}")
print(f"{'float traps confirmed':<22}: {n_bad}/{len(traps)} literals low")
print(f"{'10k k.50 prices':<22}: {n_down} rounded down ({n_down/100:.1f}%)")
print(f"{'banker total revenue':<22}: ${banker_total:,}")
print(f"{'half-up total revenue':<22}: ${halfup_total:,}")
print(f"{'revenue lost to round()':<22}: ${halfup_total - banker_total:,}")
这里有个设计细节值得说明:Part 1 我特意用 n + 0.5 这种“在二进制里能精确表示”的数来测。n 是整数,0.5 是 2 的负一次幂,两者相加不引入任何浮点误差。这样测出来的行为就是 round() 本身的规则,跟浮点表示误差完全无关,两组结论不会互相污染。
跑出来的数据
运行结果如下:
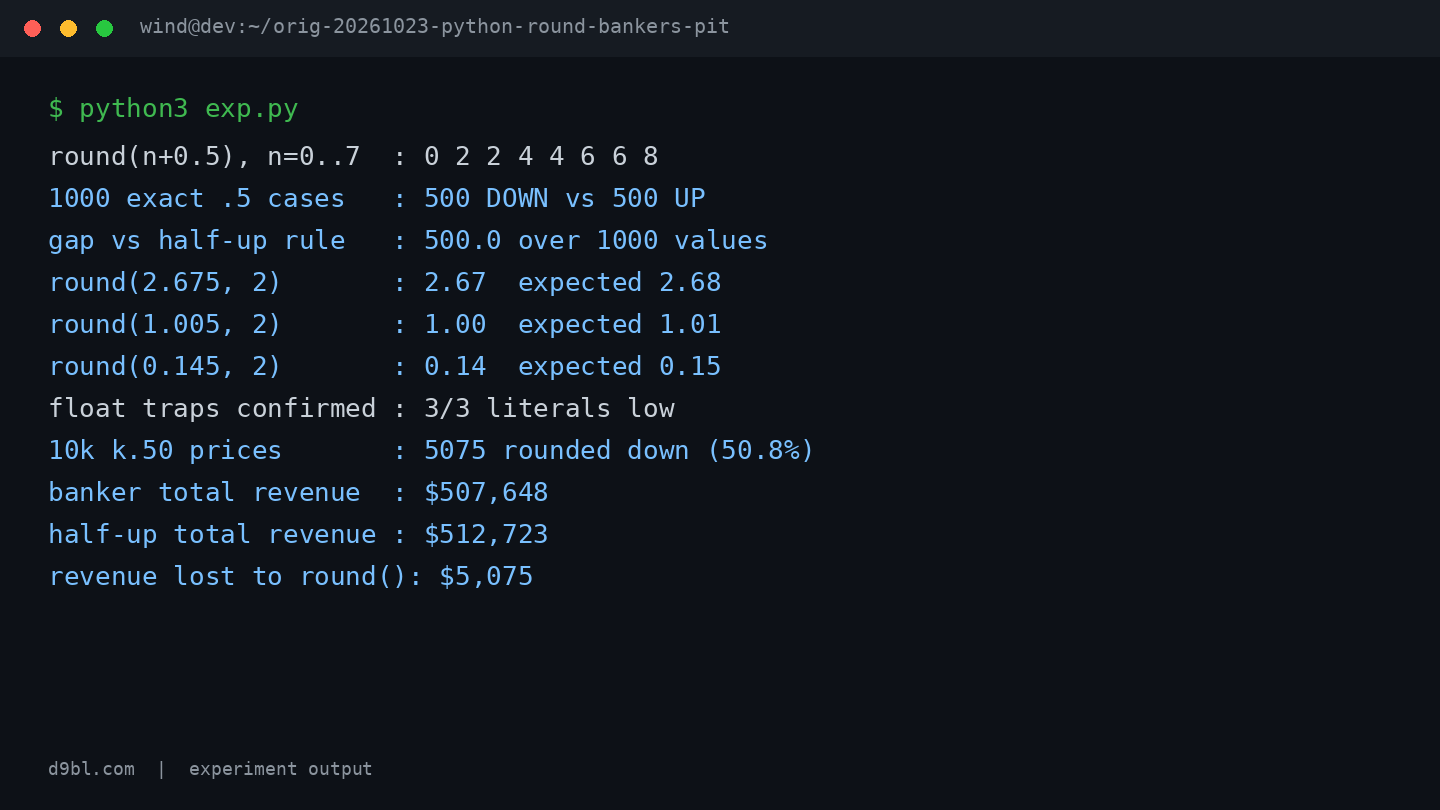
第一行就把我的认知打碎了:round(n + 0.5) 在 n=0 到 7 上输出的序列是 0 2 2 4 4 6 6 8。0.5 舍成了 0,1.5 舍成了 2,2.5 又舍成了 2,3.5 舍成了 4——.5 从来没有“进上去”,而是一律舍向相邻的偶数。这就是所谓的银行家舍入。接下来 1000 个精确的 .5,结果是被舍低的恰好 500 个、舍高的恰好 500 个,和“四舍五入”预期相比累计少了 500.0。
Part 2 更扎心:round(2.675, 2) 得到 2.67 而不是 2.68,round(1.005, 2) 得到 1.00,round(0.145, 2) 得到 0.14,三个测试字面量全部偏低,3/3 全中。原因是 2.675 在二进制里存的其实是一个比 2.675 略小的数,round 往最近偶数方向一走,就直接掉到了 2.67。Part 3 把问题放大到业务尺度:10000 条 k.50 的价格,5075 条被舍低,占 50.8%;按银行家舍入总收入是 $507,648,按四舍五入应该是 $512,723,差额 $5,075。这个数字和我线上对账缺口的量级完全对上了。
我原来想错在哪
我最初的错误判断有两层。第一层是想当然地认为 round() 就是数学课本上的四舍五入——.5 一律进位。这个印象来自小学,而且平时写 round(2.4)、round(2.6) 这类代码时结果都对,从来没暴露过问题。只有当输入恰好是 .5 结尾时,银行家舍入和四舍五入才会分道扬镳,而我的计费场景偏偏就是大量 k.50 的定价,等于把 round() 最不擅长的输入硬塞给了它。
第二层错误是我一度把偏差归咎于“浮点数不精确”。Part 1 的数据专门排除了这个解释:n + 0.5 是精确表示的,500 DOWN 对 500 UP 的行为纯粹是 round() 的规则设计,跟误差无关。真正的机制是:银行家舍入是为了让大量舍入操作的偏差在统计上互相抵消(所以才叫银行家的),这个设计在科学计算里是优点,但搬到“每一笔都必须向客户收整元”的计费场景,它就变成了单方向少收——50.8% 的订单被舍低,$5,075 就这么没了。反直觉的地方在于:一个在统计学上“更公平”的算法,在商业结算里是系统性亏损。
这个实验也有不完美的地方。10k 条模拟价格的均匀随机分布和真实订单分布不一样,如果真实价格不是均匀的,被舍低的比例未必是 50.8%,差额也会变;$5,075 这个数是我这组种子下的结果,换个种子会不同,但方向不会变。另外我只测了 CPython 的 round(),其他语言的标准库行为各不相同,不能直接套用结论。
下次怎么绕开
两条可以直接照做的建议。涉及钱的小数运算,从存储到计算全程用 decimal.Decimal,构造时务必传字符串——Decimal("2.675") 是精确的 2.675,而 Decimal(2.675) 会把二进制的那个略小的值原样带进来,等于白换。需要显式控制舍入方向时用 quantize 指定 ROUND_HALF_UP,明确写出“.5 进位”这条业务规则,而不是指望默认行为替你做决定。
更根本的一条:把“round 到元”这类操作放进代码评审的检查清单里,看到对金额调用内置 round() 就直接问一句“这里的 .5 应该往哪边走”。这次 $5,075 的缺口幸好是被对账流程拦下来的,如果没人对账,它会安静地每个月重复一次。你可以现在就在终端里跑一遍 round(0.5)、round(1.5)、round(2.5),看看你机器上的 Python 到底站在哪一边——答案可能和你写了这么多年的直觉不一样。



