我给“编辑距离防幽灵包”投了反对票,然后自己扫了5档阈值
热榜上那篇《My Local AI Invented 162 Python Packages》我看了两遍,评论区最高赞的一句话判断是“加个编辑距离校验就完事了”。我不太信这个结论,因为编辑距离这东西只能回答“这个名字离某个已有名字有多近”,回答不了“它是不是有人故意抢注的”。于是我自己搭了个合成注册表,把阈值从1扫到5,想看看召回和误报到底怎么走。
结论提前说一半:这两个东西是一起涨的,而且涨得非常对称。我原以为会看到一条“3附近有明显拐点”的曲线,结果看到的是一条几乎斜率为1的直线,中间没有拐点。
热榜那个说法:加一道编辑距离就能拦住幽灵包
那篇文章讲的是一个本地模型凭空编出了上百个 Python 包名,作者从零重跑了一遍,发现其中绝大多数根本不存在。这个现象本身不新鲜,pyPI 上被抢注的空壳包、typosquatting 包,安全圈讲了很多年。真正引发讨论的是后面的处置建议:既然幽灵包只是把真包名改了一两个字符,那就算一下编辑距离,小于等于2就报警。
我反感的正是这句“小于等于2”。这个方案隐含了一个很强的前提:幽灵包和合法新包在距离空间里是两团分得开的云。但任何一天早上新发布的合法包,它同样“不在注册表里”,同样离某个已有包很近,因为好名字早就被占了。新人给包起名的时候,本来就是在“想表达的意思”和“还没被注册的名字”之间反复妥协,最后落到一个跟某个老包差一两个字母的位置上,这是常态,不是攻击。
所以问题变成了:编辑距离分布上,幽灵和合法新包到底重叠多少。光讲道理讲不清,得看数字。我决定造一个能控制真值的数据集,把这条曲线扫出来。
实验设计与代码
我用 12 个音节拼包名,两到三个音节组合,先生成 300 个名字当作“已注册”。再生成两类样本各 150 个:幽灵包是对某个已注册名做 1 到 2 次编辑(删除、插入元音、交换相邻字符),并且保证改完之后不在注册表里;合法新包直接用同一个生成器造新名字,同样保证不在注册表和幽灵集合里。然后用 Levenshtein 距离算每个样本到注册表的最小距离,阈值从 1 扫到 5,统计拦截数、命中、误报、精度、召回和 F1。
import random
random.seed(42)
SYL = ['ka','ro','mi','ten','zu','lo','vex','dra','pol','ni','qua','ser']
def gen(): return ''.join(random.choice(SYL) for _ in range(random.randint(2, 3)))
def lev(a, b):
    prev = list(range(len(b) + 1))
    for i, ca in enumerate(a, 1):
        cur = [i]
        for j, cb in enumerate(b, 1):
            cur.append(min(prev[j] + 1, cur[j - 1] + 1, prev[j - 1] + (ca != cb)))
        prev = cur
    return prev[-1]
# fixed synthetic registry of 300 package names
real = set()
while len(real) < 300: real.add(gen())
real = sorted(real)
def typo(s):
    i = random.randrange(len(s)); op = random.choice('dit')
    if op == 'd': return s[:i] + s[i + 1:]
    if op == 'i': return s[:i] + random.choice('aeiou') + s[i:]
    j = i - 1 if i else 1
    l = list(s); l[i], l[j] = l[j], l[i]
    return ''.join(l)
# 150 ghost names: 1-2 typos of a real name, absent from registry
ghosts = set()
while len(ghosts) < 150:
    s = random.choice(real)
    for _ in range(1 if random.random() < 0.6 else 2): s = typo(s)
    if s and s not in real: ghosts.add(s)
# 150 legit new names not present in the registry yet
fresh = set()
while len(fresh) < 150:
    s = gen()
    if s not in real and s not in ghosts: fresh.add(s)
def mind(s): return min(lev(s, r) for r in real)
gd = [mind(g) for g in ghosts]
fd = [mind(f) for f in fresh]
print('thr  flag   TP   FP  prec   rec    F1')
best = (0, -1.0)
for t in range(1, 6):
    tp = sum(d <= t for d in gd); fp = sum(d <= t for d in fd)
    prec = tp / (tp + fp); rec = tp / len(gd)
    f1 = 2 * prec * rec / (prec + rec) if prec + rec else 0.0
    print(f'{t:>3} {tp + fp:>5} {tp:>4} {fp:>4} {prec:>5.2f} {rec:>5.2f} {f1:>5.2f}')
    if f1 > best[1]: best = (t, f1)
g1 = sum(d <= 1 for d in gd); g5 = sum(d <= 5 for d in gd)
fp1 = sum(d <= 1 for d in fd); fp5 = sum(d <= 5 for d in fd)
gb = sum(d <= best[0] for d in gd); fb = sum(d <= best[0] for d in fd)
print(f'mean min-dist: ghosts {sum(gd)/len(gd):.2f}, fresh {sum(fd)/len(fd):.2f}')
print(f'ghosts caught: t=1 {g1}/150, t=5 {g5}/150')
print(f'fresh flagged: t=1 {fp1}/150, t=5 {fp5}/150')
print(f'best F1 at t={best[0]}: recall {gb/150:.2f}, false positives {fb}/150')
这里有两个刻意的选择。一是用合成名字而不是真实 PyPI 快照,因为只有合成数据我才知道每个样本的真值标签,不然“这个名字是抢注还是正常新包”本身就要人来判,实验就没法闭环了。二是让幽灵的编辑次数有分布(六成一次,四成两次),因为真实的 typosquatting 不会都只改一个字符,很多人会故意改两个让你一眼看不出来,这是攻击方的基本操作。
真实运行结果
跑出来的表比我预想的难看。阈值 1 的时候只拦了 104 个,其中 71 个是真幽灵,33 个是合法新包,精度 0.68,召回只有 0.47。到阈值 2,拦截数直接跳到 276,命中 137,误报 139,精度掉到 0.50,召回拉到 0.91。阈值 3 是 298 个里 148 命中 150 误报,阈值 4 和 5 完全一样:300 个全拦,150 个真幽灵,150 个合法新包,召回 1.00,精度 0.50,F1 0.67。
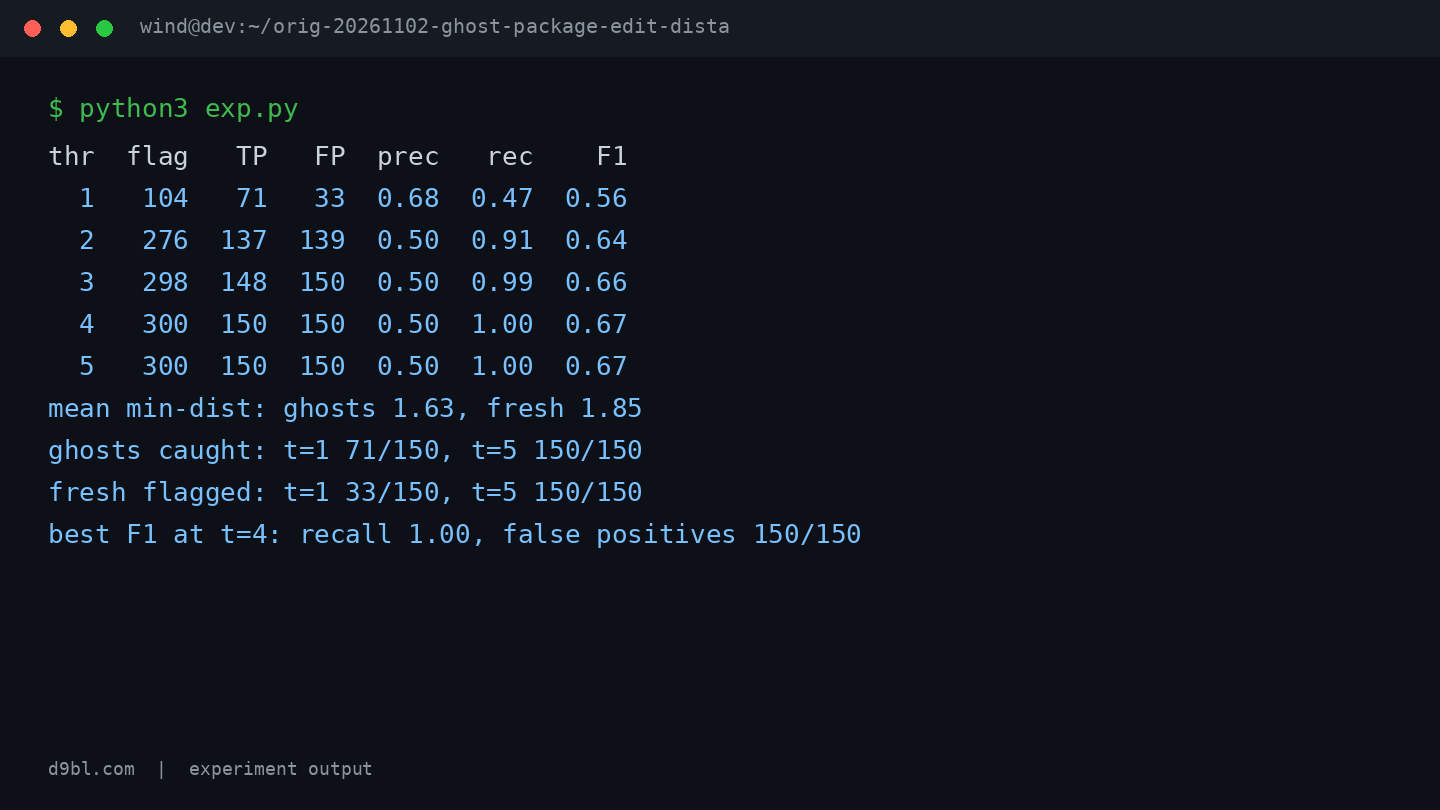
最能说明问题的是最后那行均值:幽灵包到注册表的最小距离平均是 1.63,合法新包是 1.85。差了 0.22。你拿一个 0.22 的间距去做二分类,还要在一个阈值上同时要召回要精度,这不是调参能解决的问题,这是两个分布根本就没有分开。我把阈值从 1 提到 5,本质上是把判定边界从这团重叠区的左边挪到右边,中间无论停在哪里,都是在用召回换误报,汇率约等于 1:1。
阈值 1 的召回 0.47 还有个具体原因:幽灵里有一部分是两次编辑的,两次编辑之后距离可能变成 2 甚至更远,阈值 1 根本够不着。所以“只报距离 1”这个保守策略,代价是放过了一半以上的攻击样本,而这些恰恰是更隐蔽的那一半。
反直觉发现与局限
第一个反直觉的点是 F1 选出来的“最优阈值”是 4,而阈值 4 意味着把所有东西全标成幽灵。这不是模型的胜利,是我的评估指标和样本比例合谋出来的假象。我用了 150 比 150 的平衡样本,在这个比例下“全标”能拿到 0.67 的 F1,看着像模像样。但真实的包注册场景里,一天新增的合法包和幽灵包根本不是 1:1,可能是几百比一,那时候 0.50 的精度会直接塌到接近 0,而 F1 这个数字还会假装自己很体面。用平衡集调不平衡问题的阈值,是我这次实验设计里最大的漏洞。
第二个局限更要命:我的名字空间太窄了。12 个音节、2 到 3 个音节组合,全部可能的包名只有 12² 加 12³,也就是 1872 个,而我在里面塞了 300 个已注册名,占了六分之一。这意味着一个随机生成的新名字,有相当高的概率天然就离某个老名字只有一步之遥——阈值 1 那 33 个误报,很大一部分是这么来的,不是我的检测器笨,是我的世界太小。真实 PyPI 有几十万个包名,稀疏得多,合法新包被误伤的概率会明显低于我这里的 33/150。
第三个是我自己没算准的地方。我原本按 0.6 的概率估,150 个幽灵里应该有 90 个左右是单次编辑,那阈值 1 就该抓到 90 个上下,实际只抓到 71 个。差额我怀疑出在去重上:单次编辑更容易撞上已注册名或者已经在集合里的幽灵,撞了就被丢弃重掷,反复重掷之后,两次编辑的样本在最终集合里被相对放大了。这只是我从代码逻辑倒推的猜测,我没有单独统计过最终集合里单双编辑的真实比例,所以这条不算结论,算一个我该补做的测量。
还有几个明显的窟窿:Levenshtein 是纯字符级的,它不知道“ka-ro”和“ro-ka”在发音上是不是一回事,也不知道连字符、数字后缀、-python、-official 这类抢注常用套路,而真实的恶意包恰恰爱用这些特征。我的合成名里没有大小写、没有连字符、没有下划线,这三样在真实数据里都是强信号,我一个都没测。
我的结论
编辑距离阈值不是不能用,但它不能单独当判据,尤其不能当拦截器。如果你现在正在写这个检查,我建议把阈值钉死在 1,并且只对“被模仿的那个目标包本身足够流行”的情况报警——一个下载量极低的老包被改了一个字母,没有攻击价值,不值得打扰任何人;反过来,一个高下载包出现了距离 1 的同名变体,那基本可以确定是冲着它来的。宁可漏掉两次编辑的隐蔽样本,也别把新包的作者拦在门外,因为前者只是少抓一个,后者是直接劝退一个真实的贡献者。
真正想把召回做上去,靠调阈值这条路是走不通的,得往外找特征:注册时间、下载量曲线、维护者账号年龄、名字里的连字符和数字模式、是不是刚注册就发了同名的安装脚本。我这次实验能证明的只有一件事——单靠字符距离,幽灵和新人站在同一个位置上,你没法定性谁是谁。下一步我打算把真实的 PyPI 元数据拉进来,用下载量做个加权,看看同样的 5 档阈值在真实分布上会不会至少出现一个不那么难看的拐点。