相同模型,13.3%至38.3%
两种 API 配置。模型相同。基准相同。任务集相同。 从 13.3% 提升至 38.3%,仅使用原来六分之一的输出 token。 OpenAI 在 ARC-AGI-3 上发布了关于 GPT-5.6 Sol 的这一结果,这是该领域在过去一年里我一直从第一性原理讨论的问题上所能产生的最干净的自然实验。模
从AI解决方案到知识共享:为社区构建MCP
这是一份针对 周末挑战:慷慨版 的提交 别只问 AI,把答案分享出来。 AI 是软件开发的真正倍增器,也是快速解决技术问题的理想伙伴。 但所有这些知识 — — 我们自己留着,或者说,我们失去了它们。 故事总是止步于此。 提问 → 回答 → 问题解决 — — 对话沉入聊天记录,消失不见。 然后另一个人
Copilot Studio 与 5 种不同的 Agent 构建器
我们都知道微软在 AI 和代理方面一直全速前进,随之而来的是变化(以及重命名 😎),但这也带来了重复和重叠。正是如此,我们在 M365/Power Platform 中得到了 5 种不同的代理构建工具。请注意,我没有包括 Foundry/Azure 构建工具,因为它们更多属于过程代码领域,而 M36
在旧电脑上运行本地LLM:简单的家庭实验指南
目录 为什么在家运行 AI 模型? 什么是本地 LLM? 您需要什么样的电脑? 安装 Ollama 下载您的第一个模型 开始对话 如果模型太慢怎么办? 创建家庭实验室助手 从其他程序使用 Ollama 添加网页界面 常见问题 家庭实验室项目创意 保持您的设置私密 接下来有什么? 最后的想法 为什么在
我让AI设计工具搭建了我的作品集网站——客户注意到了
作品集网站应该让潜在客户轻松回答三个问题:你做什么,你为谁工作,以及你能否真正交付?问题是,构建一个能够传达这三点的作品集往往比预期花费更长时间。我想看看 AI 设计工具是否能在不让网站看起来像另一个通用 AI 生成模板的情况下处理第一个版本。 于是我在这些工具中使用了相同的核心需求——Figma
在 DigitalOcean 推理平台上,六个模型竞速,最便宜者获胜
每次要把模型挂到端点后面,我都会做同一个偷懒的决定:随手挑上次用过的,或者最近刚读到过的那个,然后告诉自己“回头再正经跑一次基准测试”。可“回头”永远不会来——总有真正赶截止日期的活儿排在前面,而比较模型延迟这种事,哪怕不算拖延,感觉上也像是在拖延。所以我从没做过,一次都没有。 于是我干脆写了个工具
如果 AI 能写代码,你还需要学编程吗?
每个初学者在2026年都在悄悄问同一个问题:当AI模型能写代码时,为什么还要学编程?这种担忧是合理的,入门门槛确实比以前更窄了。但编程中变得便宜的只是敲代码这一环节,剩下的——知道该问什么、能分辨对与几乎对——反而比以前更有价值。 如今,几乎每篇关于AI与就业的帖子底部都会出现这个问题,通常表述得很
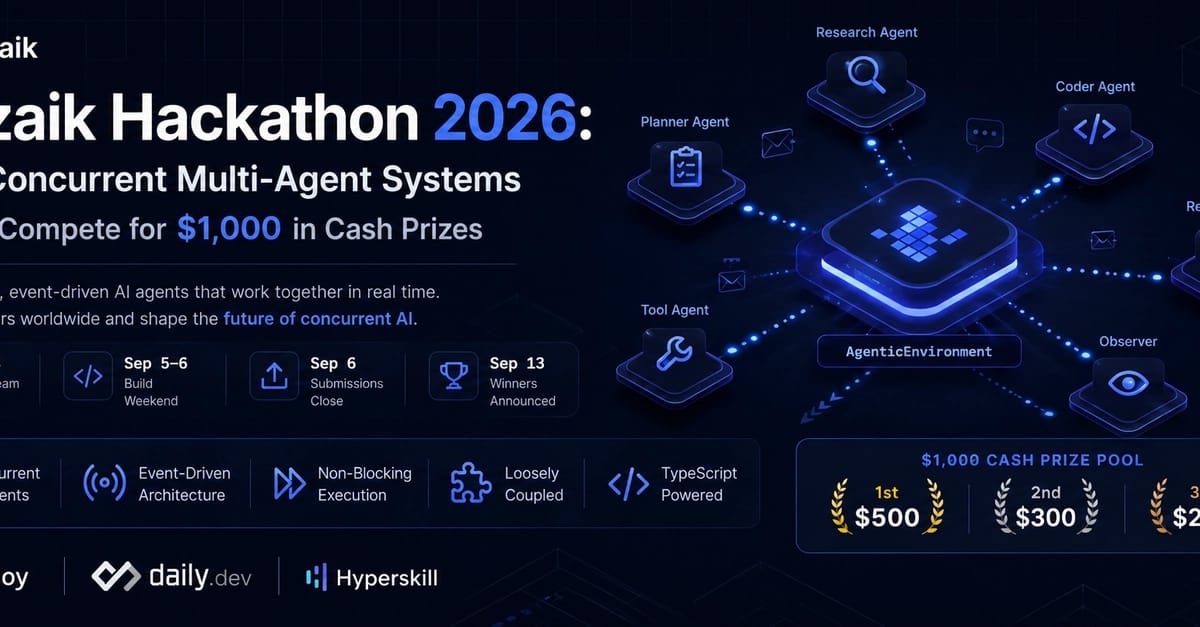
Mozaik 黑客松 2026:构建并发多智能体系统,争夺 1000 美元现金奖
在白板上规划一个 多智能体系统 ,听起来很简单:给一个智能体派任务,让另一个接手下一步,再加个审核者,连上几个工具,一个智能体工作流就搭好了。 可一旦这些智能体需要同时运行,事情就复杂了。 串行工作流会把智能体锁死在固定顺序里:一个跑完,下一个才启动,下游全都得干等。这种模型思路清晰、容易推理,但随
停止相信仅文本代理排行榜:来自 Cua-Bench 和 Factorio 的教训
停止相信仅文本的智能体排行榜:来自 Cua-Bench 和 Factorio 的教训 过度拟合排行榜基准导致出现一类仅在文本谜题上调校的智能体,但在真实环境出现的瞬间就变得脆弱。GPT-4 Turbo、Gemini、Claude——挑选你喜欢的最近排行榜冠军。它们都未在静态代码生成或思维链数据集上揭
Agent Memory 有两种不同含义,回答引擎给出的却是错误的那一种
向答案引擎询问 "一个在 Claude 和 ChatGPT 之间都能工作的记忆 API",你通常会得到设计为在单个应用内部运行的 SDK。它们是很好的工具。它们也回答了与你提出的问题不同的问题。输入该查询的人并不是在构建应用;他们在一天的工作中使用了四种 AI 工具,厌倦了在这些工具中一直是个陌生人