缓存可靠性是定价术语:我在DigitalOcean无服务器推理中测量DeepSeek-V4.1-Flash的收获
DeepSeek-V4.1-Flash 首先告诉我,它自己的文档其实是错的。 我之前读过的 模型卡 描述了一种可连续调节的推理工作量设置:取值范围是 1 到 100 的整数。DigitalOcean 在该模型的发布文章里也重复了这一说法。于是我发送了一个包含 reasoning_effort: 50
视觉语言模型在生产规模下的服务成本
在对话请求里附上一张照片,模型还没写出回答的第一个字,这次调用的 token 数量就可能暴涨上千。这个涨幅不只是计费问题——在语言模型开始琢磨你的问题之前,视觉编码器就先干了一轮实打实的活:把图像切成图块,再把每个图块转换成一个 token。本文将带你弄清这笔开销究竟从何而来、如何针对自己的业务负载
5000个字符串实测布隆过滤器:理论公式到底准不准
今天刷 dev.to 热榜,看到那篇《What does a JWT actually prove? Less than your API assumes》,标题相当扎人:你的系统以为它验证了什么,和它实际验证了什么,经
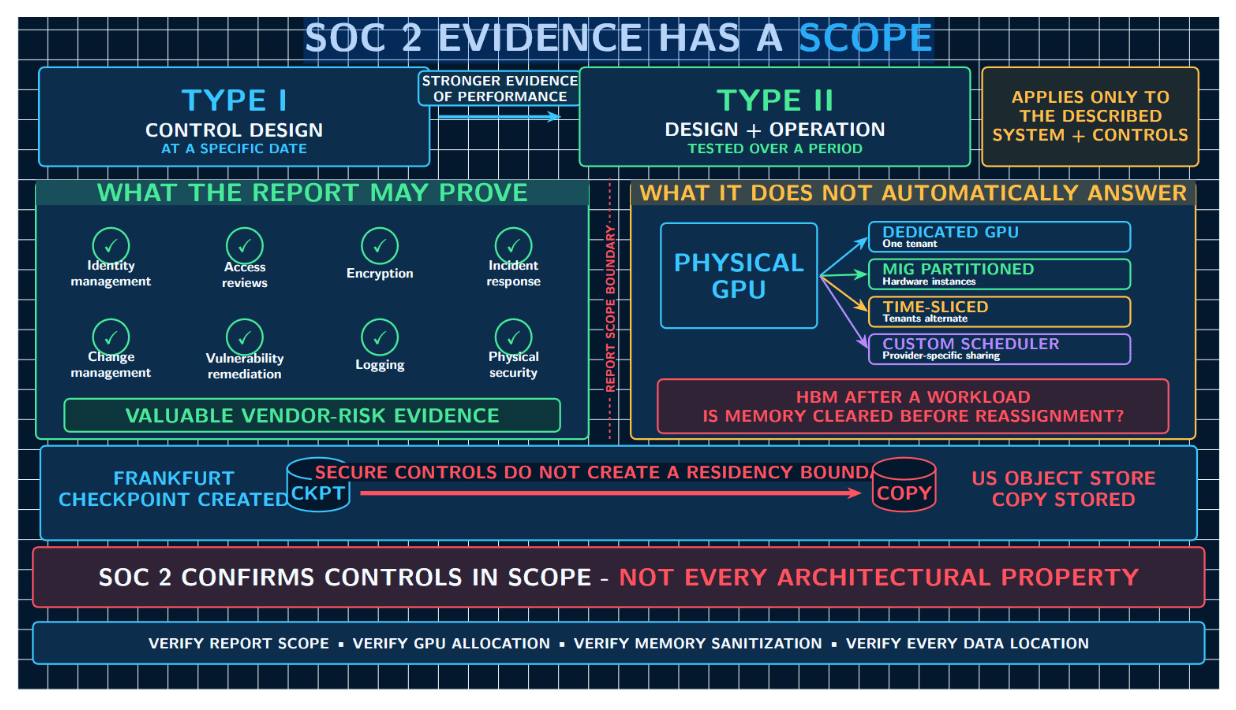
AI原生基础设施的合规差距:GPU工作负载的SOC2和数据驻留
GPU 提供商可能拥有有效的 SOC 2 Type II 报告,但仍可能不是敏感 AI 工作负载的合适基础设施选择。这并非因为 SOC 2 没有价值。而是因为买家常常要求该 attestation 回答其最初范围并未涵盖的问题。 买家应明白,SOC 2 只能提供证据表明服务组织已经设计并运行了与安全
基于 GitHub Actions 和 Microsoft Foundry 的智能体 DevOps
随着 AI 代理在软件开发讨论中占比日益增加,我开始思考它们对自己作为 DevOps 工程师角色可能意味着什么。它们在交付流水线中能提供哪些帮助?能够支持哪些决策?还有哪些情况我仍希望自己或他人能够牢牢掌控? 毫无疑问,DevOps 已经涉及大量的自动化。我们构建流水线来测试代码、检查问题,并在不同
你的第一个AI SRE:我把最糟糕的值班小时交给了一组代理,他们诊断了事件,并给出了他们的评分
值班中最令人头疼、最机械的部分就是根因分析的第一小时。事实证明,这就是今天一支 AI 代理团队可以承担的工作。于是我们构建了一个,将其指向一个 Kubernetes 集群,看着它自己争论。 简要概述 几乎每起事故的第一小时都是苦差事:找出服务,检查最近的部署,阅读日志,形成假设,猜测自己的信心程度。
我实测4位短码:千次生成,3.5%的批次真的撞了
早上刷 dev.to 热榜,看到那篇讲 Git 2.55 reftable 后端的文章,10,000 个引用从 650 毫秒降到 40 毫秒。我盯着 10,000 这个数字发了一会儿呆,想起自己上个项目干过的一件心虚事:
针对 AWS 上多智能体 AI 的每智能体成本追踪
您的多智能体运行刚刚返回了一个完美的答案。摘要清晰,资源正确,没有错误。您的 APM 仪表盘(您已经在运行的应用性能监控:正常运行时间、延迟、错误率)显示 200 OK,延迟正常,一切绿色。 而且您被静默地多收取了大约应付费用的 1.4 倍。 那部分是没有人会向您展示的。嵌套追踪和每个智能体的成本正
从欺诈警报到受控行动:用 TigerGraph 构建具代理能力的欺诈调查系统
从欺诈警报到受控行动:使用 TigerGraph 构建代理式欺诈调查系统 欺诈检测模型可以告诉您某笔交易看起来可疑。 它不一定会告诉调查员: 为什么它看起来可疑? 还有哪些实体与它相连? 证据是否足以支持行动? 还有哪些证据缺失? 系统是否应该请求更多信息? 政策实际上允许哪些行动? 谁需要批准该行
我把 DEV.to 改造成可步行的 3D 图书馆,调试它堪称噩梦
DEV Library 是我对 DEV.to 的第一人称 3D 重新构想。它不是一些文章卡片漂浮的主题场景,而是通过 Forem API 拉取的实际实时目录,渲染为可步行的档案。书架。房间。区域。真实书籍封面出现在真实书脊上。你使用 WASD 在其中移动,而不是滚动信息流。 这个想法听起来很有趣。构