介绍
搜索“如何部署 AI 模型”,每次得到的答案形状都一样。用 FastAPI 或 Flask 应用包装模型。放进 Docker 容器。推送到 GPU 实例或 Kubernetes 集群。添加健康检查。完成。
这个答案正确。它也是简单的部分。
大多数使用开源模型构建的团队在一天或两天内就能得到一个可用的端点。模型加载,请求进来,token 输出。随后第一波真实流量到来,随之出现一组不同的问题。端点在空闲期后对第一个请求的响应时间达到 90 秒。GPU 费用是估算的五倍。GPU 本身利用率只有 15%,而用户在排队等待。这些问题并非由部署步骤失误导致,而是因为没有考虑部署之后会发生什么。
本文的观点很简单:问“如何部署模型”是错误的第一个问题。正确的第一个问题是“我回答一次请求的成本是多少,为什么。”一旦你梳理了冷启动、GPU 利用率和每次推理的成本,部署决策基本就会自然得出。容器、框架和编排器只是遵循经济学的细节,而不是反过来。
这里没有逐步部署教程。网上有很多那样的教程。相反,本文将逐步讲解决定生产环境中模型是否负担得起的三个因素:模型准备好服务所需的时间,实际使用的 GPU 比例,以及把所有费用加起来后每个请求的成本。在此过程中,它用直观的数字展示了这些计算,以便你能为自己的模型进行同样的运算。
为什么部署问题感觉重要
部署问题之所以被频繁提起,是因为它是人们遇到的第一道墙。在笔记本里运行模型是一回事,让它响应他人的 HTTP 请求是另一回事。这一步涉及新工具(容器、服务框架、GPU 驱动),而这些工具本身就有棘手的地方。
但请注意,部署问题并未询问:
- 它不询问请求到达的频率,或者是否会成批到达。
- 它不询问响应需要多长时间才会让用户放弃。
- 它不询问单个 GPU 同时能处理多少请求。
- 它不询问单个请求的成本,或者产品是否能承担该成本。
忽略这些问题的部署仍然能够运行,只是成本更高。这种费用不会出现在部署教程里,而是会在一个月后的发票上体现。
本文其余内容将讨论这些被遗漏的问题。
推理的成本结构(通俗解释)
在深入探讨这三个问题之前,先明确你到底在为什么付费。使用 GPU 时,你租用的是时间,而不是请求或 token。无论 GPU 每秒处理 200 个请求还是空闲等待下一个请求,计费速率都保持不变。
这一事实决定了其他一切。以下是使用整数近似值的一个粗略示例:
- 一张高端 GPU(例如 H100 级别的显卡)在大多数云平台上的租金大约在每小时 2 到 4 美元之间。为便于计算,这里取 3 美元。
- 该 GPU 在运行 7B 或 8B 参数模型且配备良好的服务框架时,在满负荷处理众多请求时,每秒可输出几千个 token 的数量级。
- 满负荷情况下,这相当于每小时约 1000 万个 token,即每百万 token 大约 0.30 美元。
- 利用率仅为 10% 时,你仍需支付 3 美元,但只能产出十分之一的 token。此时实际成本约为每百万 token 3 美元,是之前的十倍。
在这两种情况下,模型本身并未发生变化。唯一变化的是租用时间中用于有效工作的比例。这就是为什么应该关注利用率而非部署情况。
接下来的三个小节将探讨最常导致该指标偏离的三个因素。
问题一:冷启动
冷启动指的是从“请求到达但模型尚未就绪”到“模型输出第一个 token”所经历的时间。这是三个问题中最明显的一个,因为用户能够直接感受到。
时间花费在哪里
大模型的冷启动包含多个阶段,每个阶段的速度都慢于人们的预期:
- 容器拉取与启动。 包含 CUDA、PyTorch 以及类似 vLLM 或 TensorRT-LLM 框架的服务镜像通常为 10 到 20 GB。如果节点上未缓存,从注册中心拉取该镜像可能需要一到几分钟。
- 权重下载。 模型权重体积较大。16 位精度下的 7B 模型约为 14 GB,而 70B 模型约为 140 GB。以每秒 1 到 2 GB 的实际速度从对象存储拉取这些权重,所需时间介于 10 秒到超过两分钟之间。
把这些加起来,中等规模模型的冷启动通常需要两到五分钟;70B 模型可能更久。发送聊天消息的用户不会等那么久。
这实际上是一个成本问题
显而易见的办法是永不让模型处于冷状态——始终保持至少一个副本运行。这确实有效,也是大多数团队的做法。但这样意味着:无论是否有人使用,你都要为 GPU 付费 24 小时。按每小时 3 美元计算,一直开启的单个 GPU 每月约需 2,200 美元,即便尚未服务任何请求也已经产生这笔费用。
于是冷启动问题变成了一种权衡:
- 保持副本温暖并为空闲时间付费,这会降低利用率、提高每请求成本。
- 将规模缩至零并接受数分钟的延迟,这会驱走用户。
- 投入工程时间使冷启动更快,从而让按需缩至零变得可以接受。
没有任何部署命令能够解决这个问题。这是一个成本决策,你需要根据流量模式来做出选择。
实际上是什么缩短了冷启动
如果你选择第三种方案,以下这些杠杆是关键:
- 将权重烘焙到镜像或本地卷中。 避免在每次启动时从对象存储下载;使用本地 NVMe 磁盘或预先挂载的卷,可以把两分钟的下载缩短为 20 秒的磁盘读取。
- 使用更小的权重。 将权重量化到 8 位或 4 位,可使其大小减半或降至四分之一;数据量变小意味着启动更快,而且通常也需要更少的 GPU 内存。
- 预热框架。 某些框架允许你保存已编译的产物,这样预热步骤就不会在每次启动时重复。
- 在节点上保持容器缓存。 如果你掌控节点,可以预先拉取服务镜像,使得第一阶段几乎不产生开销。
每一点都能带来实际的改进。但请注意,这些技巧在标准部署教程中很少出现,因为它们并不是关于如何让模型运行,而是关于如何让模型以低成本运行。
问题二:GPU 利用率
这是大多数团队都未觉察的问题,因为表面上一切正常。端点能够响应,延迟也正常。实际上 GPU 只是在做远低于其能力的工作。
为什么在处理请求时 GPU 会闲置
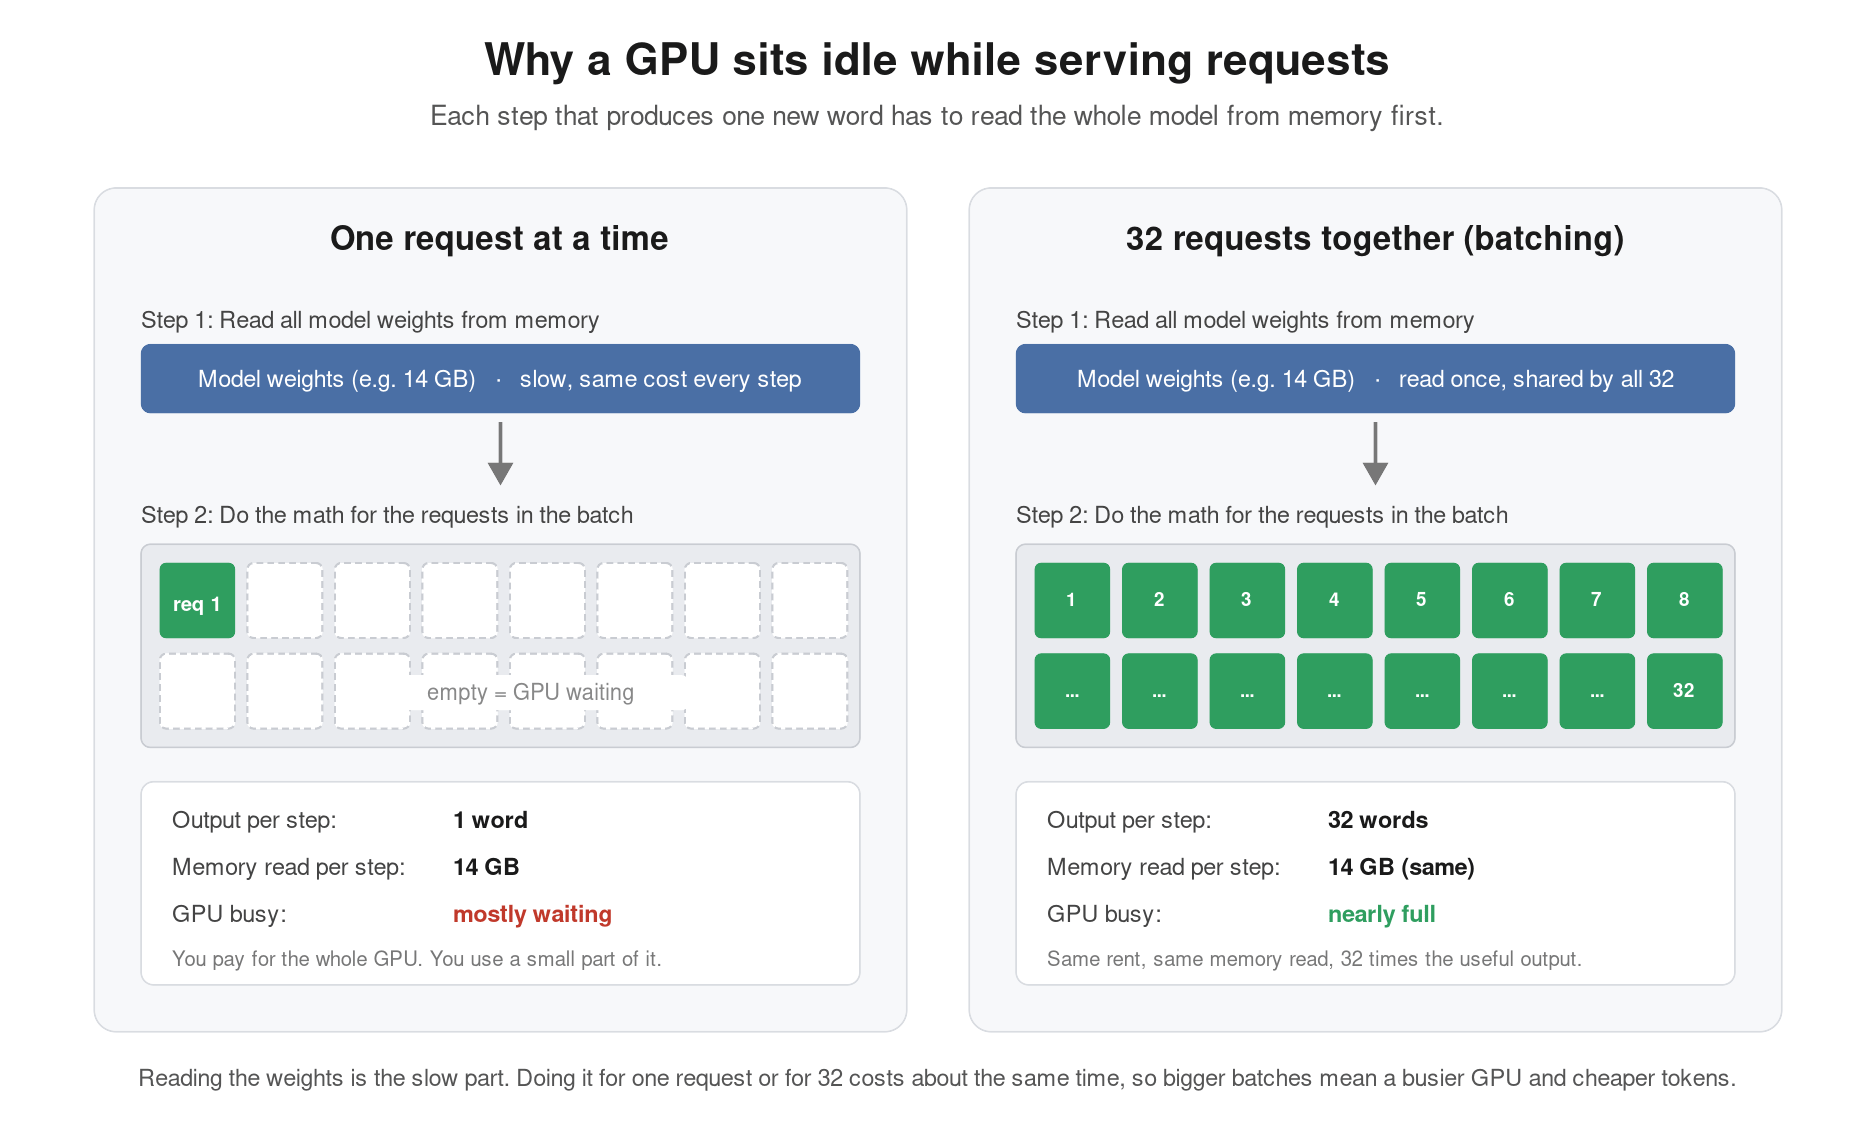
左侧:一次只处理一个请求。模型权重在每生成一个新词时都要从内存读取,此时大部分 GPU 处于空闲。右侧:一次处理 32 个请求。权重只读取一次,被所有 32 个请求共享,GPU 始终保持忙碌。硬件相同,租金相同,产出提高 32 倍。
LLM 推理分为两个阶段。第一阶段称为 prefill,负责处理输入提示词;这一阶段计算量大,能够充分利用 GPU。第二阶段称为 decode,逐个生成输出 token。每一步都需要从内存读取完整的模型权重来产生一个 token,此时 GPU 大部分时间都在等待内存,而不是进行计算。
如果一次只处理一个请求,decode 阶段会让 GPU 的大部分算力闲置。权重在生成每个 token 时都会被读取一次,对应单条序列。算术单元大部分时间都在等待。
使用批处理可以解决这个问题。如果一次处理 32 个请求,每次 decode 步骤仍然只读取一次权重,但能够一次产出 32 个 token,而不是 1 个。内存开销几乎不变,而有效输出提高了 32 倍。
这就是导致在相同硬件上运行相同模型的不同团队,每 token 成本相差悬殊的主要原因。一个团队使用 batch size 为 1,另一个团队使用 64。硬件成本相同,但产出却不同。
连续批处理及其重要性
简单批处理有一个弱点:批处理中请求完成时间不一致。如果一个请求需要 50 个 token,另一个需要 500 个 token,则短请求会提前结束,对应的槽位会保持空闲,直到整个批处理完成。
现代服务框架通过连续批处理解决了这个问题。当一个请求结束时,新请求会立即占用该槽位,即便是在批处理进行中。这样 GPU 能够保持满负荷。这是 vLLM、TensorRT-LLM、SGLang 等框架相比原始 PyTorch 循环能够显著提升性能的主要原因之一。它们并没有让模型运行得更快,而是提高了 GPU 的利用率。
内存才是真正的瓶颈
批次大小受 GPU 显存限制。每个活跃请求都需要为其 KV 缓存分配空间,KV 缓存存储中间注意力值,以免为每个新 token 重新计算。KV 缓存会随序列长度和批次大小而增长。
具体来说:
- 模型权重占用固定内存。16-bit 的 7B 模型大约占用 14 GB。
- 剩余显存可用于 KV 缓存。在 80 GB 显卡上,大约剩余 60 GB。
- 每个请求的 KV 缓存大小取决于其长度。对于 7B 模型,4,000 token 的上下文可能需要几百兆字节。更长的上下文需要更多。
- 因此,最大批次大小大约等于“剩余显存除以每个请求的 KV 缓存”。较长的提示词意味着并发请求减少,利用率降低。
这就是为什么量化能提高利用率,而不仅仅是减少冷启动。更小的权重为 KV 缓存留出更多空间,从而允许更大的批次,进而提高吞吐量,进而降低每个 token 的成本。一次改动就能改善三个指标。
衡量它
如果不进行测量,就无法提高利用率。值得跟踪的指标有:
- 每秒每 GPU 的 token 数,在真实流量下测量,而非基准测试。这是你的实际吞吐量。
- 平均批次大小 或并发请求数。如果在大型 GPU 上此指标持续保持在个位数,则你还有余量。
- GPU 已用显存与可用显存的对比。如果你有 40 GB 空闲,则可以同时处理更多请求。
- 首 token 延迟和每个输出 token 的延迟,这样你就知道为了提高吞吐量而牺牲了多少延迟。
有了这四个指标,你就能判断自己是否在为一个几乎不使用的 GPU 付费。
问题三:每次推理的成本
进行算术运算
每个请求的成本可以用一个简单的公式来表示:
cost per request = (GPU hourly rate / requests served per hour)
分母是所有复杂性所在。每小时处理的请求数取决于利用率、批次大小、平均提示词和输出长度,以及在这一小时中GPU实际处于活跃状态并接收流量的比例。
以下是一个使用整数的示例:
- GPU 费用:每小时 3 美元。
- 平均请求:500 输入 token,300 输出 token。
- 在真实负载下测得的吞吐量:每秒 2,000 输出 token。
- 这相当于每秒约 6.7 个请求,或每小时约 24,000 个请求。
- 每请求成本:约 0.000125 美元,即八分之一美分。
现在是同样的配置,但流量低且批处理不佳:
- 相同的 GPU,每小时费用仍为 3 美元。
- 平均流量为每秒 0.5 个请求,因此批次较小。
- 吞吐量降至大约每秒 200 输出 token,因为 GPU 大部分时间处于等待状态。
- 这相当于每小时约 1,800 个请求。
- 每请求成本:约 0.0017 美元,大约高出 13 倍。
模型相同、硬件相同、部署相同。每请求成本相差十三倍,这完全取决于 GPU 每小时租用时间内完成的工作量。
影响该数值的因素
根据该公式,以下因素会影响每次推理的成本:
- 模型规模。 在相同硬件上,更大的模型每秒产生的 token 更少。选择 70B 模型而非 8B 模型会使每 token 成本提升 5 到 10 倍。关键在于质量提升是否值得为您的任务付出此代价。
- 精度。 8 位或 4 位量化能降低内存带宽并提升吞吐量,对许多任务而言质量损失往往很小。
- 序列长度。 长提示词会增加 prefill 开销并减小批次大小。裁剪系统提示词和检索到的上下文会直接影响成本。
- 流量形态。 平稳流量成本低,因为 GPU 始终保持忙碌;突发流量成本高,因为需要为峰值预留资源,导致低谷时空闲。
- 硬件选择。 最贵的 GPU 不一定是每 token 最便宜的。一张显存较小的卡在高利用率下运行合适规模的模型,往往能胜过利用率仅 20% 的大卡。
- 服务框架。 原始的服务循环与具备连续批处理和分页 KV 缓存的框架之间的吞吐量差异往往达到数倍。
这些并不是通常意义上的部署选择。它们属于模型、数据和容量的决策。但它们决定了账单。
与 API 的对比
当你获得自己部署的实际每 token 成本后,可以将其与托管 API 定价进行比较。这种比较常常令人谦卑。托管提供商在众多客户之间保持非常高的利用率,因此其每 token 价格可能低于利用率低的自托管 GPU。
常见的模式:
- 在低流量情况下,托管 API 更便宜,因为你不需要为闲置 GPU 时间付费。
- 在高且稳定的流量情况下,自托管变得更便宜,因为利用率提升导致每 token 成本降至低于 API 价格。
- 交叉点取决于你的流量和利用率,这就是为什么在做决定前需要前一节的测量数据。
跳过这一步的团队常常自托管过早,付出的成本高于使用 API,进而认为开源模型很昂贵。其实模型本身并不贵,是闲置的 GPU 导致了高成本。
把三者结合起来
这三个问题相互关联,而这种关联正是本文要点。
- 冷启动会促使你保持 GPU 预热,这会降低利用率。
- 低利用率会提升每次推理的成本。
- 高推理成本会促使你转向更小的模型或使用 API,从而改变你最初的部署选择。
按此顺序阅读,部署决策放在最后。你根据能承受的每请求成本来选择模型大小、精度和服务框架。你根据流量形状和冷启动所需时间来决定保持温暖的副本数量。只有在这之后,你才会确定容器的外观以及运行位置。
以下是按应提问顺序排列的问题序列:
- 典型请求是什么样子?输入长度、输出长度以及可接受的延迟。
- 流量形状是什么?峰值时每秒请求数、低峰时每秒请求数以及变化速度。
- 基于该流量和候选模型,单个 GPU 在持续批处理下能达到什么吞吐量?请进行测量,不要猜测。
- 这会使得每请求成本变为多少?产品是否能承受?
- 如果不能,应作何调整?使用更小的模型、量化、缩短提示词、更换硬件或采用 API。
- 根据答案,需要保持温暖的副本有多少?剩余副本的冷启动必须多快?
- 现在,仅此时,我该如何部署它?
第七步是教程所涵盖的步骤。第一步到第六步决定了第七步是否能得到你负担得起的运行结果。
结论
问“我该如何部署一个 AI 模型”之所以常见,是因为它是第一个可见的障碍,也是最容易跨越的障碍。一个容器、一个服务框架和一个 GPU 实例就能让模型在下午内开始响应请求。但那下午不会告诉你每个请求的成本到底是多少,或者为什么会是这样。 在生产环境中运行模型的真正工作,不是让它启动起来,而是让租用的 GPU 保持足够忙碌,以至于租金值得付出。这就需要弄清楚冷启动时间花在了哪里,并决定是为温备副本付费,还是通过技术手段加快启动。这就需要测量利用率,认识到一次只服务一个请求的 GPU 大部分时间是空闲的,即便看起来很忙。还有就是用真实吞吐量的数字,而不是基准测试数字,来计算每个请求的成本,并诚实地与其他方案进行对比。 做这项工作的团队在部署选择上与不做这项工作的团队不同。他们会选用更小或经过量化的模型,因为算算后发现更大的模型不值得。他们会减少温备副本的数量,因为他们把冷启动时间压缩了。他们会使用支持连续批处理的服务框架,因为他们观察到批次大小一直停留在两。他们的部署看起来不同,但这种差异并不是来自更好的部署教程,而是源于首先考虑经济问题。 所以下次当有人问“我该如何部署这个模型”时,不妨把问题换成“一次请求的成本是多少,哪些因素决定了它。”部署方案自然会随之而来。你实际上在设计的,是账单。
参考文献
- Kwon, W., Li, Z., Zhuang, S., Sheng, Y., Zheng, L., Yu, C. H., Gonzalez, J. E., Zhang, H., and Stoica, I. (2023). “高效内存管理用于大型语言模型服务的 PagedAttention。” SOSP 2023.
- Yu, G.-I., Jeong, J. S., Kim, G.-W., Kim, S., and Chun, B.-G. (2022). “Orca:面向 Transformer 生成模型的分布式服务系统。” USENIX OSDI 2022.
- Pope, R., Douglas, S., Chowdhery, A., Devlin, J., Bradbury, J., Levskaya, A., Heek, J., Xiao, K., Agrawal, S., and Dean, J. (2022). “高效扩展 Transformer 推理。”
- Chen, C. (2022). “Transformer 推理算术。”



