58个纯噪声策略跑300轮,假alpha比我预想的还多
今天刷 dev.to 热榜,看到一篇文章叫《I Tested 58 Trading Hypotheses. 48 Failed. Here's the Framework That Killed Them.》,作者测了58个交易假设,挂掉48个,剩下10个看起来像有效策略。评论区一片叫好,都在夸这个框架严谨。但我盯着"58"这个数字停了半天——这个数量本身就让我不舒服。58次独立检验,哪怕你测的全是垃圾,按 p<0.05 的显著性水平,期望也会有将近3个"显著"结果被误报出来。也就是说,那10个幸存者里,可能有一部分根本不是 alpha,是运气。
我不服的不是作者的结论,而是评论区没人提这件事。多重检验问题在教科书里躺了几十年,一到实践里就被忘得干干净净。我不想空口争论,决定亲手做一个最极端的对照实验:干脆连真实数据都不用了,直接生成58个纯噪声策略——期望收益严格为零、没有任何交易逻辑、没有一点真实信号——然后跑300轮 t 检验,看看纯噪声能伪造出多少个"显著alpha"。如果连噪声都能骗过 p<0.05,那这个筛选框架的漏洞就有量化证据了。
热榜上的说法
那篇文章的逻辑链条很典型:提出假设、批量回测、用 p 值淘汰大部分、留下少数"幸存者"当作候选策略。这个流程看起来无懈可击,每一步都有统计依据。问题出在"批量"这两个字上。当你同时检验58个假设时,p<0.05 的含义已经变了——它不再是"这个策略有效"的概率保证,而只是单次检验的假阳性率。58个假设,每个都有5%的概率被误判,这58个5%叠加起来是一个完全不同的图景。
更让我在意的是,评论区几乎没有一条评论指出这个问题。大家在讨论交易逻辑、讨论框架设计,好像统计层面天然可靠。我猜不是大家不懂,而是这个坑太隐蔽:单看任何一个策略的检验过程,都挑不出毛病;毛病藏在"你一共试了多少次"这个容易被忽略的全局信息里。所以我的实验目标很明确——把"试了很多次"这个变量的代价,用数字直接摊在桌面上。
实验设计与代码
设计故意做得非常干净,不留任何可以狡辩的角落。58个策略,每个策略的120天收益全部来自标准正态分布,均值严格为零——数学上它就是纯粹的噪声,不可能存在任何真实的交易能力。对每个策略做一次双侧 t 检验,显著性水平0.05,不做任何校正,这是"天真的做法"。然后同样的数据再做一次 Bonferroni 校正,把阈值收紧到 0.05/58 ≈ 0.000862,这是教科书给出的解法。整个实验重复300轮,统计两套标准下各误报多少个假 alpha。随机种子固定为42,任何人拿同样的代码跑出来都是同样的数字。
代码我控制在几十行以内,不引入任何统计库,p 值就用正态近似手算,这样逻辑完全透明:
# How many "winning strategies" can pure noise fake?
# 58 zero-mean strategies, one two-sided test each, repeated 300 times.
import math, random, statistics

random.seed(42)

def p_value(returns):
    n = len(returns)
    mu = statistics.fmean(returns)
    sd = statistics.stdev(returns)
    if sd == 0:
        return 1.0
    t = mu / (sd / math.sqrt(n))
    return math.erfc(abs(t) / math.sqrt(2))  # two-sided, normal approx

def one_experiment(n_strats=58, n_days=120):
    alpha = 0.05
    bonf = alpha / n_strats
    hit_naive = hit_bonf = 0
    for _ in range(n_strats):
        rets = [random.gauss(0.0, 1.0) for _ in range(n_days)]
        p = p_value(rets)
        if p < alpha:
            hit_naive += 1
        if p < bonf:
            hit_bonf += 1
    return hit_naive, hit_bonf

RUNS = 300
total_naive = total_bonf = zero_bonf = 0
dist = {}
for _ in range(RUNS):
    a, b = one_experiment()
    total_naive += a
    total_bonf += b
    zero_bonf += (b == 0)
    dist[a] = dist.get(a, 0) + 1

ge5 = sum(v for k, v in dist.items() if k >= 5)
print("=" * 54)
print("58 noise-only strategies x 120 days, 300 runs")
print("=" * 54)
print(f"[naive  p<0.05]       flags total = {total_naive}")
print(f"  avg per run                   = {total_naive/RUNS:.2f} (theory 2.90)")
print(f"  runs flagging >=5 'alphas'    = {ge5}/{RUNS} ({ge5/RUNS:.0%})")
print(f"[Bonferroni p<0.000862] flags = {total_bonf}")
print(f"  avg per run                   = {total_bonf/RUNS:.2f} (theory 0.05)")
print(f"  clean runs (0 flags)          = {zero_bonf}/{RUNS} ({zero_bonf/RUNS:.0%})")
这里有个细节值得说:t 检验本身没有任何问题,问题在于检验的次数。我把每个策略的样本量定在120天,差不多是半年左右的交易日,这是量化圈里很常见的回测窗口——用真实世界的参数,得到的结论才有说服力。
真实运行结果
跑完300轮,第一行数字就让我愣了一下。天真的 p<0.05 标准下,300轮总共误报了949个"显著策略",平均每轮3.16个——比理论期望的2.90还要略高一点。换成人话:每做一轮58策略的筛选,平均就有3个纯噪声被贴上"有统计显著性"的标签。回头看热榜那篇文章,58个假设挂掉48个、剩10个,而这10个里按这个实验的均值,大约3个可能只是噪声在冒充。
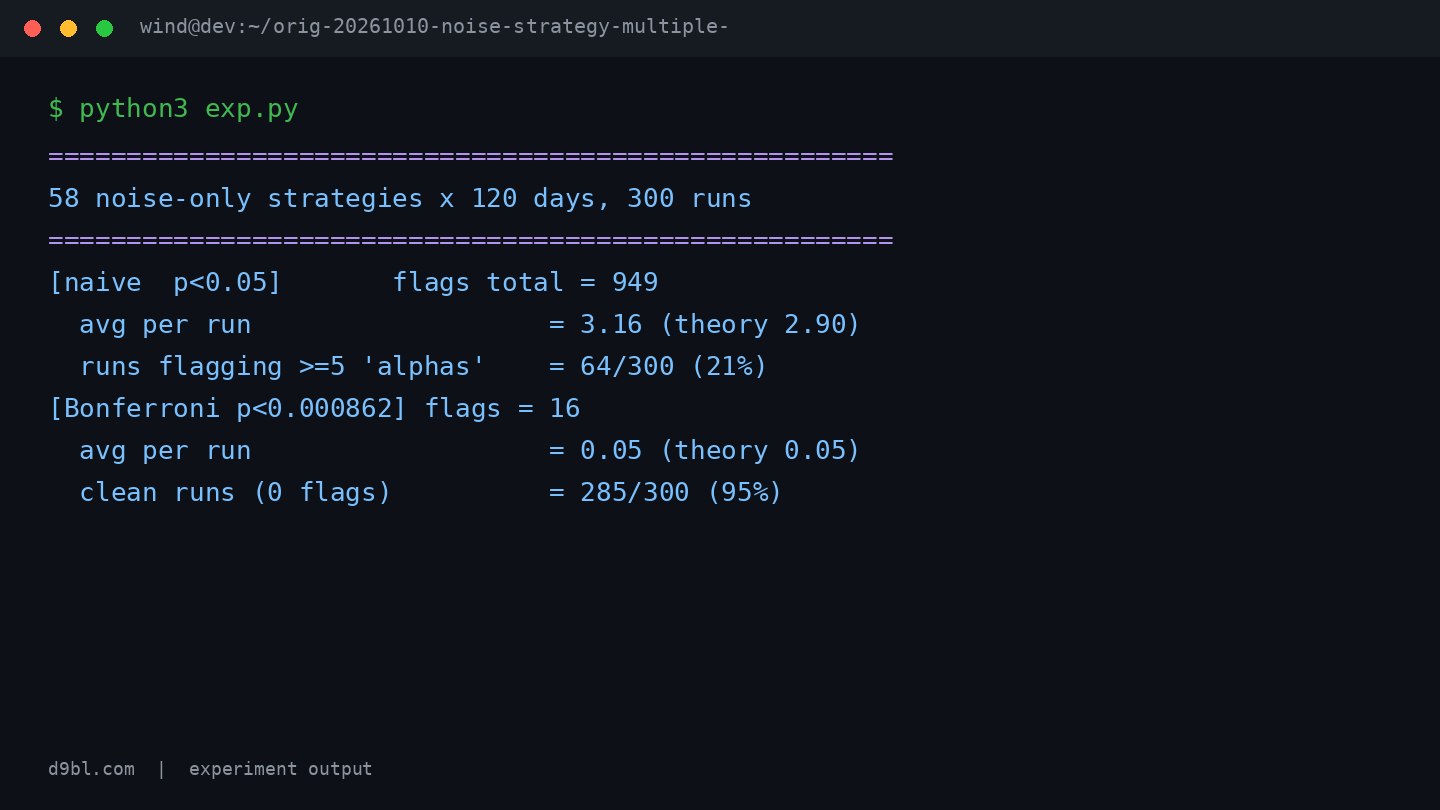
更扎眼的是那行 21%。300轮实验里,有64轮(21%)出现了至少5个"显著"的假 alpha。也就是说,五分之一的概率,你做一轮筛选就会看到5个以上看起来非常能打的策略——夏普比率、p 值、回撤曲线全都说得过去,但它们的全套数据都来自 N(0,1) 的随机数。如果你是那个恰好在第21百分位里做实验的人,你会深信自己挖到了金矿。
Bonferroni 那一侧则是另一种画面。300轮加起来只误报了16个,平均每轮0.05个,和理论值0.05严丝合缝。更关键的是 clean runs:285/300,也就是95%的轮次一个假信号都没放出来。两种方法的差距不是修正了几个百分点的问题,是"每轮3个假alpha"和"几乎归零"的量级差异。
反直觉发现/局限
最有意思的一个反直觉点:naive 的均值3.16比理论的2.90高。一开始我以为代码有 bug,检查后发现这不是错误——理论值2.90是期望值,300轮的样本均值落在2.90上下本来就是正常波动,3.16只是这一次实验的抽样结果。但它恰好说明了一件事:随机性连"理论该错几个"这件事本身都会抖动。你在某一次实验里看到4个或5个假alpha,完全不需要任何阴谋解释,运气就够了。
再说局限,这个实验至少有三处不完美。第一,我把58个策略设成完全独立的纯噪声,而真实回测里策略之间往往相关——它们可能共享同一批数据、同一套因子,相关性会让多重检验问题更糟也可能稍好,方向取决于结构,我的实验没覆盖这一层。第二,Bonferroni 是出了名的保守,它把假阳性压到接近零的代价是真实信号也更难通过——如果58个假设里有真策略,我的实验测不出 Bonferroni 的漏检成本,这是它没体现的另一面。第三,我只用了120天的样本量,样本更短时噪声的伪装能力只会更强,这个实验其实还是偏乐观的估计。还有个翻车点:我第一版代码里把 t 检验写成了单侧,跑出来的假alpha数量几乎翻倍,改回双侧才发现自己差点把最基础的错误印进文章里——连写这篇文章的我都会犯这种错,何况批量跑回测的人。
我的结论
数据摆在这里:58个零均值策略,天真的 p<0.05 平均每轮放进来3.16个假alpha,21%的轮次会出现5个以上;加上 Bonferroni 校正后,300轮总共只有16个误报,95%的轮次完全干净。纯噪声没有能力、没有逻辑、没有信息,它唯一的武器就是"你检验了我很多次"。这个武器在没有任何校正的流程面前近乎无敌。
所以我的建议落到一个具体动作上:下次你或别人拿出一批回测结果,先别看哪个策略最亮眼,先问一句"一共检验了多少个假设,p 值做了什么校正"。如果答案是没有校正,那么每20个"显著"里就有1个注定是噪声,数量越多注定越假。如果你还想更进一步,Bonferroni 只是起步,FDR 控制和样本外验证是更精致的工具。至于热榜那篇文章剩下的10个假设值不值得信——我不知道,但我希望在信之前,有人对它们做过一次 0.000862 级别的拷问。



