创办AI创业公司时,写多少代码之前就要先做选择:推理是跑在serverless API上,还是开GPU云主机,抑或用批处理任务?答案取决于三件事:你需要多大的吞吐量(每秒生成多少token)、能接受什么延迟、成本是多少。这次测试能给你真实数据,帮你做出决定。
我们用Claude Haiku测试了DigitalOcean的serverless推理API。(选择Haiku没有特别原因——换成Sonnet这类相似模型,吞吐量和延迟特性会有所不同,但并发模式和扩展行为应该差不多。)我们测量了不同并发级别下的吞吐量,找到了基础设施的性能峰值,并对比了它与GPU云主机的成本。
先弄清并发与并行的区别:
| 术语 | 含义 | 本次测试中 |
|---|---|---|
| 并发(Concurrency) | 同时管理多个请求(可能交替执行,不一定真正同时运行) | c=64:客户端通过async/await并发管理64个请求 |
| 并行(Parallelism) | 请求在服务器上真正同时执行 | 上限取决于服务器基础设施(核心数、容量等) |
为什么要区分:并发和并行不是一回事。高并发(c=2048)并不意味着高并行——如果你总共只发送100个请求,无论并发设置多高,服务器能同时运行的请求数也不会超过你发送的数量。
测试内容
我们在10个并发级别(1到512)下各发送1,000个请求,然后故意继续加压寻找上限(最高到2,048个并发请求)。我们测量了成功率、首token延迟(TTFT),以及以每秒token数计算的总吞吐量。为了验证结果的一致性,测试在不同日子跑了两次。
具体方法:每个并发级别选取一个请求,从发出时刻计时,直到收到第一个token。总吞吐量按输出token总数除以从首个请求发出到最后一个请求完成的时间窗口来计算。这样测出的是真实性能,而非理论值。
测试结果
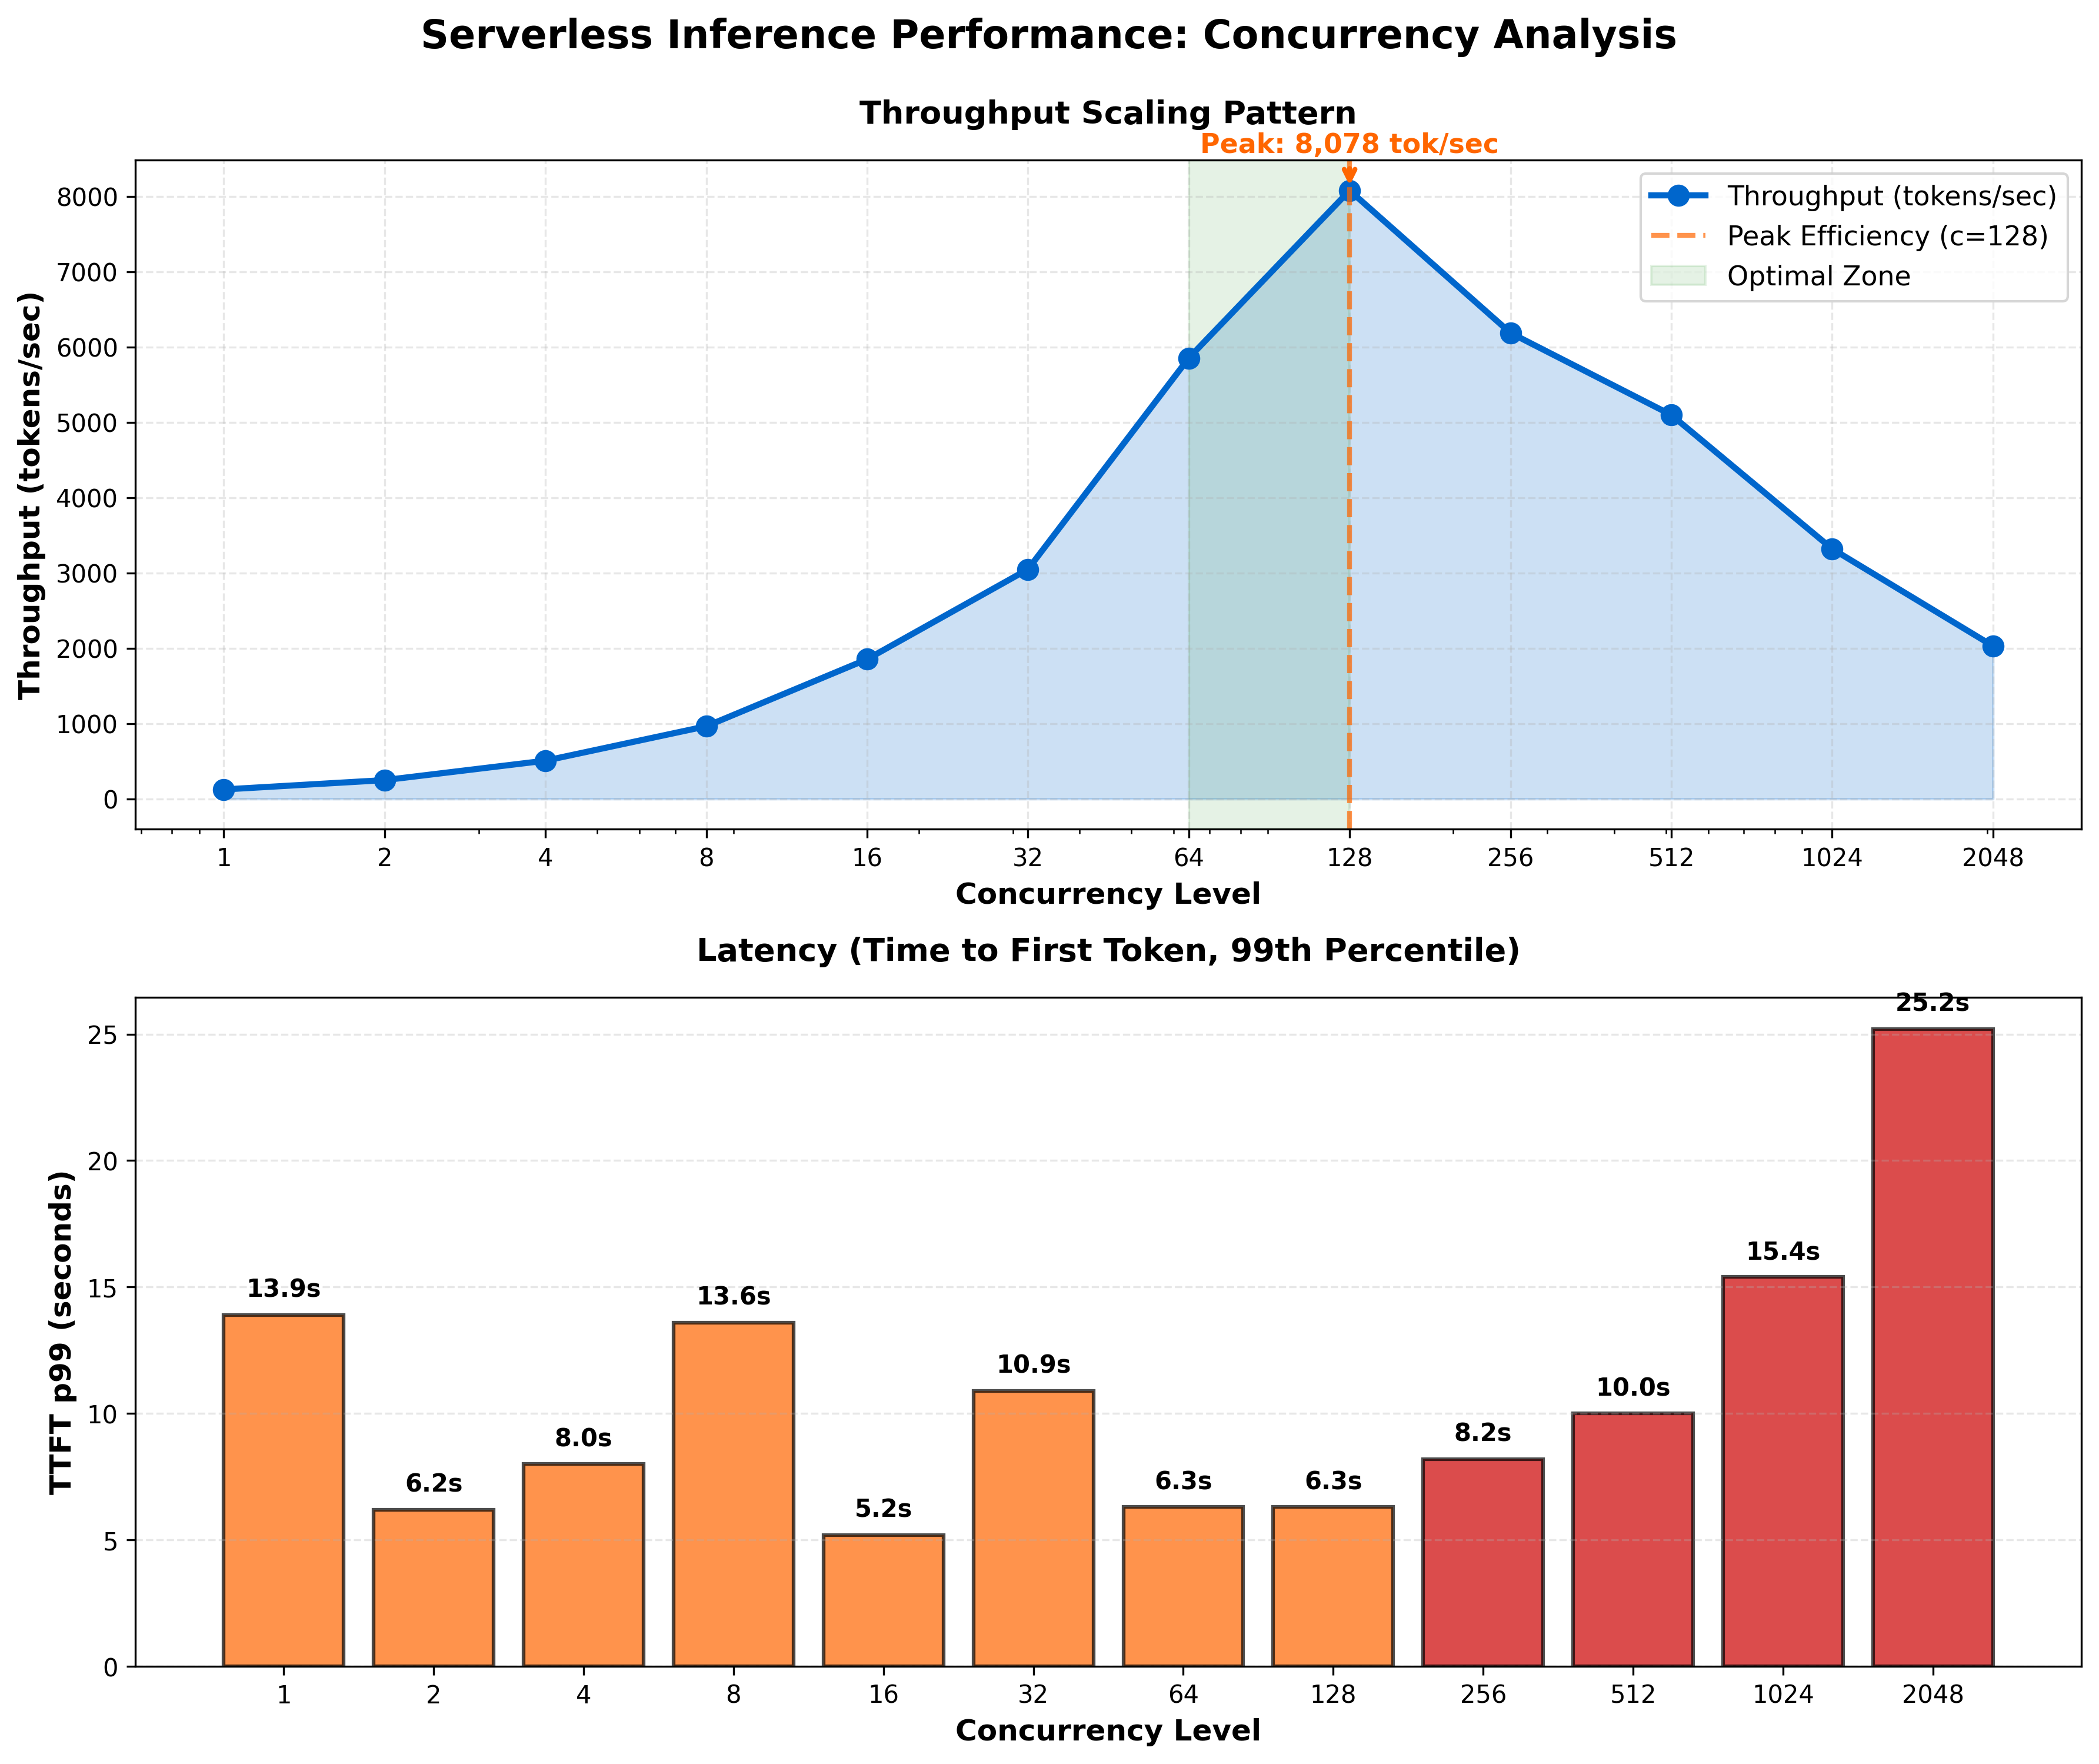
从c=1到c=64,吞吐量随并发数呈次线性增长。在c=64时,API达到每秒5,853个token的吞吐量,成功率为100%。在测试过的所有级别(直到c=2048)中,成功率始终保持在100%,整个测试过程中未出现429限流错误。
这意味着什么:吞吐量呈次线性增长,并发翻倍并不意味着吞吐量也翻倍——收益会逐渐递减。当并发为64时,生成速度达到每秒5,853个token,足以支撑100个用户同时提问(每人约58 token/秒)。所有请求全部成功,没有失败,也没有触发限流。这套基础设施在高负载下表现稳定可靠。
以下是整个测试范围内的性能表现:
| 并发数 | 吞吐量(token/秒) | TTFT p99 | 成功率 | 备注 |
|---|---|---|---|---|
| 1 | 125 | 13.9s | 100% | 有效测试 |
| 2 | 249 | 6.2s | 100% | 有效测试 |
| 4 | 507 | 8.0s | 100% | 有效测试 |
| 8 | 964 | 13.6s | 100% | 有效测试 |
| 16 | 1,854 | 5.2s | 100% | 有效测试 |
| 32 | 3,048 | 10.9s | 100% | 有效测试 |
| 64 | 5,853 | 6.3s | 100% | 有效测试 |
| 128 | 8,078 | 6.3s | 100% | 实际并发上限约100 |
| 256 | 6,187 | 8.2s | 100% | 实际并发上限约100 |
| 512 | 5,098 | 10.0s | 100% | 实际并发上限约100 |
| 1024 | 3,320 | 15.4s | 100% | 实际并发上限约100 |
| 2048 | 2,030 | 25.2s | 100% | 实际并发上限约100 |
从并发1到并发64,吞吐量都在稳定增长。由于每个并发级别只发送100个请求,超过c=100的并发数无法得到有效测试——例如c=128时只有100个请求,同时在途的请求最多只有100个,达不到128。因此c≥128的结果反映的其实是约100并发时的行为,而非更高的真实并发。如果生产系统需要c≥128,那么在每级使用更多请求(例如c=256时发256个以上,c=512时发512个以上)做补充测试之前,本次测试无法给出可靠参考。
这为什么关系到成本
DigitalOcean的Serverless推理按token计费,而不是按小时。以Claude Haiku 4.5为例,根据DigitalOcean官方2026年10月的定价,输入token为每100万$1.00,输出token为每100万$5.00。并发数不会改变token单价,改变的只是你生成这些token的速度。
c=1 时,每秒 125 token;c=128 时,每秒 8,078 token。而每 token 的成本完全相同:每百万输出 token 收费 $5.00。无论处理得快还是慢,你付的都是一样的钱。变化的只是同样的基础设施投入下,一个月内能完成多少工作。
每月 10 亿输出 token
- 输出成本:1B × $5.00/1M = $5,000
- 输入成本:约 1.95B 输入 token(每次请求 1,000 个)× $1.00/1M = $1,950
- 总计:每月 $6,950
Serverless 什么时候适用,什么时候不适用
如果你的应用能接受 4 到 15 秒的首 token 等待时间,Serverless 推理就能满足需求。本次测试显示,p99 TTFT 随并发水平不同,在 5.2 到 25.2 秒之间。如果你做的是聊天机器人,用户本来就要等上几秒,这完全可以接受。想获得最佳吞吐量,建议使用 c=64 到 c=128。
如果你需要亚秒级延迟,Serverless 就不是正确选择。对毫秒敏感的实时系统需要换一种思路,比如在 GPU Droplet 上自托管推理。本次测试没有测量 GPU 硬件上的延迟,所以无法量化能提升多少。
Serverless 能随流量弹性伸缩。单个端点既能跑出每秒 125 token(c=1),也能达到每秒 8,078 token(c=128)。你不必提前猜测容量,按 token 付费,流量低谷期的花销自然比高峰期少。
最佳平衡点
生产环境的最佳并发是 c=64。本测试显示,这一档能达到每秒 5,853 token,成功率 100%,延迟 6.3 秒。这也是本测试能可靠验证的最高并发(每档 100 个请求)。
对大多数生产应用来说,c=32 更实用。它能达到每秒 3,048 token,是单线程基线的 24 倍(3,048 / 125 = 24x),足以支撑几十个并发用户。如果在 c=32 到 c=64 处理单个用户请求,每个用户请求的 TTFT 在 5 到 11 秒之间(p99)。
注意:本测试中 c≥128 的结果反映的是约 100 个并发请求的行为,并非更高的并发水平。如果你的应用需要 c≥128,就得在更高并发下用更多请求做额外测试,才能弄清 c=100 以上的扩展特性。sustained_load_test_v5.py 提供了一个改进版测试,采用持续负载(每档维持 5 分钟固定的在途请求池),可以更准确地测量更高并发。
真实场景
一个要同时服务 100 个用户的聊天机器人,需要同时挂着 100 个在途请求。在 c=64 时,吞吐量为每秒 5,853 个 token,也就是说大约每 9 秒能跑完一批 100 个请求(每分钟约 11 批)。
每批 100 个并发用户的成本:
| 指标 | 计算方式 | 数值 |
|---|---|---|
| 每批请求数 | - | 100 |
| 每请求输出 token 数 | - | 512 |
| 输出 token 总数 | 100 × 512 | 51,200 |
| 每百万 token 单价 | - | $5.00 |
| 每批成本 | 51,200 × $5.00 / 1M | $0.26 |
一个每天要处理 10 亿输出 token 的批量任务,在无服务器方案下每天要花 $5,000。如果能改用开源权重模型,GPU 的经济账会大不一样,但代价是成本和模型能力两头都要取舍。
GPU 真正合理的场景:需要低于 100 毫秒延迟的实时推荐引擎,或者毫秒必争的高频交易系统。再或者你在做微调或训练,而不只是推理——无服务器推理并不适合这类任务。
可靠性与极限
所有并发级别下的所有请求都成功完成:没有超时,没有 429 限流错误,也没有任何性能退化。即使在 c=2048(吞吐量已降到每秒 2,030 个 token)时,API 依然返回有效响应。
实际的瓶颈在于效率,而非可用性。超过 c=128 之后吞吐量就开始下滑。到 c=2048 时请求仍然成功,但每秒 token 数只有峰值的四分之一。单价不变,可每一美元换来的吞吐量却在变少。
成本对比
说点具体的。假设一家创业公司的每日输出 token 量从 1,000 万增长到 10 亿:
无服务器方案下,每日 1,000 万输出 token(假设每请求 1,000 输入 token):
- 输出成本:每天 $50(1,000 万 × $5.00/1M)
- 输入成本:约 $19/天(1,950 万输入 token × $1.00/1M)
- 合计:约 $69/天,约 $2,070/月
- 基础设施成本:零
无服务器方案下,每日 10 亿输出 token(假设每请求 1,000 输入 token):
- 输出成本:每天 $5,000(10 亿 × $5.00/1M)
- 输入成本:约 $1,950/天(19.5 亿输入 token × $1.00/1M)
- 合计:约 $6,950/天,约 $208,500/月
- 基础设施成本:仍为零
注意:Claude Haiku 是闭源模型,无法在 GPU Droplet 上运行。DigitalOcean 的专用推理服务定价为 H100 每小时 $4.41。如果你可以换用其他模型,专用推理就成为一个可选项,但那就属于另一种产品对比了。
什么时候该考虑其他方案
如果你的应用能容忍 4-25 秒的延迟(本次测试的 p99 区间),Serverless 推理就能满足需求。要是你的要求不同,那就得评估其他选项。
如果你需要亚秒级延迟,Serverless 不合适。我们实测的 TTFT 在 5.2 到 25.2 秒之间,取决于并发量。我们没有测量 GPU 延迟,所以无法做对比。
如果你需要的吞吐量超过 c=64 所能提供的 5,853 token/秒,有两条路:部署多个 Serverless 端点,或者评估专用推理。DigitalOcean 提供的专用推理服务,H100 GPU 定价为每小时 $4.41。成本和吞吐量取决于你运行的模型,以及针对该硬件优化的能力。注意:本次测试没有充分验证 c=100 以上的并发场景。
如果你要做微调或训练,Serverless 推理帮不上忙——你需要 GPU 和相应的框架。
如果你在构建聊天机器人、内容生成引擎或推荐系统,且能容忍 10 秒以内的延迟,Serverless 在 c=32-64 的负载下都能扛住。无论并发量多少,单 token 成本都保持不变。
怎么用
如果你在 DigitalOcean 上运行 Serverless 推理,设计应用时要围绕并发来做。并行发送请求,而不是串行。根据延迟容忍度,把并发水平控制在 32 到 128 之间。c=64 是个不错的平衡点:每秒 5,853 个 token,延迟 6.3 秒,可靠性 100%。
并发不要超过 c=64-128。再往上,吞吐量不升反降,成本却不变。开启连接池,避免每个请求都要付出建立连接的开销。
监控你实际得到的吞吐量和延迟。这些数字来自我们的测试,并非承诺值。提示词复杂度、模型大小、网络状况都会影响结果。建议用贴近真实业务的负载自己跑一遍测试,核对结果是否与我们的发现一致。
写在最后
DigitalOcean 的 Serverless 推理在 c=64 下表现稳定可预期:每秒 5,853 个 token,成功率 100%,延迟 6.3 秒。价格为每 100 万输出 token $5.00,且与并发量无关。
如果你要用 Claude Haiku,且能接受 4-15 秒的延迟,那么在并发量不超过 c=64 的情况下,无服务器方案是最省事的选择。如果你需要亚秒级延迟,或者想用其他模型,就得换一种思路。如果需要比 c=64 更高的吞吐量,或者要做的是训练而非推理,GPU Droplet 值得一试。并发超过 c=100 时,你需要在每个并发级别发送足够多的请求,自行实测。
本次测试给出了 c=1 到 c=64 的真实数据:吞吐量从 125 提升到 5,853 tok/秒,成功率 100%,成本为每 100 万输出 token 5 美元。c≥128 的结果实际并发只有约 100,不能据此推断更高并发下的表现。做 c≤64 的基础设施决策时,请参考这些经过验证的数据。
测试方法:关键代码模式
测试框架通过 asyncio.Semaphore 控制并发,确保任意时刻在途请求恰好为 N 个。这一点与简单创建 N 个任务不同(那种做法会把请求在内部排队)。每个请求记录发送时间的时机是获取到信号量的那一刻,而非任务创建之时。
并发受控的请求模式
semaphore = asyncio.Semaphore(concurrency)

async def run_with_limit(session, prompt, request_id):
    async with semaphore:
        # Request now actually starts (after semaphore acquired)
        t_send = time.time()

        response = await session.post(endpoint, json=data)
        t_first_token = time.time()  # Record when first token arrives

        return {
            "ttft": t_first_token - t_send,  # Per-request latency
            "output_tokens": response.get("usage", {}).get("completion_tokens", 0)
        }
这种模式能确保 TTFT 反映真实的请求延迟,而不包含排队等待时间。设 c=64 时,会同时发出 64 个请求,接下来的 64 个则排队,直到有空闲连接才执行。
基线验证(确保测量准确)
# Run 5 sequential requests to validate baseline latency
semaphore = asyncio.Semaphore(1)  # Force sequential

for i in range(5):
    async with semaphore:
        result = await single_request(session, prompt, i)
        ttft_values.append(result["ttft"])

average_ttft = sum(ttft_values) / len(ttft_values)
# Should be ~4.6 seconds (the true per-request latency)
# If much higher, the timing measurement is wrong
基线测试用来验证测量方法是否正确。如果基线测出的是 4.6 秒,那么更高并发下的测量结果才可信;如果测出 179 秒,说明测试框架量到的是排队时间,而不是单请求延迟。
总吞吐量计算
# Time window: from first request sent to last request completed
earliest_send = min([r["t_send"] for r in results])
latest_completion = max([r["t_send"] + r["total_time"] for r in results])
total_window = latest_completion - earliest_send

# Throughput: total tokens / time window
total_output_tokens = sum([r["output_tokens"] for r in results])
throughput = total_output_tokens / total_window
这项指标衡量的是实际吞吐量,而非理论最大值。以c=64为例:如果100个请求共输出51,200个token,总耗时9秒,那么吞吐量就是51,200 / 9 = 5,688 token/秒。
- 测试日期:2026年10月13日至14日
- 模型:anthropic-claude-5.5-haiku
- 测试类型:并发扩展测试(c=1-2048,每档100个请求,共两轮)
- 请求总数:两个测试阶段合计约1,200个
- 测试方法:通过asyncio.Semaphore控制并发,逐请求计时;总吞吐量的计算方式为:输出token总数除以从发出首个请求到最后一个请求完成的时间窗口
- 有效测试范围:c=1至c=64(实际并发与信号量设定值一致)
- 外推结果:c≥128(实际并发上限约100——因为100个请求无论信号量设多大,同时在途的都不可能超过100个)
- 关键发现:吞吐量从c=1到c=64呈亚线性增长(峰值5,853 token/秒),全程未出现429错误,各并发档位成功率均为100%
- 成本数据:DigitalOcean 2026年10月官方定价(输入$1.00/百万token,输出$5.00/百万token)
- 局限性:仅测试了Claude Haiku这一款模型,且只跑了两轮。c≥128时实际只有约100个并发请求,并非更高并发。要真正测准c≥128,后续测试需要增加每档请求数(如c=256时至少256个,c=512时至少512个)。此外未做持续负载和冷启动测试。
- gitrepo:serverless-inference-performance



