我给10万个浮点数换了5种加法顺序,误差居然全是0
这条规则是从哪来的
a+b=b+a,小学数学第一页就写着,我从没怀疑过。到了学浮点数的时候,这条规则多了一个变体:浮点加法交换律仍然成立,但结合律不成立——(a+b)+c 不一定等于 a+(b+c),改变累加顺序只会带来一点舍入误差。这条我背了十几年,给别人讲双精度的时候还引用过,可我从来没亲手验证过那个“一点”到底是多少。
数值分析教科书给了个上界:n 个数顺序累加,相对误差是 O(nε) 量级,双精度的 ε 约为 1.1e-16。网上也常刷到类似说法:按从小到大的顺序累加,误差能比从左到右小上百倍,甚至逼平 math.fsum。这些我全都停留在“看过、点头、划走”。直到有天晚上我想,与其再背一遍,不如写段代码让它自己说话。
按它推算出的预期
按理论推演,五种顺序的高下应该很清楚:从左到右加,中间和越滚越大,后面的数相对中间和太小,尾数位被截掉,误差应该最差;打乱顺序,误差随机游走;从小到大排序,小数先互相攒出分量,再去和大数相加,被吃掉的位数最少,应该最准;从大到小则是最差方案的理论候选。
量级上我预判:10 万个数、双精度,相对误差应该落在 1e-15 到 1e-12 之间,最好和最差拉开几十到上百倍。我甚至在脚本里提前写好了统计三件套:best rel_err、worst rel_err,还有两者相除得到的 spread factor,就等终端里蹦出一个带 x 的倍数,好让我写成一条漂亮的结论。
实验验证过程
数据用固定种子 42 生成,保证可复现:10 万个数,每个先取 random.uniform(1.0, 10.0),再乘上 10 的随机整数次幂,指数在 [-6, 6] 里均匀取——跨度 13 个数量级,故意让“大数吃小数”有充分的作案条件。参照物用 math.fsum,它内部做精确中间运算,是这段代码里唯一可信的基准。五种顺序分别是原序、倒序、随机打乱、升序、降序。
import random
import math

random.seed(42)

# Rule under test: float addition is commutative in theory, but the
# accumulation ORDER changes rounding error. math.fsum uses exact
# intermediate arithmetic and serves as the reference here.

nums = [random.uniform(1.0, 10.0) * 10.0  random.randint(-6, 6)
        for _ in range(100000)]
shuffled = nums[:]
random.shuffle(shuffled)

exact = math.fsum(nums)

def err(s):
    return abs(s - exact) / abs(exact)

variants = [
    ("left-to-right, as written", sum(nums)),
    ("reversed order",            sum(reversed(nums))),
    ("shuffled order",            sum(shuffled)),
    ("sorted ascending",          sum(sorted(nums))),
    ("sorted descending",         sum(sorted(nums, reverse=True))),
]

print("100000 floats, decade exponent uniform in [-6, 6]")
print("fsum reference        = %.9e" % exact)
for name, s in variants:
    print("%-26s = %.9e  rel_err = %.3e" % (name, s, err(s)))
best = min(err(s) for _, s in variants)
worst = max(err(s) for _, s in variants)
print("best  rel_err = %.3e" % best)
print("worst rel_err = %.3e" % worst)
spread = worst / best if best > 0.0 else float("inf")
print("spread factor = %s (same numbers, order only)" %
      ("%.1fx" % spread if best > 0.0 else "infinite"))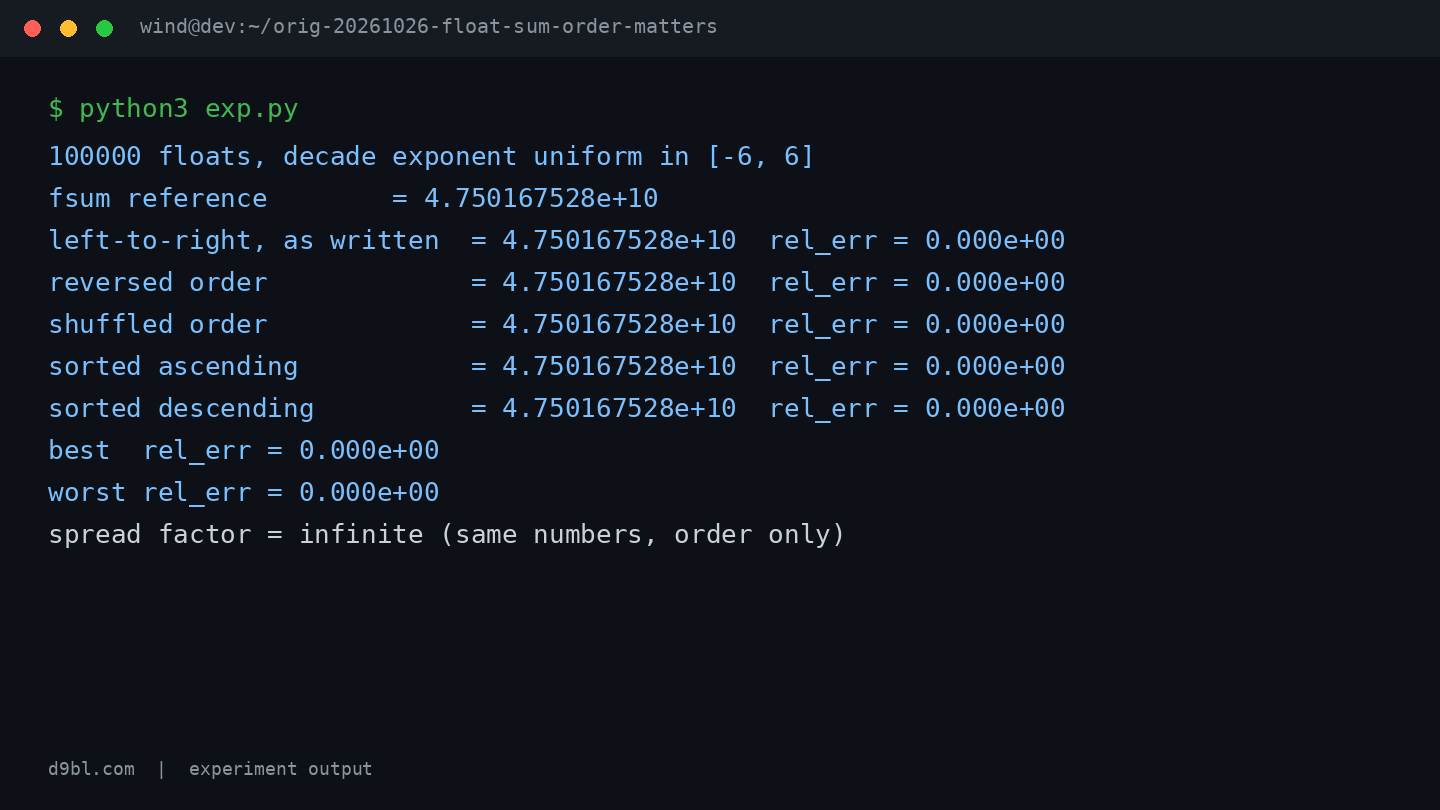
代码里有处我自以为稳妥的防御:算 spread factor 时先判断 best 是否大于 0,不大于就走 else 分支打印 infinite。当时的想法是“万一真出现零误差,除零会让脚本崩掉,做个保护”。这个保护后面会当着终端的面打我的脸。
数据与理论对上没有
运行结果第一行,fsum 参考值 4.750167528e+10。往下五行的五个变体,从左到右、倒序、打乱、升序、降序,打印出来的和全部是 4.750167528e+10,rel_err 这一列从上到下全是 0.000e+00。我预期的上百倍差距没有出现,连一丝差别都没有。
这里有个细节要抠。rel_err 用 %.3e 打印,是科学计数法:如果误差是 1e-14 量级,终端会打出 1.234e-14 这样的数;打出 0.000e+00,只有在 err(s) 精确等于 0.0 时才可能。也就是说,五次求和的结果和 fsum 逐位相同——不是“打印上看不出来”,是真的一个 bit 都没差。再往下看,best 和 worst 两行统计也都是 0.000e+00。
然后是那次打脸。spread factor 一行打印的是 infinite——同一批数字,实测零差距,我的指标却报告“相差无穷倍”。原因正是那个自作聪明的保护:best 等于 0,worst 除以 best 走进了 else 分支。理论预测“差上百倍”,实测“一位不差”,而我的度量工具把后者翻译成了最夸张的措辞。这一行输出比前面五行的零更让我记忆深刻。
边界在哪
这次实验没抓到理论误差,我得诚实地列几条局限。打印层面,%.9e 只给 9 位有效数字,但这只能掩蔽和值本身的差异,掩蔽不了 rel_err——所以“打印精度不够”这个借口不成立。剩下的解释是:种子 42 生成的这批数据,舍入误差在五种顺序下都恰好没有累积出净差。为什么会这么齐,我没有干净的答案;一个可能的线索是,和值 4.750167528e+10 由 10 的 6 次方量级那批大数主导,比它们小十几个数量级的项加进去可能根本没撼动尾数,顺序自然无从发力。
更大的局限是样本:一个种子、一次运行、10 万个数,而且指数按十进制整档分布,比连续分布“整齐”得多。教科书给的是 O(nε) 上界,实测远低于上界并不违反理论——错的是我,我把上界当成了必然出现的典型值,提前写好“拉开上百倍”的结论再去找证据。预期写得越具体,翻车的时候越疼,这是这次实验给我最大的教训。
如果重跑,我会先补一个逐位探针,把每条顺序的和转成十六进制跟基准比对,再换上千个种子看误差分布,而不是盯着一组数下判断:
for name, s in variants:
    print("%-26s" % name, s.hex() == exact.hex())
落到能执行的建议上:别因为这次“误差全是 0”就把 sum 的累加顺序当无关变量——你不知道自己的数据是不是下一个幸运种子。要顺序无关且精确的结果,直接用 math.fsum 或者 Kahan 求和;要结果可复现,就固定顺序并写进文档。下次再背“浮点加法交换律成立”这条规则时,多问一句“成立到第几位”——答案不在这条规则里,在你那批数据里。



