如果你在构建语音代理或聊天机器人,用户评判它不仅仅看答案有多聪明,而是看他们在它开始回复之前需要等待多久。这种等待被称为首 token 延迟(time-to-first-token,简称 TTFT),即从发送请求到看到第一个词返回之间的间隔。
大多数在选择交互式应用模型的人其实从未实际测量过这一点。他们可能只是看看规格表,或者随便试一次就凭感觉决定。实际上,没有哪里能给出一个简单、公开的答案,说明某个模型在不同提示长度和真实使用条件下的响应速度。
因此,本次测试直接测量了这一指标:在 DigitalOcean 的 Serverless Inference 平台上测试了六种模型,每种模型使用三种不同长度的提示,共进行 380 次单独调用,并对其中一种模型施加较大负载,以观察其最慢响应的实际表现。以下是测试得到的具体数字。
Key takeaways
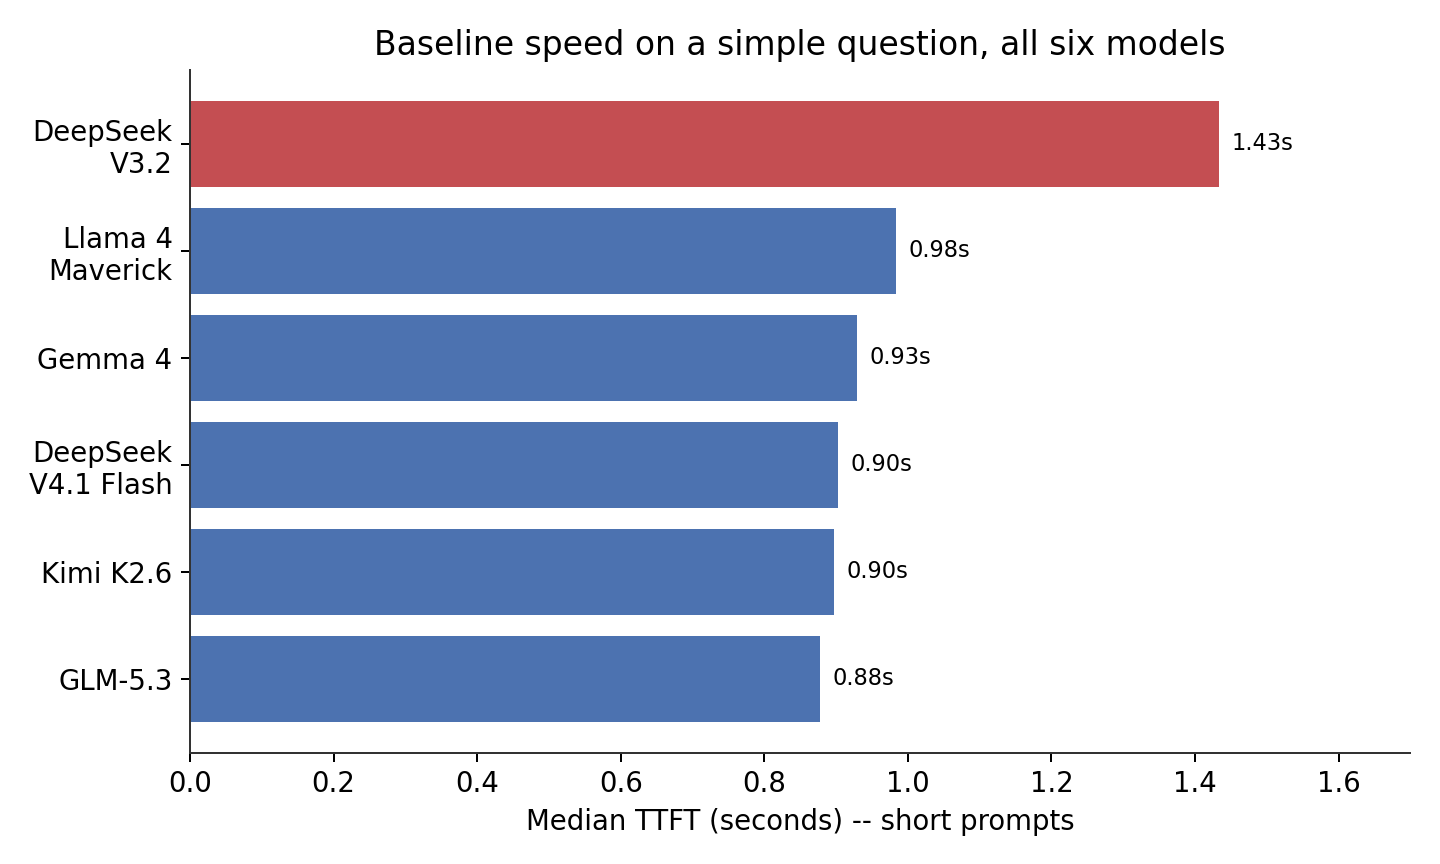
- 在短提示情况下,目录中的大多数模型响应速度快且一致。六款模型中有五款的中位数 TTFT 在 0.88 到 0.98 秒之间:GLM-5.3(0.88 秒)、Kimi K2.6(0.90 秒)、DeepSeek V4.1 Flash(0.90 秒)、Gemma 4(0.93 秒)以及 Llama 4 Maverick(0.98 秒)。
- DeepSeek V3.2 在所有提示长度下都是测试中最慢的模型,即使是最简单的问题其中位数 TTFT 也达到 1.43 秒,远高于其他模型。
- 当提示长度达到完整的 10,000 个 token 时,DeepSeek V3.2 的中位数 TTFT 为 1.9 秒,90 分位数为 4.1 秒。部分调用的耗时远高于典型情况。
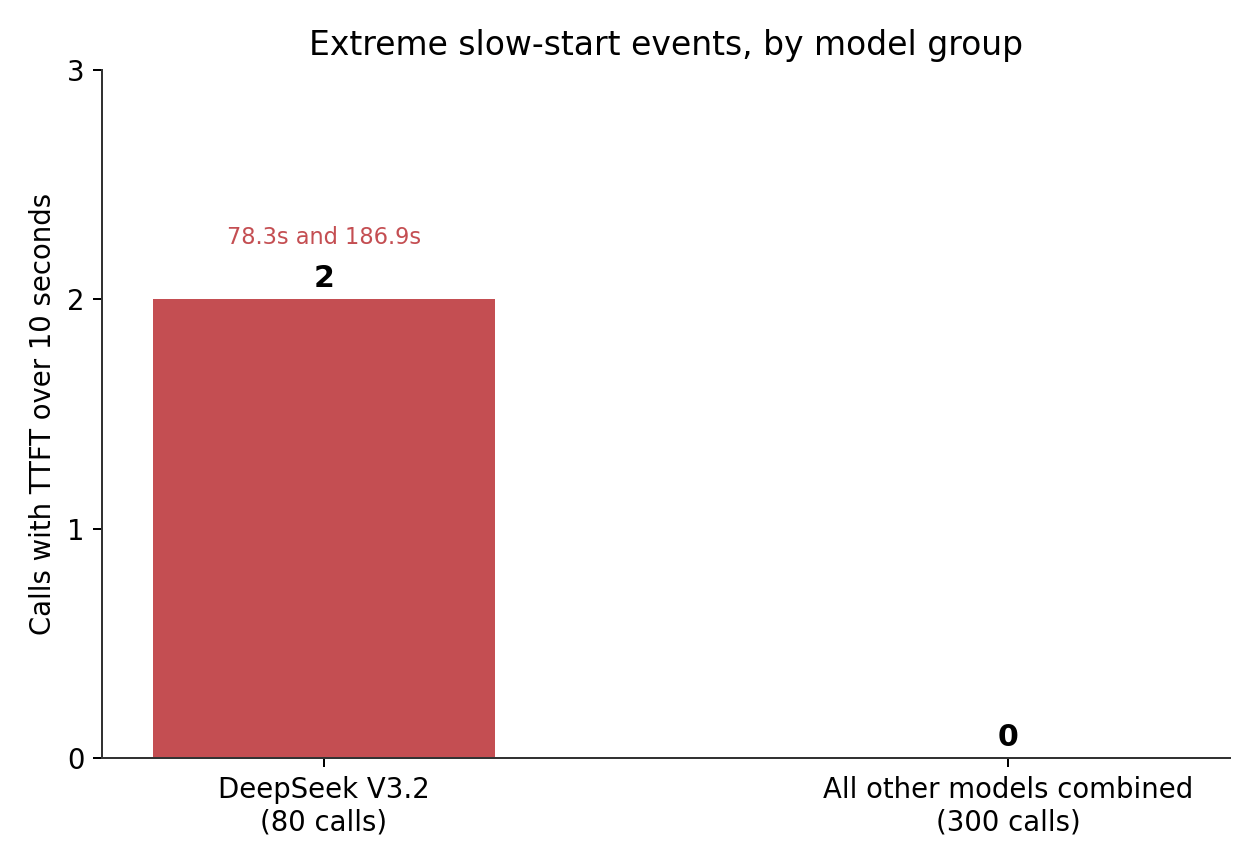
- 在对 DeepSeek V3.2 的 80 次调用中,有两次产生第一个 token 的时间远超预期,分别为 78.3 秒和 186.9 秒。而在其余五款模型的合计 300 次调用中,没有任何一次接近这样的时长。
- 作为被选中的小型快速基准模型,Gemma 4 在从短提示过渡到长提示时出现了所有模型中最大的放慢,其中位数 TTFT 从 0.93 秒升至 3.35 秒。仅凭模型大小无法预测它在提示变长时的表现。
TTFT 是什么以及为什么它是重要的指标
首 token 延迟并不等于总响应时间。一个模型如果需要两秒才开始返回,但随后能够快速流式输出长答案,在这次测试中不应被视为慢;相反,一个模型在启动后回答很快,却让用户在第一个词出现前等待五秒,则会被感知为慢,因为这正是用户实际感受到的等待。
对于任何交互式产品——无论是聊天机器人、语音界面,还是创始人希望让其感觉灵敏的代理——TTFT 是决定产品是否显得活跃还是停滞的关键指标。
What was tested
六个模型,选取是为了覆盖范围而非方便:Gemma 4(小型,旨在快速),GLM-5.3(推理始终开启,无法关闭),Kimi K2.6(该套装中最大的模型,万亿参数),DeepSeek V3.2,DeepSeek V4.1 Flash(与之前文章中提到的同一模型,用于提示缓存,为保持连续性而保留),以及 Llama 4 Maverick。
每个模型都收到了三种规模的提示:短(单个问题,20‑50 个 token),中等(约 500 个 token,一段摘录加上摘要请求),以及长(5,000‑10,000 个 token,较长的摘录加上一个问题)。每种模型和规模各重复二十次。此外,还专门对 DeepSeek V3.2 进行了二十次额外调用,提示被精确裁剪为 10,000 输入 token,使用模型自身的分词器进行校验而非估算——这是因为这是整套测试中最苛刻的条件,值得单独深入考察。总计 380 次调用。
这些测试在 DigitalOcean 的 Tier 1 定价层级上运行,也就是任何新账户默认起步的层级。
在发送之前,每个提示的开头都会添加一个随机且唯一的标记。这一点比表面看起来更重要。DigitalOcean 的提示缓存基于精确前缀匹配,缓存命中会返回一个可疑的快速响应,这与模型的实际服务速度无关。如果不强制每次调用都是全新文本,重复的短问题最终会开始命中缓存,悄悄让 TTFT(首词延迟)看起来比实际更好。数据集中的全部 380 次调用均为保证的冷启动、未缓存请求。
A bug in the measurement script
此测试的首次完整运行返回了 390 行数据中有 127 行完全缺失 TTFT 读取,没有报错,只是未记录任何内容。原因在于:某些模型会返回两类文本——它们的内部推理过程和实际答案。Kimi K2.6 和 DeepSeek V4.1 Flash 总是先输出推理内容。GLM-5.3 在较长的提示下也会如此。脚本仅监控答案文本,完全忽略了推理文本。
本次测试中,每次调用的输出也被限制为 50 个词,因为答案的长短不会影响首词出现的速度。正是这一限制导致了问题。有些模型将全部 50 词的配额用于推理,根本没有输出实际答案。由于脚本只关注答案文本,它根本没有看到任何可记录的内容。
修复脚本以在两个字段中 whichever 先出现的第一个 token 进行计数,并重新运行受影响的 140 次调用后,所有行都返回干净。值得单独指出:如果你在推理模型上测量 TTFT,仅关注其答案流,可能会得到完全没有读数,或者得到实际上是“推理结束后首个 token 的时间”的读数——这与实际有用的指标不同,且价值较低。
测量背后的代码
三段代码使得此次测试可信。直接展示它们很有必要,因为只有当实现真正符合其宣称时,方法论才重要。
获得真实的冷启动 TTFT 读数的第一步是确保每个提示对模型来说都是全新的,而不是可能被 DigitalOcean 提示缓存命中并快速返回的重复内容。为每个提示开头添加一个随机标记可以解决这个问题:
import uuid

session_marker = str(uuid.uuid4())
full_prompt = f"[session:{session_marker}]\n{prompt_text}"
正确计时第一个 token 是得到诚实数字的另一半。下面的代码在请求发出前立即启动计时器,然后按块流式传输响应,记录真实内容首次出现的确切时刻。此后的所有内容对 TTFT 都不重要,重要的是在任何内容出现之前的等待时长:
import time

start_time = time.perf_counter()
first_token_time = None

stream = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": full_prompt}],
    stream=True,
    max_tokens=50,
)

for chunk in stream:
    if chunk.choices:
        delta = chunk.choices[0].delta
        content_piece = getattr(delta, "content", None) or getattr(delta, "reasoning_content", None)
        if content_piece and first_token_time is None:
            first_token_time = time.perf_counter()

ttft = first_token_time - start_time
那行 getattr(delta, "content", None) or getattr(delta, "reasoning_content", None) 是对上述 bug 的修复。仅检查 content 会漏掉那些先在单独字段中流式输出推理内容的所有模型。同时检查两者,并取先出现的那个,才真正符合首 token 时间的实际定义。
最后这段代码解决了一个更具体的问题:让 DeepSeek V3.2 的提示词恰好落在 10,000 个输入 token 上,而不是近似长度。它的做法是逐句裁剪源文本,每裁剪一次后检查模型自身的分词器,逐步逼近,直到 token 数尽可能接近 10,000:
low, high = 1, len(sentences)
best_text, best_count, best_diff = None, None, float("inf")

while low <= high:
    mid = (low + high) // 2
    candidate_text = " ".join(sentences[:mid]) + question_suffix
    tok_count = count_tokens(candidate_text, "deepseek-3.2")
    diff = abs(tok_count - 10000)

    if diff < best_diff:
        best_text, best_count, best_diff = candidate_text, tok_count, diff

    if tok_count < 10000:
        low = mid + 1
    elif tok_count > 10000:
        high = mid - 1
    else:
        break
这是一个标准的二分查找,只是将其应用于句子数量而不是有序列表。它在几步内就能收敛到正确的截止点,而不是手动修剪文本并逐个重新检查猜测。
数据说了什么
在短提示上,六个模型中的五个表现接近:GLM-5.3 中位数 0.88 秒,Kimi K2.6 0.90 秒,DeepSeek V4.1 Flash 0.90 秒,Gemma 4 0.93 秒,Llama 4 Maverick 0.98 秒。对于简单问题,这些模型中的大多数每次都能在一秒内回答。
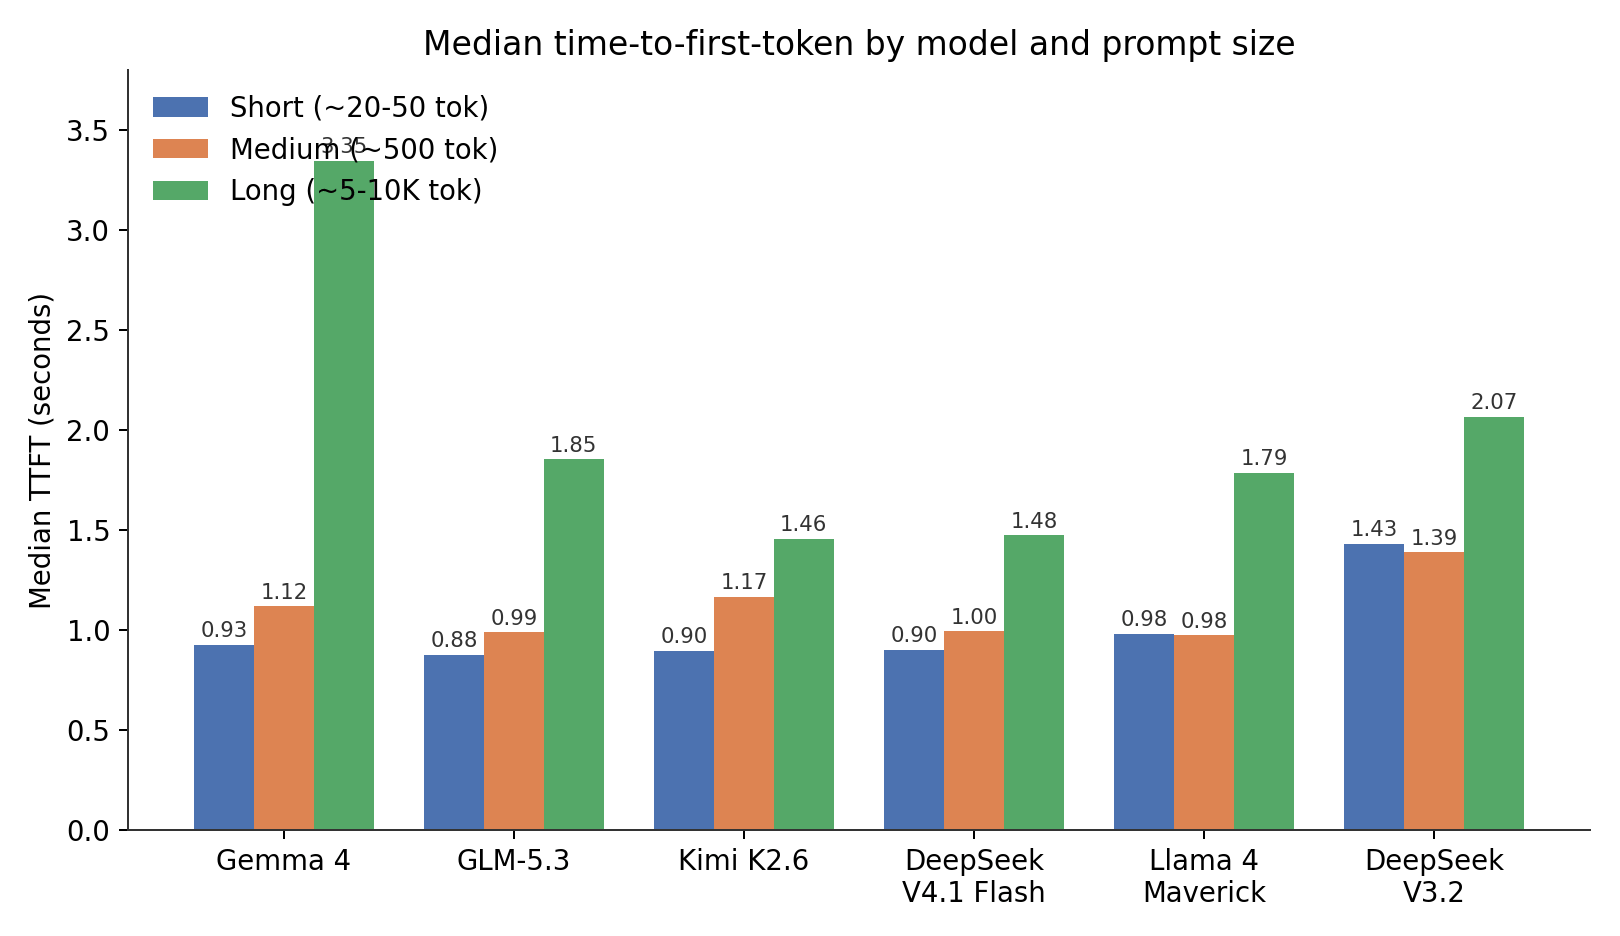
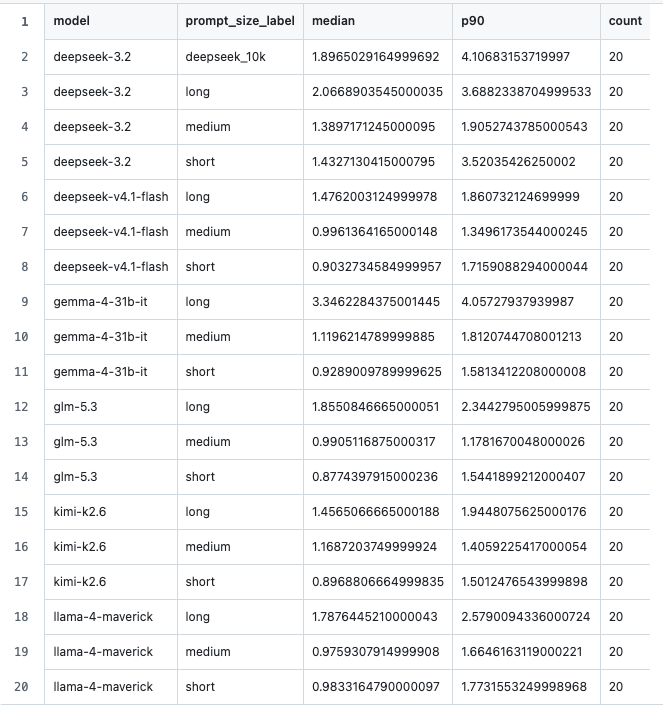
DeepSeek V3.2 在整体上稍慢一些,短提示的中位数为 1.43 秒;在测试的最苛刻条件下——完整的 10,000‑token 提示——其中位数升至 1.9 秒,90 分位数为 4.1 秒。对于大型模型面对长而密集的提示来说,这个数字还是合理的,但如果你希望在此种输入规模下为该模型实现亚秒级响应,这就值得注意了。
更有趣的结果是在扫描 DeepSeek V3.2 的全部 80 次调用以寻找异常慢的情况时出现的。有两次调用突出:一次产生第一个 token 用了 186.9 秒,另一次用了 78.3 秒。它们在开始后正常生成实际响应,约 4 秒即可完成被限制为 50 token 的回复,因此延迟完全发生在模型开始响应之前。检查其他模型在同一时间窗口内的表现没有发现可比情况。在其他五个模型的 300 次调用中,没有任何一次接近 10 秒。在 80 次调用中出现的两次长时间等待仅限于这一个模型,这在你构建依赖其一致快速响应的系统之前是很有用的信息。
另一个真正有用的结果是:Gemma 4 被特意挑选作为小型快速基准,结果显示在提示变长时它需要最多的空间来“呼吸”。其短提示中位数为 0.93 秒;长提示中位数为 3.35 秒,这一跳幅超过同范围内任何其他模型。其他所有模型在长提示下均保持在 2.1 秒以下。这提醒我们,仅凭模型大小无法预测其在提示变长时的表现。
这篇文章未告诉你的内容
这是基于上文所述默认 Tier 1 设置的一次测试,在 2026 年 9 月的一天内进行了约十分钟的测试。80 次调用中的两次长时间等待是真实的观察结果,而不是测得的失败率。说 DeepSeek V3.2 在固定比例的调用上会挣扎是不正确的,因为样本太小,无法有把握地说出这一点。公平地说,这两次情况仅在此次测试中出现在该模型上,而没有出现在其他模型上。
这些数字是在某一天的某一时刻测量得到的。容量和路由可能会变化,因此下周再次运行此测试可能会得到不同的结果。这里使用的所有内容——数据、脚本和确切的提示词——都是公开的。任何拥有 DigitalOcean 账户的人都可以运行相同的测试并查看结果。
The useful version
在这份目录中,短提示和中等长度的提示在大多数模型上均能在一秒内返回第一个 token,这一点非常稳定。如果你在这些模型的组合上构建对延迟敏感的应用,这无疑是个好消息。值得在你的规划中考虑的两点是:DeepSeek V3.2 有时会比其典型响应时间花费更长的时间来开始响应,因此如果你依赖它来实现交互式功能,请加入超时或回退机制;另外,不要假设较小的模型在提示变长时仍然保持速度优势,因为正是在这些较长的提示上,这里的某个模型失去了最多的优势。
如果你在构建需要用户观察屏幕的服务无推理(serverless inference)应用,解决办法并不是挑选头条数字最好的模型,而是在投入生产之前,先按照本测试的方式,测试你实际会使用的具体提示规模和模型。
想在自己的模型和提示规模上进行此测试吗?你可以在 DigitalOcean 账户上运行相同的环境,并将结果与这些基准进行比较。先从 Serverless Inference 快速入门 开始,然后使用 此测试的脚本和原始数据 作为你自己的运行起点。
本文中提到的所有脚本、提示词和原始结果均可在 github.com/smukherjee1do/ttft-audit 获取。



