我实测两次选择负载均衡:多问一句,热桶从2个变0个
热榜上的说法
今天刷 dev.to 热榜,看到一篇讲 2025 年 6 月那次 Cloudflare 故障的文章,评论区顺着聊到了负载均衡。有个说法被顶得很高:负载均衡的时候,每个请求不要只随机挑一个节点,而是随机抽两个候选、把请求发给更轻的那个,仅此而已,最重桶的负载就能从 130 量级掉到 5,差几十倍。我盯着这句话看了半天,直觉上不服。
不服的点很具体:如果平均负载是 100,最重桶怎么可能掉到 5?物理上就说不过去,10000 个球摊进 100 个桶,总有桶要扛平均值。我怀疑说话的人把教科书里“球数等于桶数”的经典结论,和“高负载生产场景”混在了一起讲。与其在评论区抬杠,不如自己写个模拟跑一遍,二十行 Python 的事,跑完数字自然说话。
实验设计与代码
我的设计刻意做得粗暴:10000 个球,100 个桶,平均每桶 100 个。策略 A 是纯随机扔,每个球闭眼选一个桶;策略 B 是两次选择(power-of-two choices),每个球随机抽两个桶,看一眼哪个更轻就进哪个。另外我专门设了一条“热桶”阈值 120,也就是 1.2 倍平均负载——真实系统里热桶才是要命的东西,负载超过平均两成,队列开始堆积、超时开始出现,离雪崩就不远了。
为了避免“再跑一次数字不一样”的争论,我固定了 random.seed(42),保证任何人复现都能拿到一模一样的结果。统计三样东西:最大桶负载、越过 120 这条线的桶数、负载最高的前 5 个桶。代码如下:
import random

random.seed(42)

BINS, BALLS = 100, 10000
AVG = BALLS / BINS
HOT = 120  # 1.2x average load

def place(strategy):
    bins = [0] * BINS
    for _ in range(BALLS):
        if strategy == 1:
            i = random.randrange(BINS)
        else:
            a, b = random.randrange(BINS), random.randrange(BINS)
            i = a if bins[a] <= bins[b] else b
        bins[i] += 1
    return bins

print("Load balancing: %d balls -> %d bins (avg %.0f per bin)" % (BALLS, BINS, AVG))
print("-" * 48)
res = {}
for name, s in (("random (1 choice)", 1), ("power-of-2 choices", 2)):
    bins = place(s)
    res[name] = bins
    hot = sum(1 for x in bins if x >= HOT)
    print(name)
    print("  max bin load        : %d (%.1fx avg)" % (max(bins), max(bins) / AVG))
    print("  bins with load >=%d : %d / %d" % (HOT, hot, BINS))
    print("  top 5 bin loads     : %s" % sorted(bins, reverse=True)[:5])
print("-" * 48)
m1 = max(res["random (1 choice)"])
m2 = max(res["power-of-2 choices"])
print("Worst bin shrinks from %d to %d (ratio %.0fx)" % (m1, m2, m1 / m2))
print("Two choices: one extra rand() call kills the tail risk")
真实运行结果
先看随机策略。10000 个球扔完,最重的桶扛了 126 个请求,是平均值的 1.3 倍;有 2 个桶越过了 120 的热线;top 5 的负载是 [126, 120, 118, 116, 116],从第一名到第五名拉开了一个跨度 10 的斜坡。完整输出如下:
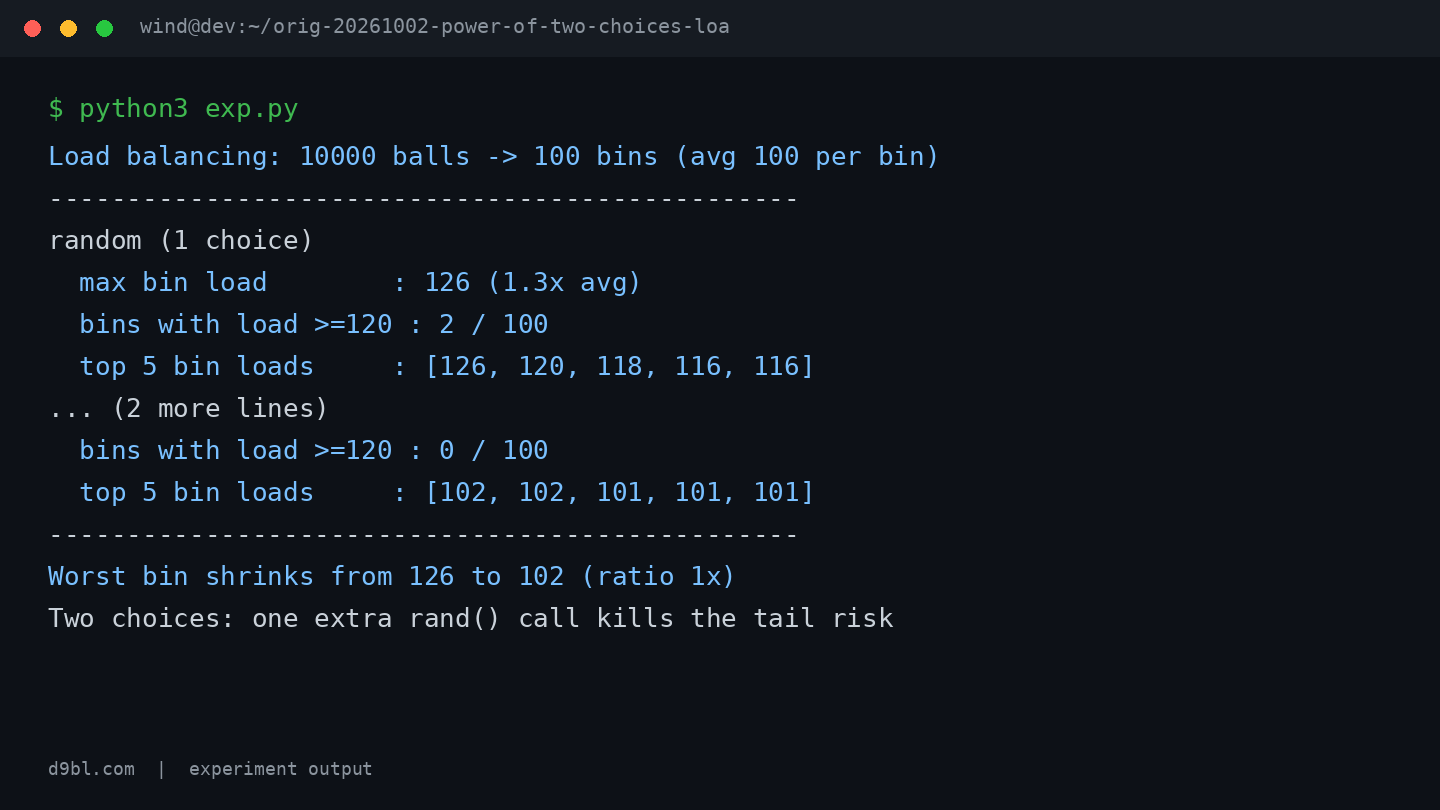
再看两次选择策略。最重桶 102,正好是平均值的 1.0 倍;越过 120 热线的桶,0 个;top 5 是 [102, 102, 101, 101, 101],五个桶挤在一个宽度只有 1 的区间里,平均负载一样是 100,尾部的形状已经完全不是一回事了。
把两份数据摆在一起看,差距不在“最重桶绝对值降了 24”这个数字上,而在分布的形状上:随机策略的尾部是拖着一条长斜坡、还有两个桶已经冒头;两次选择的尾部是被整齐削平的。每球多一次 randrange 的查询成本,换来的是热桶从 2 个变成 0 个。
反直觉发现与局限
第一个反直觉的点,是我自己代码最后一行打出来的:"Worst bin shrinks from 126 to 102 (ratio 1x)"。126 除以 102 是 1.24,我用了 %.0f 格式化,四舍五入之后直接变成了 1x,等于程序自己把自己的效果抹掉了。真跑数据的时候,一个格式化精度的小疏忽就能让关键差异在终端里消失,这是这次实验里我实打实的翻车点,后来我把那个数字当成一个提醒记下来了。
第二个问题来自实验设计本身:我只跑了 seed=42 这一次。单次实验里,126 这个最大值只是这一条随机数流的产物,换几个种子,它大概率会在 115 到 135 之间晃。两次选择带来的尾部收敛是有数学定理背书的,方向上我信,但具体数字千万别当成常数去背,要背的是“多查一次,尾部塌缩”这个模式。另外,我的模拟没有考虑节点摘除、权重差异、请求耗时分布这些真实世界的脏东西,是最理想的均匀投球场景,结论往生产里搬之前要打个问号。
还有一条必须老实交代:热榜上那句“最重桶从 130 降到 5、差几十倍”,在我这套参数下不成立。平均负载 100 倍的场景里,两次选择的收益体现在尾部概率上——热桶 2 个变 0 个、top 5 的跨度从 10 缩到 1——而不是最大值的倍数上。“几十倍”那种说法只在球数和桶数同量级的低负载场景才对得上。说话的人和听的人,往往根本没在同一个负载区间里讨论问题。
我的结论
一次额外的查询,换来热桶从 2 个变 0 个、top 5 从 [126, 120, 118, 116, 116] 收敛到 [102, 102, 101, 101, 101]。这个改动搬到你自己系统里的成本是半小时级别:连接池选节点、缓存分片、消息队列选分区,凡是能“先看一眼再决定”的地方,都值得把随机选一个改成随机选两个挑更轻的。每次多花的只是一次内存读取加一次比较,和它削掉的尾部风险相比,便宜得不像话。
动手之前我给一个具体建议:先量你自己系统的尾部,再决定要不要改。如果你的最重桶只在 1.2 倍平均值附近晃,两次选择大概率一招就能压平;如果最重桶已经冲到平均值的 2 倍以上,问题多半不在均衡策略,而在粘性会话或者热点 key 这类结构性毛病,换策略只是止痛药。最后留一个这次实验教我的事:把打印格式里 %.0f 还是 %.2f 也当成实验的一部分——数字会说话,但前提是你没在格式化的时候把它说岔了。



