引言
设想一个为你的客户报价的客服 Agent。买家询问两个零件,Agent 回复了一份清晰的总价、库存查询结果和预计送达时间。两天后买家打来电话,因为总价算错了。Agent 调试的难点就在这里。你打开日志,发现每一次工具调用都返回成功。
整轮运行正常完成,没有抛出任何异常。堆栈跟踪能解释崩溃,却解释不了一个从未报错的错误答案。Agent 从某个工具读到了一条错误记录,并在此基础上构建了一个看似可信的答案。
为了看清每种记录能揭示什么,我在一个故障服务器后面搭了一个小型零件目录。该服务器会在故障运行中精确损坏一条工具结果。我在 DigitalOcean Managed Agents 上运行了一个订单定价 Agent,共记录了 15 次会话。随后我把两个任务合计重跑了 720 次,并对一个自动化调试器的 110 次运行进行了评分。
在 5 次包含错误记录且用户未提出异议的会话中,每一次工具调用都成功,而答案都是错的。仅提供严格的应用日志时,调试器从未找到出错的那次调用。提供全部工具结果并附带逐条记录核查手段后,它在 15 次尝试中 15 次都找到了出错调用。
DigitalOcean Managed Agents 开箱即提供全栈 Agent 可观测性。本文介绍如何用它调试 AI Agent。关于如何利用该平台调试和追踪生产环境中运行的 AI Agent 的更多细节,可参阅我们的教程如何借助 Signals 发现 AI Agent 的真实故障并用评估进行测试。
控制台里没有任何标记把我检查的那次静默会话标为错误。我能判断出来,只是因为我的测试保留了正确答案用于比对。
本文涵盖:
- 为什么普通日志会漏掉一个从未报错的错误答案
- 重跑同一任务重复了什么、又没有重复什么
- 平台记录了哪些内容,Signals 捕捉到了哪些用户反应
- 每一级证据能把自动化调试器推进到多远
- 一份可复制的采集清单和一张决策表
本文建立在两篇配套文章之上。如何安全地让 AI Agent 调用生产 API 讲的是如何限制一次合法工具调用能改变什么。Agent 工具链的问题 讲的是工具使用为何会以 schema 无法捕获的方式失败。
TL;DR
- 错误答案不会报错。在 5 次静默会话中,每次只喂入一条错误的工具结果,结果 5 次全部工具调用成功,答案却全错。
- 重跑复现的是路径,不是措辞。两个任务共 720 次重跑,每个任务始终只有一条工具调用路径,但 120 次托管运行全部改变了措辞。
- 记录每一条工具结果。仅凭严格的应用程序日志,自动调试器在 15 次尝试中一次也没找到错误调用。
- 对每条记录做检查有帮助。有检查时,调试器 15 次尝试全部找到错误调用;没有检查时,只找到 9 次和 11 次。
- 把 Signals 当作回推检测器,而不是正确性检查。脚本化纠正在 4 次会话中 4 次触发了纠正信号,而无人质疑的错误答案一次也没触发。
为什么普通日志不够用
传统日志建立在关于故障的三个假设之上,下表展示了在我测试的 Agent 身上,每个假设的表现如何。
| 假设 | 普通服务 | 我测试中的 Agent | 应该改记什么 |
|---|---|---|---|
| 故障可复现 | 通常如此:相同输入,相同代码路径 | 部分成立。工具调用路径重复了,措辞没有。一次性的错误记录在重跑中再未出现。 | 原始运行中的工具结果 |
| 错误会自己暴露 | 抛出异常、返回 5xx 响应或超时 | 不会。5 次静默会话全部干净结束,答案却是错的。 | 每个答案背后的输入,以便事后核查 |
| 追踪能显示路径和原因 | Span 显示哪个函数失败 | 部分成立。平台回放显示了参数和结果,但没有系统提示词。普通日志两者都没有。 | 每次调用的参数、完整结果、模型 ID 和提示词版本 |
静默失败是指运行正常结束却返回错误答案。对照组会话拿到干净数据,5 次全部正确。静默会话唯一的差别是数据,所以代码路径中没有任何环节有理由失败。
Schema 检查在这里也帮不上忙。大规模结构化输出的可靠性讨论的是工具调用是否格式正确,而这些会话中的每次调用都格式正确。
我如何测试 Agent 调试
我在一个小任务中埋入一条错误的工具结果,并尽可能保留所有记录。
Agent 为一份包含两个目录零件的订单报价,共发起 6 次工具调用:get_part、get_supplier 和 get_shipping_quote,每个零件各调用一次。随后它报告订单总额、库存不足的零件、供应商最长交货周期以及最长运输时间。
目录存放在 DigitalOcean Action Gateway 背后的故障服务器上。Action Gateway 是 Managed Agents 中负责保管工具凭据的服务,它通过凭据代理机制来路由 Agent 的工具调用。Agent 始终看不到密钥一文详细介绍了这套代理机制。在故障运行中,服务器会篡改一次工具返回结果;再次查询同一条记录时,返回的数据是干净的。
我跑了三个变体,每个变体统计 5 次会话:
- 对照组:无故障。5 次回答全部正确。
- 静默组:一次结果被篡改,用户没有任何反应。5 次回答全部错误。
- 纠正组:一次结果被篡改,随后用户指出答案有误。纠正后 5 次中有 4 次回答正确。
flowchart LR
  A("Agent on Managed Agents") --> G("Action Gateway")
  G --> F("Fault server with catalog tools")
  F -- "one corrupted result" --> G
  G --> A
  A --> L1("Plain log: request and final answer")
  A --> L2("Full capture: every call, argument, and result")
  G --> L3("Platform record: session event replay")
下图展示了我对比的三级证据:
- 普通日志是大多数应用写下的内容:请求、模型调用和最终答案。
- 完整捕获是一个文件,记录每次工具调用、其参数和完整结果。
- 平台记录是 Managed Agents 中会话的事件回放。
计入统计的 15 个会话,平台报告的运行成本约为 $1.59。加上一次被拦截的尝试后,总额升至约 $1.72;再把未记录的尝试也算上,约为 $1.80。计入统计的会话成本中位数约为 $0.08,范围为 $0.08 至 $0.16。当前费率见推理定价页面,不同流量场景下的 token 经济性一文则介绍了服务成本如何随规模变化。
所有脚本、种子数据和原始日志都在证据仓库中。完整设计见其 METHODS.md。你可以用一份干净的副本重新核对每一个数字:
git clone https://github.com/vinayakbaranwal12/why-agent-debugging-is-different-from-traditional-logging.git
cd why-agent-debugging-is-different-from-traditional-logging
python3 harness/scripts/verify_all.py | tail -n 1
Output121 ran and passed, 0 failed, 19 skipped (7 CLEANUP.md is not published in this repo, 1 human arm not run, 4 no salt, 1 no simulation results, 2 timing comes from the author's original local history, 4 working notes and screenshots are not published in this repo) -> results/verification_report.md
这行输出来自一份干净的仓库副本,用系统 Python 运行,既没有 salt,也没有 git 历史。每个被跳过的检查都注明了原因,而大多数跳过项涉及的是我没有公开的工作文件。
本次测试没有说明什么
- 我只测了一个小型目录、一个 Agent 任务、一种故障类型,每种配置只用一个 Agent 模型。
- 故障只触发一次。数据源持续出错是另一种情况,再查一次也恢复不了。
- 用户反应是脚本预设的,Signals 批次规模小、分布不均,且不在计入统计的 15 次会话之内。
- 调试器是模型,不是真人。我准备了人工对照,但没有实际运行。
- 按设计,成对的调试器条件只在参考查询上有差别,但我无法把它的影响和采样噪声分开。
- 控制台发现的问题,每条都只来自一次受检会话。
- 回放在 121 次调用中全部与服务器返回的 payload 一致,但只覆盖小型 JSON 响应。大体积或裁剪过的输出没有测。
- 所有运行都在 2026 年 10 月 20 日至 24 日之间完成,且只在一个团队内进行。
- 一个 AI 辅助脚本从原始日志重新计算了每个数字。我是在已经知道主要数字之后才写这个脚本的,所以核对并非盲测。
- 在计分运行之前,我把每个预测文件都提交到了本地 git 历史。当时没有推送任何内容,因此这个时间点无法从外部验证。
我的发现
下面给出五项结果,从重跑同一个任务,到让自动调试器查找一个植入的错误调用。
重跑同一任务说明了什么
重跑每次都复现了工具调用路径,却仍然找不回那条只出现一次的错误记录。
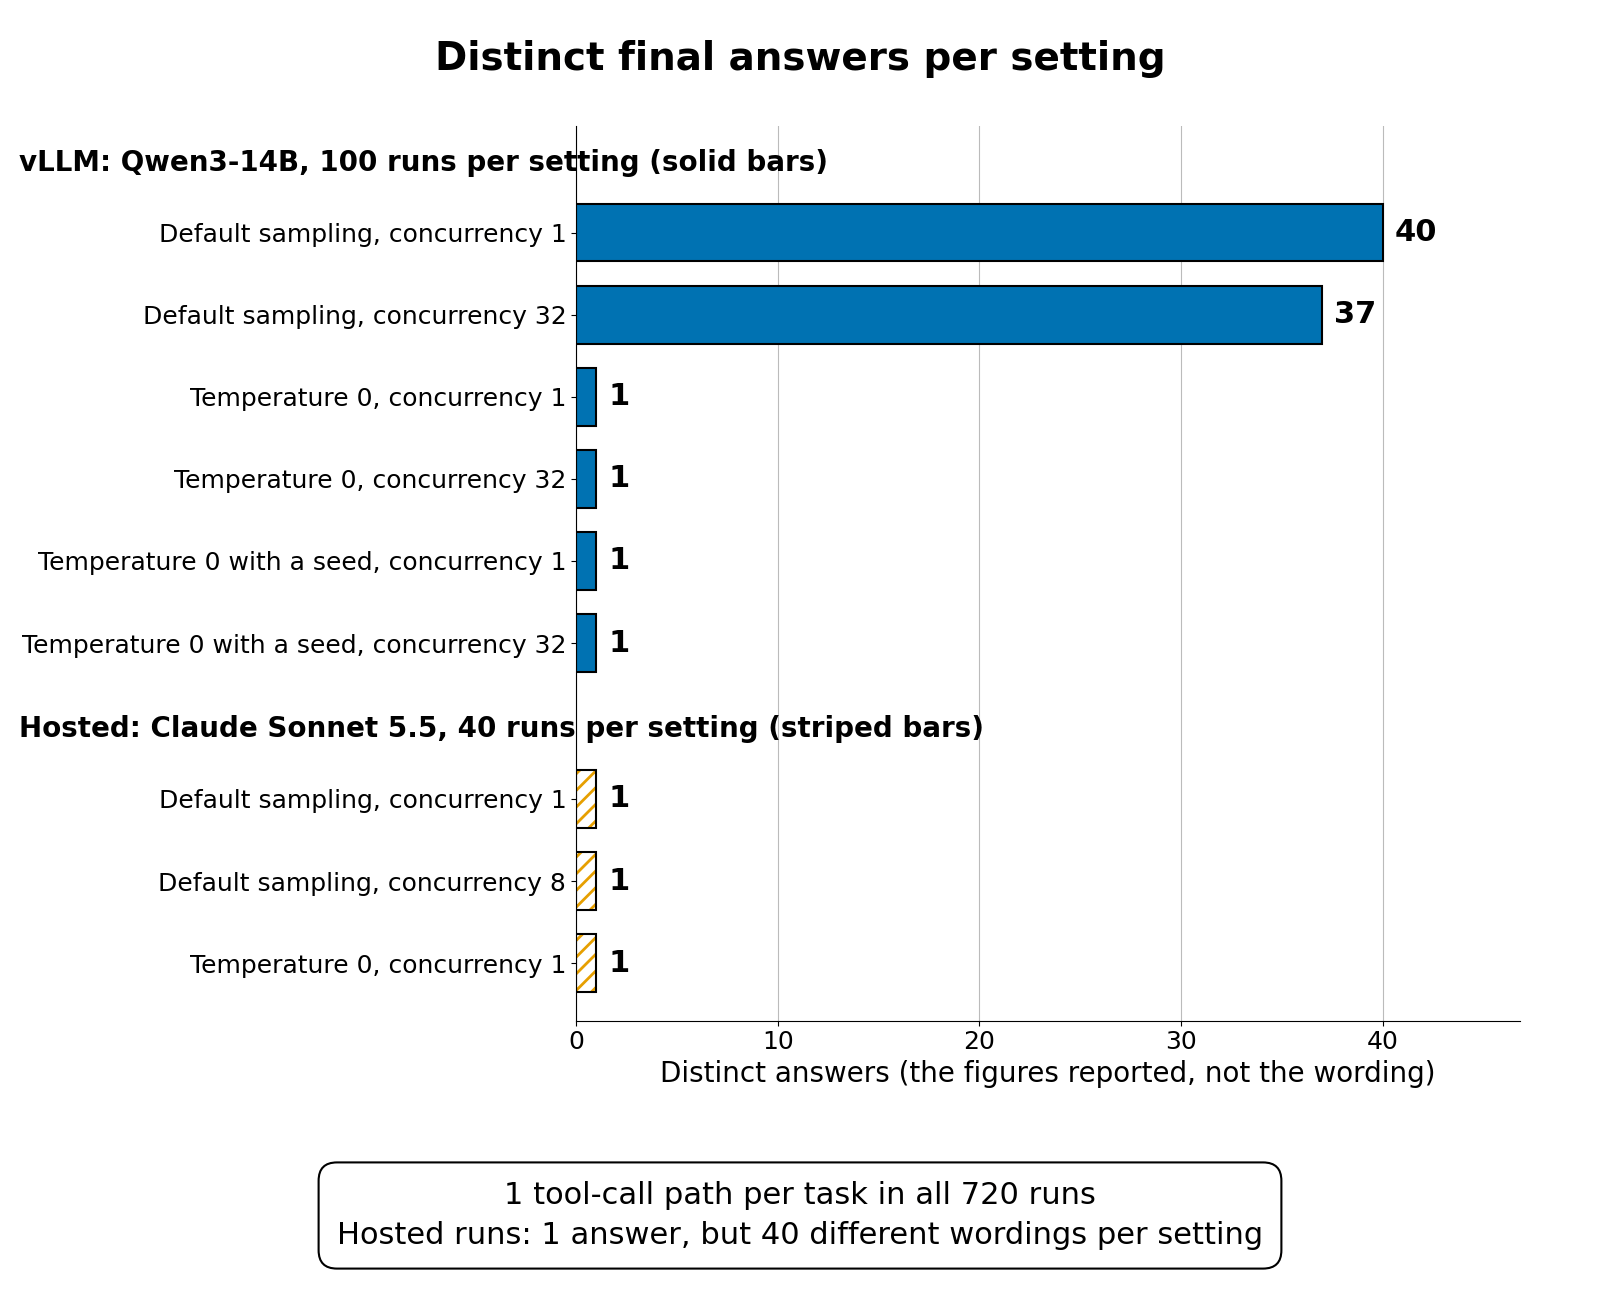
第一个任务跑在 Qwen3-14B 上,由单块 H200 GPU Droplet 上的 vLLM 0.27.1 提供服务。我在 6 种配置下各跑了 100 次。第二个任务跑在 DigitalOcean Serverless Inference 上的 Claude Sonnet 5.5,在 3 种配置下各跑了 40 次。
采样意味着模型在挑选每个词时带有一定随机性。温度决定随机程度,温度设为 0 时模型直接取概率最高的选项。随机种子则固定随机选择。所有配置下路径都保持不变,而答案在采样下会发生变化:
| 配置 | 运行次数 | 不同工具调用路径数 | 不同答案数 |
|---|---|---|---|
| Qwen3-14B,默认采样,每次 1 个请求 | 100 | 1 | 40 |
| Qwen3-14B,默认采样,同时 32 个请求 | 100 | 1 | 37 |
| Qwen3-14B,温度 0,带或不带随机种子 | 400 | 1 | 每种配置均为 1 |
| Claude Sonnet 5.5,默认采样或温度 0 | 120 | 1 | 每种配置均为 1 |
每次 vLLM 运行都走了相同的 4 个模型步骤和相同的 6 次工具调用。只有最终答案变了,而且只在采样下才会变。这 600 个答案也没有一个完全正确。模型每次都把零件、交货周期和运输算对了,却每次都把订单总额算错。这是一次静默失败,完全没有注入任何故障。
这个任务太简单,不足以产生分支。在 32 请求的运行中,每个 worker 都在同一时刻发送相同的提示词,因此服务器每次看到的都是同一批次。这种配置无法捕捉不同请求共享同一批次所带来的影响。
Thinking Machines Lab 在《Defeating Nondeterminism in LLM Inference》一文中指出,这些正是繁忙服务器上温度 0 仍产生不同输出的主要原因。前缀缓存当时处于开启状态。它会复用开头相同的提示词所对应的计算,因此可能成为两个并发级别之间的混淆因素。
第二个任务提供了四个部分供比较。模型每次都检查全部四个部分,在全部 120 次运行中以相同顺序发起了 13 次调用。每种配置都是 40 次全部答对。该任务允许检查所有内容,因此从未强制模型做出取舍。
措辞从未重复。每种配置下 40 条最终文本各不相同,温度 0 也不例外。token 总数接近但不相等:419,330、418,908 和 419,014。客户端无法判断托管端点是否强制执行温度设置。在我自己的 vLLM 服务器上,温度 0 在全部 400 次运行中给出了相同答案。
路径和答案重复了,措辞却没有。故障也没有重复,因为第二次查询返回的是干净数据。在我的测试环境中,这种一次性行为是刻意设计的。我在真实环境中没有观察到这种现象。
平台记录了什么
要解释一个错误答案,我需要的信息大部分都在会话回放里,而控制台视图根本分不清答案是对是错。
事件回放是按顺序列出一次会话产生的所有事件。在我的会话里,它列出了从运行开始到结束的每次模型调用和每次工具调用,包括参数和结果。下表覆盖15次计入统计的会话,除非某行另有说明。
| 我要找的内容 | 位置 | 是否找到 |
|---|---|---|
| 工具参数 | 会话事件回放 | 有,15次会话全部找到 |
| 完整工具结果 | 会话事件回放 | 有,121次调用中121次与服务器负载一致(小型JSON响应) |
| 每次模型调用的token用量 | 会话事件回放 | 有 |
| 模型ID | 会话事件回放 | 有,15次会话全部与配置一致 |
| 系统提示词、工具schema、结束原因 | 会话事件回放 | 没有 |
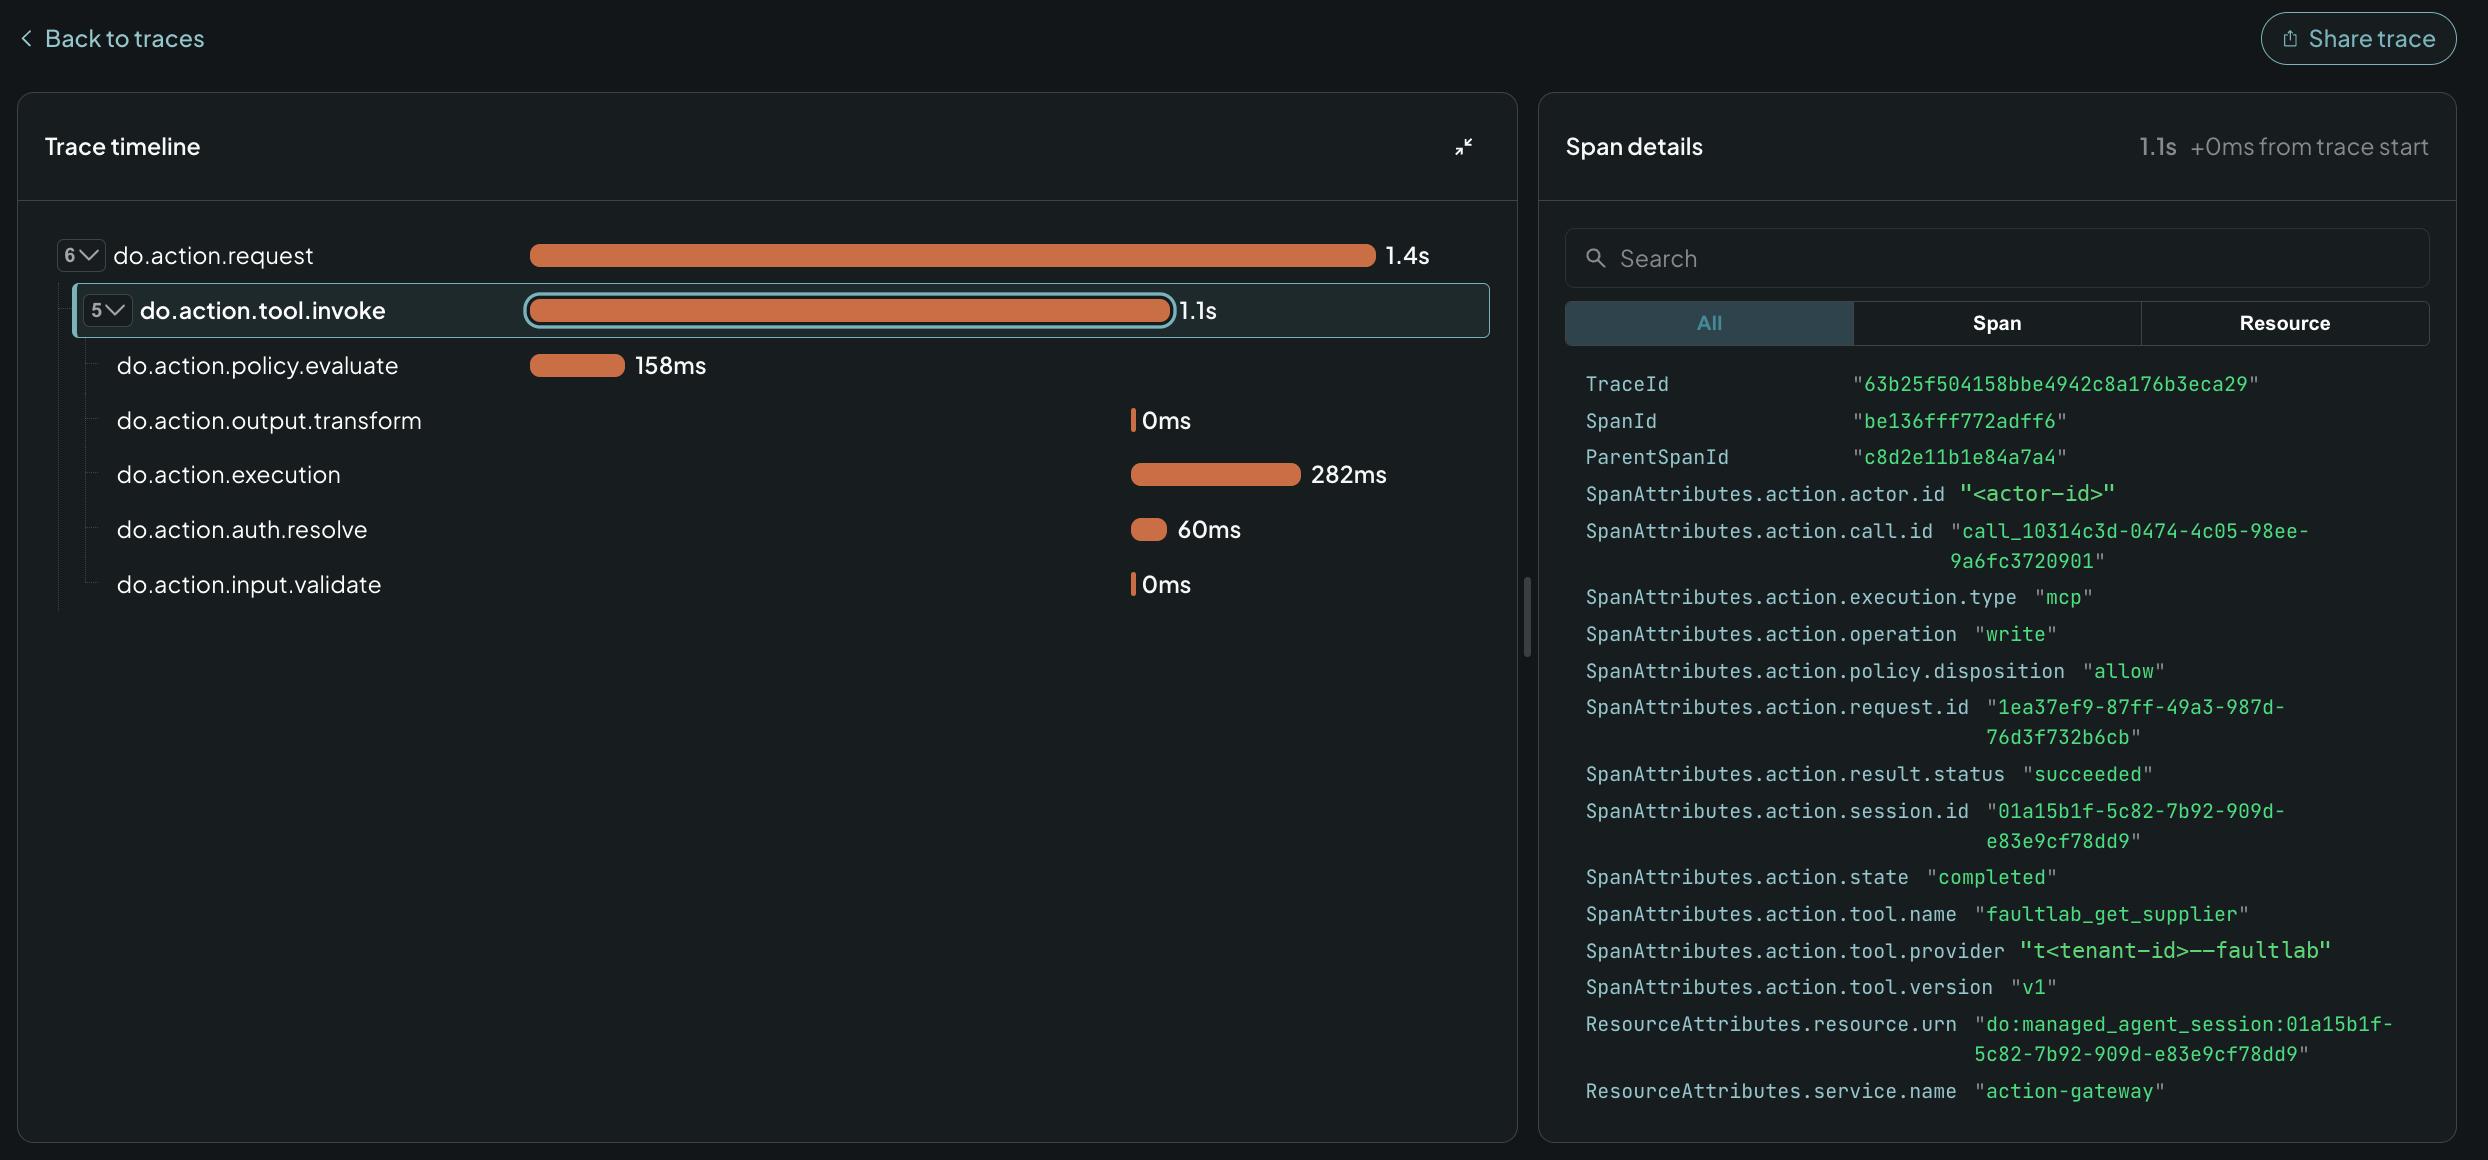
| 网关trace span上的工具参数或结果 | Insights trace | 没有(检查了一次会话) |
| 任何标记答案错误的标志 | 会话页面和Session Insights | 没有(两类各检查了一次会话) |
修正后的运行1中,一次工具调用的网关span列出了工具名、提供商和状态,但没有参数或结果。截图中有两个属性值替换成了占位符。
在7天范围内,Session Insights对错误答案和正确答案显示的状态、标签和指标完全相同。token计数也区分不开。如果最近的会话发送了相同的提示词,提示词缓存就是热的,计入新输入的token就更少。token计数反映的是缓存热度以及额外的查找,而不是对错。
间隔后的第一次会话显示约48.6k输入token。同一批次中后续会话约13.6k,无论对错。静默会话用了139到145个输出token,与健康对照组处于同一区间。修正后的会话用得更多,因为Agent又重新查了一遍。
控制台的输入数字统计的是未缓存输入加缓存创建token,不含缓存读取。对照运行1显示48.7k,加上缓存读取后为192,304。回放以两种方式报告输出token。其按调用统计的用量事件在16次会话中合计2,836,与控制台一致。其运行总计合计21,480,两个数字我都报告。
修正后的会话说明,再看一遍能带来什么。在修正运行 1 中用户提出异议后,Agent 回复:“你说得对,我最初的答案是错的。我第二次查询 P-5310 时,工具返回了不同的数据。”它还补充道:“我无法解释数据为何变化,所以我采用了最新值并重新运行了链路。”重新检查之所以有效,是因为故障只触发一次。在 5 个修正会话中有 1 个,Agent 没有重新查询就再次作答,结果仍然是错的。
静默失败与用户的原话
Signals 将用户的反驳标注为四类,无论答案对错;对于礼貌提问或沉默,则不打任何反应标签。
Signals 是 Managed Agents 的一项功能,它会读取对话并标注纠正、请求人工介入等时刻。How to use Signals with Harness Runtime 介绍了相关设置。我在 Agent 首次作答后脚本化了一条追问,这些探索性批次不计入那 15 个会话:
| 逐字追问 | 会话数 | 触发的 Signal |
|---|---|---|
| “不对,我问的不是这个。总额错了,请重新核对供应商和运费数据。” | 4 | Correction,4/4 |
| “我换个说法:我需要这两个零件的订单总额,请再次使用目录工具。” | 6 | Rephrase,6/6 |
| “又错了。我要找人工。” | 4 | Escalation,4/4 |
| “算了,我自己来。” | 3 | Quit,3/3 |
| “运费为什么这么高?你能解释一下这个数字是怎么算出来的吗?” | 5 | 无反应标签(一个参数漂移标签) |
| 答错后无追问(另一批静默会话) | 3 | 无 |
标签跟随用户的原话触发。根据批次记录,在 17 个带标签的会话中,有 3 个的首次答案本来就是对的,标签同样触发了。
最让我担心的是礼貌提问。一个对数字存疑、询问它是怎么算出来的用户,在 Signals 看来却像是一个没有抱怨的用户。它没能发现无人注意的错误答案,也就是静默情况。
我还发现了一个数据接入缺口。我在10月20日和21日创建的17个会话从未出现在Signals中。到采集时长为约24至37小时的时候,它们仍然不见踪影。10月22日创建的会话在2到4分钟内就出现了,我不知道原因。Signals and Simulations发布文章描述了预期的流程。
运行一次Simulation时发生了什么
Simulation会让你的Agent与模拟用户对话,同时由评判模型为每段对话(即每个episode)打分。
两次导出被标记的会话(每次各含一个会话和一个信号),在大约30分钟内都没有生成任何场景集。我根据一个定价目标手动构建了一个,没有尝试手动的“Scenarios from Signals”步骤。它的场景预期结果为空,因此评判模型实际打分的是停止条件。会话数量有所不同:
| 运行 | 团队会话数 | 结果 |
|---|---|---|
| 第1次和第2次运行 | 60个,在运行前最后一次统计时全部处于暂停状态 | 约1秒内失败,消耗0个token |
| 第3次运行,约13小时后 | 移除9个后剩51个 | 完成4个episode中的4个 |
失败的运行只提示“The agent could not complete this conversation.”。这与60个会话的上限相符,但在一项公开预览服务上仅有一次恢复,并不能作为证据。
第三次运行的平均通过率为75%,即目标完成率50.0%与工具使用率100.0%的平均值。在episode 1中,Agent报告“the gateway still shows no connection to the “faultlab” provider”,并要求提供数据。评判模型以0.54的分数判定其通过,称这次通过“主要来自诚实、连贯的规划和清晰的后续步骤,而非完成任务”。这属于部分得分。
工具使用在全部4个episode中都通过了,尽管episode 1中的每次查询都在网关处失败。评判由Agent自身配置的模型Claude Sonnet 5.5完成,DeepSeek V4 Flash 0731扮演用户。故障并未处于激活状态,因此这次测试的是流程,而非修复效果。这些分数所依据的控制台截图裁剪副本存放在证据仓库中。
用不同层级的证据定位故障
完整的工具结果能让自动化调试器找到错误调用,而仅凭普通日志基本做不到。
我把一个全新的模型 Claude Opus 5.5 逐个案例交给它,让它指出第一个返回坏数据的工具调用。这个调试器是模型,不是人。每个实验组(即测试条件)只给它一个层级的证据,每组跑 5 个案例、重复 3 次,共 15 次尝试。在 6 个调用里瞎猜,命中率是六分之一。
日志组、完整捕获组和平台记录组各自使用自己的 5 个案例。只有带查找和不带查找配对的实验组共用案例。
其中两个实验组还配了参考查找。参考查找是一个工具,返回记录本应是什么样子。我在第二轮把它去掉了。下面是每个证据层级让调试器走到了哪一步:
| 调试器掌握的证据 | 找到坏调用 | 归咎于下游调用 | 指认了错误调用 | 放弃 |
|---|---|---|---|---|
| 严格日志:请求、模型调用和答案行 | 0/15 | 0/15 | 0/15 | 15/15 |
| Agent 自己写的日志 | 7/15 | 0/15 | 8/15 | 0/15 |
| 完整捕获 + 参考查找 | 15/15 | 0/15 | 0/15 | 0/15 |
| 仅完整捕获 | 9/15 | 3/15 | 3/15 | 0/15 |
| 平台记录 + 参考查找 | 15/15 | 0/15 | 0/15 | 0/15 |
| 仅平台记录 | 11/15 | 1/15 | 3/15 | 0/15 |
下游调用是指 Agent 仅仅因为坏记录改变了后续内容才发起的调用。
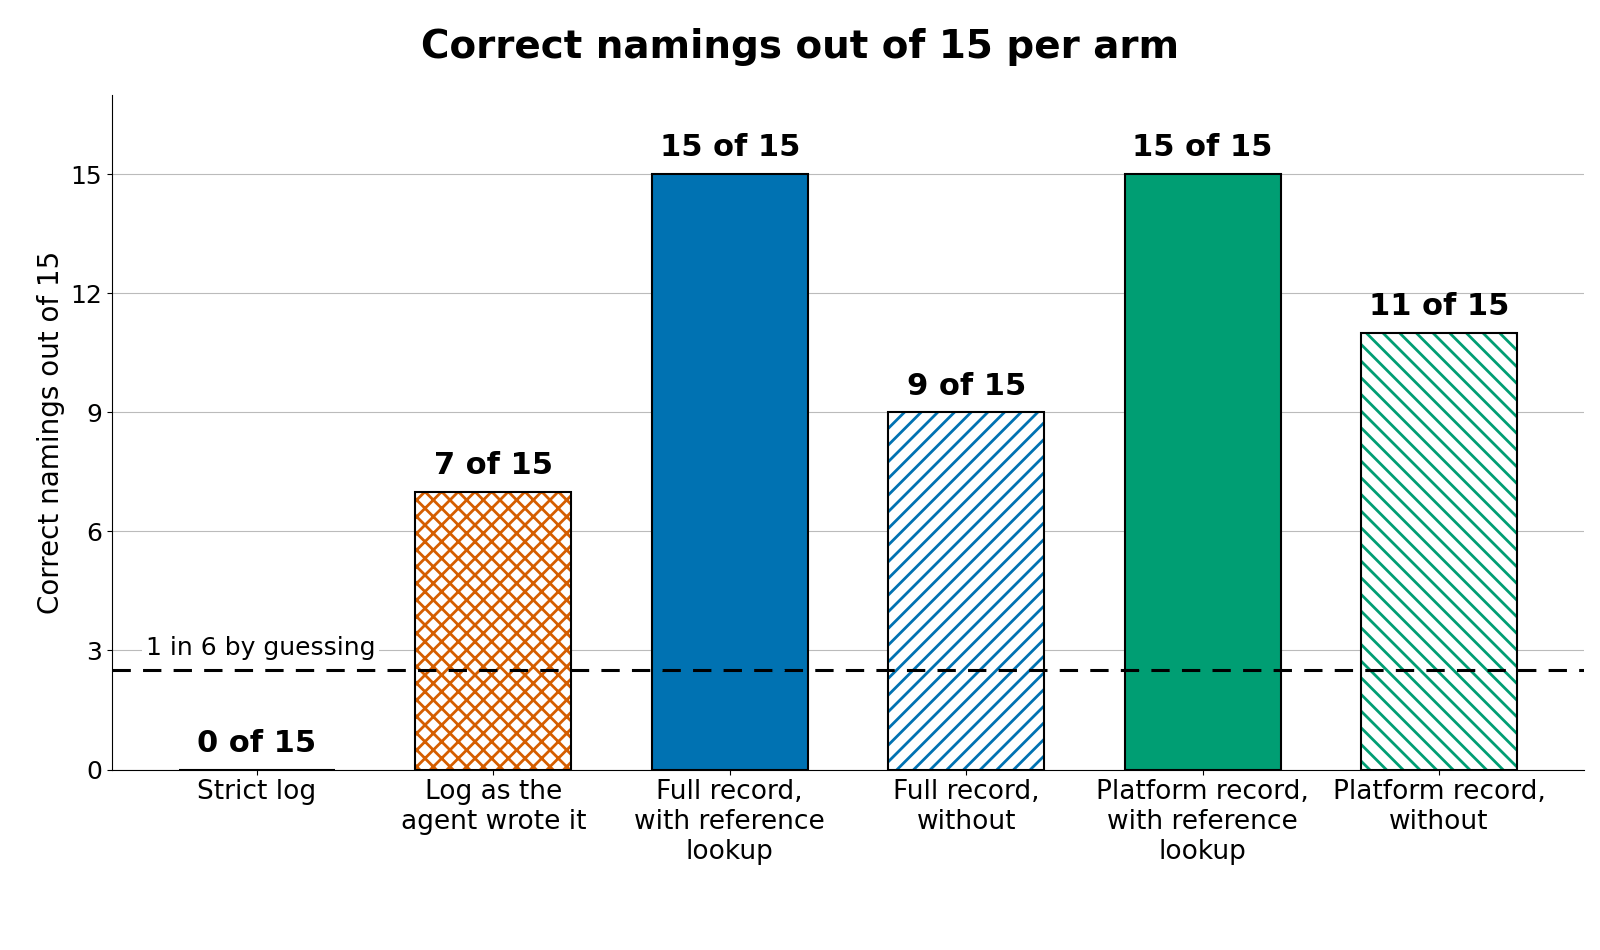
Agent 自己写的日志表现比我预想的好,因为它在最终回答里絮絮叨叨地复述了工具数据,比如零件名称、供应商和价格。如果把日志削减到只剩答案行,调试器每次都放弃——这和猜错不是一回事。
去掉参考查找后,完整捕获组少对了 6 次,平台记录组少对了 4 次。仅凭记录已经好于随机猜测,但比不上记录加一种校验手段。查找是每一对实验组之间唯一刻意设置的差异。不过,每个案例重复 3 次、温度设为 0.7,差距中可能有一部分是采样噪声。
失误按案例聚集。没有查找时,每个实验组在 5 个案例中有 3 个每次都能找到坏调用,所有失误都来自另外两个案例。在完整捕获组里,这两个案例中一个每次都指向下游调用,另一个每次都指认错误调用。5 个案例、每个重复 3 次,我只能说到这里。
不带查找的实验组的预测,是我在已知早先结果之后写的,距离第一次计分运行还有 16 秒。不带查找的完整捕获组低于我预测的区间。
为了验证测试环境是否可靠,我在每组里混入了 5 次干净运行,并配上参考查询。两组都没有误判干净运行,也都准确指出了每个出错的运行。有了参考查询,清理一个出错运行只是机械操作,所以这一步检验的是测试环境,而不是调试器本身。
完整捕获的失效场景
完整捕获补上了最大的缺口,但我的测试仍然碰到几个限制,制定捕获方案时必须覆盖这些情况。
- 大输出。我只对小型 JSON 响应验证了完整结果。经过裁剪或截断的输出,可能恰好丢掉出错的那个值。
- 持续出错的来源。第二次查询救回了修正后的会话,是因为故障只触发了一次。如果来源持续出错,每次都会返回同一条坏记录。
- 会话上限。一批新会话在 409 错误处停下,错误信息写着“team is at the limit of 60 active sessions”。后来我回看第一次 Simulation 之前的最后一次计数,显示有 60 个暂停会话,而失败信息里根本没提会话。根据 Harness Runtime sessions 页面,provisioning、ready 和 paused 状态的会话都计入上限,只有删除会话才能腾出名额。空闲会话 15 分钟后会自动暂停,所以测试团队一忙,名额就悄悄占满了。Harness Runtime limits 页面说明,上限取决于你的资源层级,最高可同时支持 100 个会话。
可直接照搬的捕获清单
用这张表来决定每种 Agent 行为该记录什么。
| 如果你的 Agent | 记录这些 | 为什么重要 |
|---|---|---|
| 通过工具读取数据 | 每次工具调用的参数和完整结果;输出较大时记录哈希值和指针 | 一次性的错误记录在重跑时不会复现 |
| 基于工具数据计算答案 | 用到的输入,以及作为结构化字段的答案 | 之后可以核对算术过程,就像调试器那样 |
| 运行在多个模型或提示词上 | 每次调用记录模型 ID 和提示词版本 | 回放时有模型 ID,却没有系统提示词 |
| 与可能反驳的用户对话 | 后续文本和任何 Signals 标签 | 在我的批次里,Signals 给反驳打了标签,对沉默则没有标签 |
| 由人或模型进行调试 | 关键记录的引用查找 | 在我的测试中,去掉它导致 6 次和 4 次正确命名丢失 |
| 运行大量测试会话 | 会话 ID,然后清理已结束的会话 | 暂停的会话占满了全部 60 个槽位 |
| 由评审模型打分 | 每个场景的预期结果 | 预期结果为空时,评审模型打的是停止条件的分,而不是真实答案 |
在我的测试中,带完整工具结果的实验组在 15 次尝试中有 9 到 15 次找到了错误调用。严格日志则一次都没找到。
DigitalOcean 负责什么,你仍需自己负责什么
托管服务负责运行 Agent 并保存会话记录,而判断对错的检查仍由你负责。
| 需求 | DigitalOcean 负责的部分 | 你仍需自己负责的部分 |
|---|---|---|
| 运行 Agent 并保留记录 | Managed Agents 负责运行 Agent。在我的会话中,事件回放保留了工具参数和结果。 | 系统提示词和工具 schema 版本,以及超出小型 JSON 输出范围的任何内容 |
| 保管工具凭据 | Action Gateway 会话代理与各工具提供方的连接 | 某个会话或 Simulation 使用哪条连接 |
| 限制可运行的工具 | 工具策略 | 调试会话可以调用哪些工具 |
| 发现用户的反驳 | Signals 在我的批次中标记了纠正、改述、升级和退出 | 发现无人质疑的错误回答 |
| 用模拟用户进行测试 | Evaluations 使用评判模型运行 Simulation,按 Evaluations 定价页面所列计费 | 预期结果,以及运行前的免费会话名额 |
| 提供模型服务 | Serverless Inference | 跨模型的路由和支出限制,如使用 Inference Router 进行成本治理中所述 |
在我的测试中,Harness Runtime 会话和 Simulation 在控制台里都带有 Public Preview 标签。
关于本主题的常见问题 ?
1. 如何监控和追踪生产环境中运行的 AI Agent?
用四个层面,并弄清每个层面能告诉你什么、不能告诉你什么。在 DigitalOcean Managed Agents 上,这四层已经打通,你可以轻松地在一个测试 Agent 上把整套机制跑一遍。
- 单次调用追踪。会话的事件历史(用
doctl harness-runtime logs可回放)会记录每次工具调用的参数和完整结果,以及模型 ID 和 token 用量。在我的会话里,正是靠它才定位到那条错误记录。它不保存系统提示词,所以这部分需要你自己做版本管理。 - 运行指标。Insights for Harness Runtime 展示会话如何启动、暂停、等待审批以及消耗 token。Action Gateway 用量会追踪经过网关的每一次工具调用。这些只能说明 Agent 在运行,不能说明它运行得对。
- 对话分诊。Signals 会读取对话内容,并标记出纠正、改述、请求人工介入、用户退出等关键时刻。在我处理的批次中,这些情况它全都捕捉到了,而且它是这里唯一会读取用户原话的层面。要在创建希望它观察的会话之前启用它,并使用 doctl 2.1.0 或更高版本。
- 修复前后的测试。Evaluations 中的模拟会让你的 Agent 面对模拟用户运行,同时由评判模型为每一轮打分,这样就能用当初暴露问题的同一批场景来验证修复效果。
以上任何一层都不会自行标记出一个看似合理、实则错误的数字。你仍需自己把关的一项检查,是把 Agent 的回答与可信来源做比对。把这项检查叠加在四个层面之上,然后从小处着手:一个 Agent、开启 Signals、一个包含两个场景的模拟。一天之内你就能看出,哪些故障平台已经记录在案,哪些还需要你自己测试。
2. 为什么传统日志无法调试 AI Agent?
传统日志记录的是错误,而 Agent 最严重的失败往往并不是错误。在我的测试中,5 个静默会话全部因为一条错误的工具结果而结束,过程干净利落,每次工具调用都成功,答案却是错的。如果日志里没有工具结果,就很难看出哪条记录出了问题,除非 Agent 的回答恰好复述了那条数据。只有记录每次调用的参数和完整结果,才能定位到那次错误调用。
3. 把 temperature 设为 0 就能让 AI Agent 可复现吗?
只能部分复现。在我自己的 vLLM 服务器上,temperature 设为 0 时,400 次运行给出的答案完全一致。而在托管端点上,temperature 设为 0 时,工具调用路径和答案都能重复,但 40 次运行的最终文本各不相同。重跑也无法还原某次一次性出现的坏记录,所以要保留原始工具结果。
4. AI Agent 每次工具调用应该记录什么?
每次调用都要记录工具名称、参数、完整结果、模型 ID 和提示词版本。输出较大时,存一个哈希值和指向完整结果的指针。在我的测试中,仅凭完整工具结果,自动调试器在 15 次尝试中有 9 次和 11 次找到了错误调用。再加上逐条记录校验的手段后,15 次全部找到。
结论
本文说明了为什么 Agent 调试不能只靠错误日志:最棘手的失败并不是错误。在 5 个静默会话中,每个会话都有一条错误的工具结果,每次调用都成功,答案却是错的。完整工具结果对自动调试器至关重要。配合参考查询时,它在 15 次尝试中全部找到了错误调用;没有参考查询时,只在 15 次中找到了 9 次和 11 次。
现在你就可以决定 Agent 每次工具调用记录哪些内容,不必等客户先发现错误答案。保留参数、完整结果、模型 ID 和提示词版本。把 Signals 当作反向信号检测器,并清理不再需要的测试会话。
想进一步深入,可以克隆证据仓库,在你自己的副本上运行验证脚本。然后阅读如何安全地让 AI Agent 调用生产 API,限制一次合法工具调用能改变什么。
参考资料
- DigitalOcean,如何借助 DigitalOcean Action Gateway 让 AI Agent 安全调用生产环境 API,2026-10-16
- DigitalOcean,Agent 工具链的痛点,以及 DigitalOcean Action Gateway 如何应对,2026-09-23
- DigitalOcean,大规模场景下的结构化输出可靠性:并发压力下 JSON Schema 校验为何失效,2026-09-03
- DigitalOcean,Agent 始终看不到密钥:验证 DigitalOcean Action Gateway 的凭证代理机制,2026-09-16
- DigitalOcean,专用 GPU 上不同流量特征下的 Token 经济性,2026-07-08
- DigitalOcean,借助 Inference Router 实现多模型 API 成本治理,2026-06-23
- Thinking Machines Lab,消除大模型推理中的不确定性,2025-09-10
- DigitalOcean,推出 DigitalOcean Signals 与 Simulations:看清 Agent 和模型在生产环境中的真实表现,并在上线前验证修复方案,2026-10-12
- DigitalOcean 文档,Managed Agents
- DigitalOcean 文档,如何在 Harness Runtime 中使用 Signals
- DigitalOcean 文档,会话(Sessions)
- DigitalOcean 文档,DigitalOcean Harness Runtime 限制
- DigitalOcean 文档,DigitalOcean Evaluations 限制
- DigitalOcean 文档,推理定价