我用四组数据实测霍夫曼:压缩率差出一个数量级
热榜上挂着一条 "MoE Offloading Isn't Always Faster: I Tested 5 Models on a 16GB GPU",标题本身就是结论——不是永远更快。我还没点进去就猜到作者会说什么:同一个技术,换一组负载,结论翻面。压缩这边有一句流传得更久、更硬的话:"霍夫曼编码能把文本压掉三成。" 我不认这句话,不是因为它是错的,而是它把"三成"说成了算法的固定属性,好像跟数据长什么样没关系。上周我花了一晚上把这句话拆开,四组数据,两个算法,同一段 Python。
热榜上的"实测"和压缩圈那句话
那条 MoE 的帖子之所以能上热榜,是因为它挑战的是一个默认预期:把专家网络卸载到内存里应该更快。作者拿 5 个模型在 16GB 显卡上跑,结论是"看情况"。我对这类标题有天然好感,因为我自己写基准测试时最怕的就是得出一个漂亮但脆弱的数字。压缩领域恰好有太多漂亮数字在流传,其中两个我听得最多:霍夫曼压缩率高,大约三成;RLE 过时了,只配处理位图。
我的直觉是这两句都站不住。霍夫曼的平均码长被熵卡死,它能省多少,取决于原始定长编码浪费了多少;RLE 的收益则完全押在重复串的长度上,跟"过不过时"没有半点关系。这两句话真正的问题是把算法当成常量,把数据当成背景。于是我把它们反过来写:先造四组分布完全不同的数据,再让两个算法在同一套指标下正面撞一次。
实验设计与代码
四组数据都是 4000 个字符左右的字符串。第一组是英文,用一句话循环 60 次截断到 4000 字符,字符高度偏斜,空格和 e、t 占大头;第二组是 26 个字母按 Zipf 权重抽 4000 次,模拟"少数符号高频、长尾极长"的分布;第三组是 26 个字母均匀随机抽 4000 次,这是最坏情况;第四组是 40 段长度 50 到 150 的重复串拼起来,专门喂给 RLE。
指标只有两个,都用 bits/symbol 表示,越小越好。霍夫曼这一侧我不建树,直接用"每次合并两个最小频次、累加合并代价"的经典算法算平均码长,结果等价但省掉码表遍历。基线是定长编码 ceil(log2(k)),26 个符号就是 5 bit。RLE 这一侧我用的是 16 bit/run 的模型:一个字节存值,一个字节存长度,run 上限 255,这也是最朴素的实现方式。
import math, random, heapq
from collections import Counter

random.seed(42)

def entropy(seq):
    n = len(seq)
    return -sum((c / n) * math.log2(c / n) for c in Counter(seq).values())

def huff_avg(seq):
    counts = list(Counter(seq).values())
    n = sum(counts)
    if len(counts) == 1:
        return 1.0
    heapq.heapify(counts)
    cost = 0
    while len(counts) > 1:
        a, b = heapq.heappop(counts), heapq.heappop(counts)
        cost += a + b
        heapq.heappush(counts, a + b)
    return cost / n

def rle_avg(seq):
    n, runs, i = len(seq), 0, 0
    while i < n:
        j = i
        while j < n and seq[j] == seq[i] and j - i < 255:
            j += 1
        runs, i = runs + 1, j
    return 16.0 * runs / n

letters = 'abcdefghijklmnopqrstuvwxyz'
base = 'the quick brown fox jumps over the lazy dog while a compiler quietly rewrites every loop '
text = (base * 60)[:4000]
zipf = random.choices(letters, weights=[1.0 / (i + 1) for i in range(26)], k=4000)
uni = random.choices(letters, k=4000)
runs = ''.join(random.choice(letters) * random.randint(50, 150) for _ in range(40))
sets = [('english text', text), ('zipf letters', zipf),
        ('uniform 26', uni), ('long runs', runs)]

print("set".ljust(13) + "n".rjust(5) + "H(x)".rjust(7) + "huff".rjust(7) + "fixed".rjust(7) + "saved".rjust(7))
for name, s in sets:
    k = len(set(s))
    fixed = math.ceil(math.log2(k)) if k > 1 else 1
    h, hb = entropy(s), huff_avg(s)
    print(f'{name:<13}{len(s):>5}{h:>7.2f}{hb:>7.2f}{fixed:>7.2f}{(1 - hb / fixed) * 100:>6.1f}%')
print('RLE bits/symbol (value byte + length byte, runs capped at 255)')
for name, s in sets:
    print(f'  {name:<13}rle={rle_avg(s):>6.2f}  huff={huff_avg(s):>6.2f}')
print('huffman tracks entropy on skewed data, near-lossless on 26 letters')
print('RLE crushes long runs but doubles the cost of plain text')
我特意把熵一起算出来打印,因为它给出了每组数据的理论下界。霍夫曼再聪明也压不到熵以下,所以"huff"和"H(x)"这两列之间的缝隙,才是我真正想看的东西。固定种子 42,四组数据一次生成,脚本单文件跑完。
真实运行结果
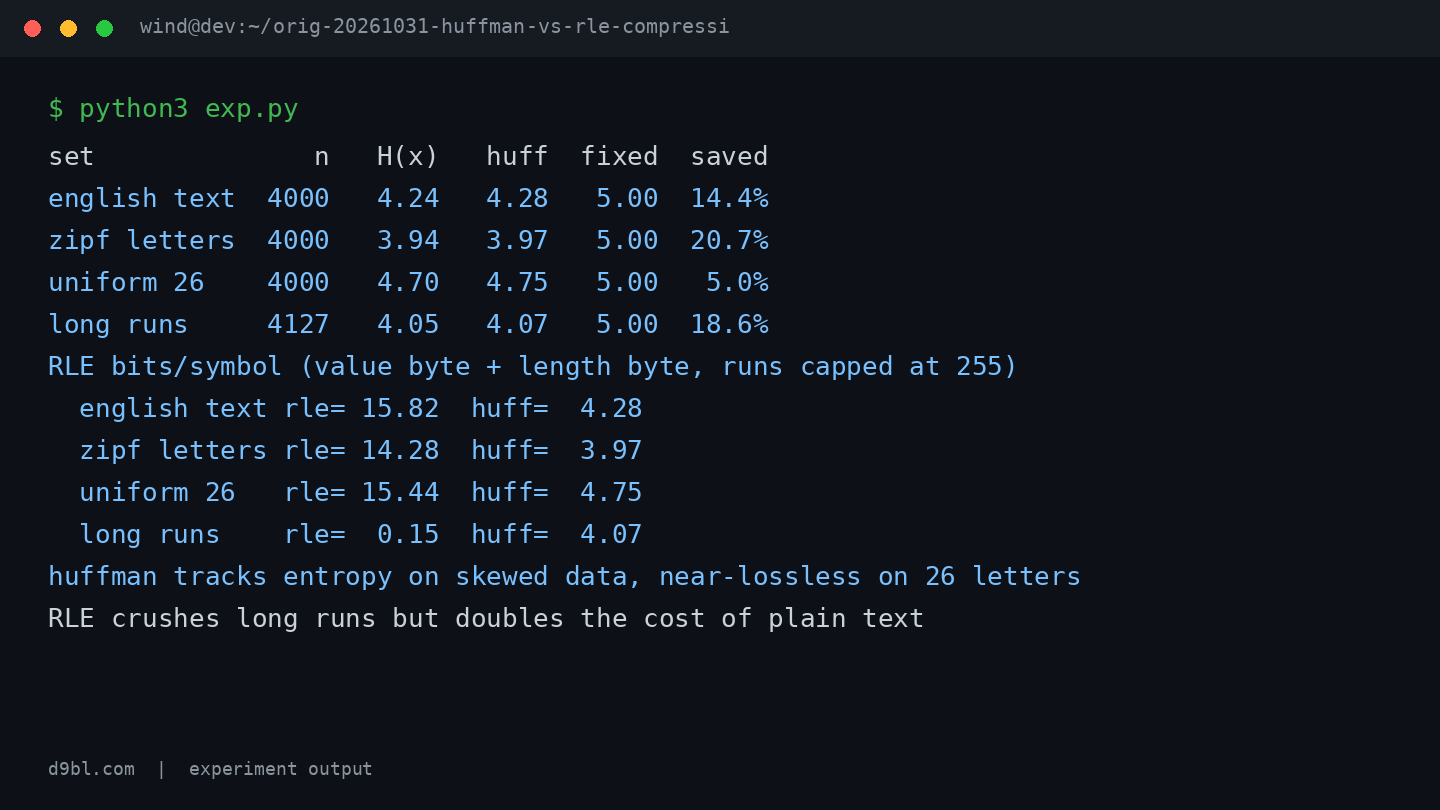
第一张表是霍夫曼相对定长编码的成绩。英文 4000 字符,熵 4.24,霍夫曼 4.28,相对 5.00 的定长省 14.4%。Zipf 字母那组最好看,熵 3.94,霍夫曼 3.97,省 20.7%。均匀 26 字母最惨,熵 4.70,霍夫曼 4.75,只省 5.0%。长重复串 4127 字符,熵 4.05,霍夫曼 4.07,省 18.6%。四组里霍夫曼最好的成绩是 20.7%,没有一组摸到 30%。
第二张表就难看了。RLE 在英文上是 15.82 bits/symbol,比原始 8 bit 的裸存还贵了将近一倍;Zipf 组 14.28;均匀组 15.44;只有长重复串掉到 0.15。同样是这套 RLE 代码,最好的 0.15 和最差的 15.82 之间差了一百倍出头。所谓"压缩率差出一个量级",说的就是这个跨度,而不是霍夫曼和 RLE 的差距。
把两张表叠起来看更有意思:霍夫曼在四组数据上的波动只有 4.07 到 4.75,不超过 0.7 个 bit;RLE 的波动是 0.15 到 15.82。前者像一个稳定但收益有限的投资者,后者像一个要么翻倍要么归零的赌徒。而我原来以为"哪个算法强"是个可以排序的问题,跑完才发现它根本排不了序,只能说哪对组合成立。
反直觉发现与局限
最反直觉的一点是:霍夫曼在均匀随机数据上也"省"了 5.0%。这个数字很容易被拿去做宣传,但它是假的。均匀 26 字母的熵是 4.70,定长编码要 5 bit,本来就有 0.30 bit 的结构性浪费;霍夫曼把平均码长做到 4.75,只是把这份浪费捡回来一部分,它没有从数据里创造任何新压缩。换句话说,这里的功劳属于定长基线,不属于霍夫曼。如果基线换成算术编码,这 5.0% 会当场消失。
第二个反直觉的是 RLE 在英文上的 15.82。我一开始以为这是"RLE 不适合文本"的铁证,盯着 rle_avg 看了几分钟才发现一半是我自己的锅:我给每个 run 固定两个字节,而英文的平均 run 长度接近 1。4000 字符跑出 3955 段左右,自然就是每字符 16 bit。真实实现不会这么笨,它会在 run 长度大于 2 或 3 时才启用转义,或者把长度塞进值的空余位里。所以这个数字测的是"天真 RLE"的上限,不是 RLE 这个思路的上限。
局限还有几处我必须列清楚。样本只有 4000 符号,短到装不下字典头、块头和容器开销,真实文件里这些开销会把 14.4% 这种收益再削掉一截。huff_avg 只算平均码长,我没有真的建树、导出码表、再做一次编码解码来验证往返一致。长重复串那组的 n 是 4127 而不是 4000,因为每段长度是 50 到 150 的随机数,我控制不住。四组全是人造数据,没有一组来自真实文件。这些都不影响趋势判断,但足以让"省多少"的绝对值往后缩。
我的结论
如果你要在自己的数据上用霍夫曼,先做一件事:算熵,再除以 log2(符号集大小)。这个比值就是你的收益上限。我的四组数据里,英文是 4.24/5.00,Zipf 是 3.94/5.00,均匀是 4.70/5.00;比值超过 0.9 的那组,霍夫曼只给了 5.0%。以后再看到"霍夫曼省三成"这种话,把它换算成这个比值,就知道它描述的是哪种分布,而不是这个算法。
RLE 的判断更简单:先把 run 长度的分布打出来,平均 run 小于 3 就直接放弃,别写代码。平均 run 上到几十,它能给你 0.15 bits/symbol 这种霍夫曼做梦都拿不到的数字。真正该做的不是二选一,而是先分流:检测到长 run 走 RLE 通道,其余走熵编码通道,两套结果拼一起再落盘。我下一步想把这四组数据喂给 zstd 和 lz4,看通用压缩器在均匀随机那组上会不会也交出 5% 这种"看起来赢了其实没赢"的答卷。