5000个字符串实测布隆过滤器:理论公式到底准不准
今天刷 dev.to 热榜,看到那篇《What does a JWT actually prove? Less than your API assumes》,标题相当扎人:你的系统以为它验证了什么,和它实际验证了什么,经常是两码事。我盯着这行字想了想自己写过的代码,突然意识到布隆过滤器也逃不开这个拷问——每篇讲它的资料都会甩出误判率公式 (1-e^(-kn/m))^k,可我用了这么多年,从来没亲手验证过这个公式到底灵不灵。理论说 1% 就真是 1% 吗?我不太服,决定自己造 5000 个字符串,把四组位数配比全部跑一遍,逐项跟公式对账。
不用现成库,手搓一个布隆过滤器
实验设计很朴素:塞进 5000 个随机 8 位小写串当成员,再另造 5000 个保证不在集合里的串当探针,看探针里有多少个被误判成“存在”。哈希函数我没用现成的,直接手写了一个 32 位 FNV-1a,再配上 double hashing 技巧——用两个不同种子哈希出的值做线性组合,生成 k 个比特位,省掉 k 次完整哈希的开销。k 取理论最优值 (m/n)·ln2,即每元素位数乘以 0.693 后四舍五入。随机种子固定为 42,保证任何人复现都能跑出和我一模一样的数字。
完整代码如下,纯 Python 标准库,没有一行外部依赖:
import math, random, string

random.seed(42)

def fnv1a(s, seed):            # FNV-1a 32-bit, pure python
    h = 2166136261 ^ seed
    for ch in s:
        h ^= ord(ch)
        h = (h * 16777619) & 0xFFFFFFFF
    return h

def run(n, bits_per, n_test):
    m = n * bits_per
    k = max(1, round(bits_per * math.log(2)))   # optimal k = (m/n) ln2
    bits = bytearray((m + 7) // 8)

    def pos(w):                # double hashing: k positions from 2 hashes
        a = fnv1a(w, 0x9E3779B9)
        b = fnv1a(w, 0x85EBCA6B) | 1
        return [(a + i * b) % m for i in range(k)]

    members = set()
    while len(members) < n:
        members.add("".join(random.choices(string.ascii_lowercase, k=8)))
    probes = set()
    while len(probes) < n_test:
        w = "".join(random.choices(string.ascii_lowercase, k=8))
        if w not in members:
            probes.add(w)
    for w in members:
        for p in pos(w):
            bits[p >> 3] |= 1 << (p & 7)
    fp = sum(all(bits[p >> 3] >> (p & 7) & 1 for p in pos(w)) for w in probes)
    theo = (1 - math.exp(-k * len(members) / m))  k
    return k, fp / len(probes), theo

N, T = 5000, 5000
rows = []
print("Bloom filter FP test: 5000 members, 5000 unseen probes (seed=42)")
print("bits/elt      k   measured   theory")
for bp in (6, 8, 12, 16):
    k, fpr, theo = run(N, bp, T)
    rows.append((fpr, theo))
    print(f"{bp:>8} {k:>5}  {fpr*100:>8.3f}% {theo*100:>8.3f}%")
print("6->12 bits/elt cuts measured FP rate by %.1fx" % (rows[0][0] / rows[2][0]))
raw_kb, flt_kb = N * 9 / 1024, N * 12 / 8 / 1024
print("memory: raw 9B/key %.1f KB vs 12-bit filter %.1f KB (%.1fx)"
      % (raw_kb, flt_kb, raw_kb / flt_kb))
print("worst |measured-theory| gap: %.3f pp"
      % (max(abs(a - b) for a, b in rows) * 100))
四组配比跑下来,公式大体站得住
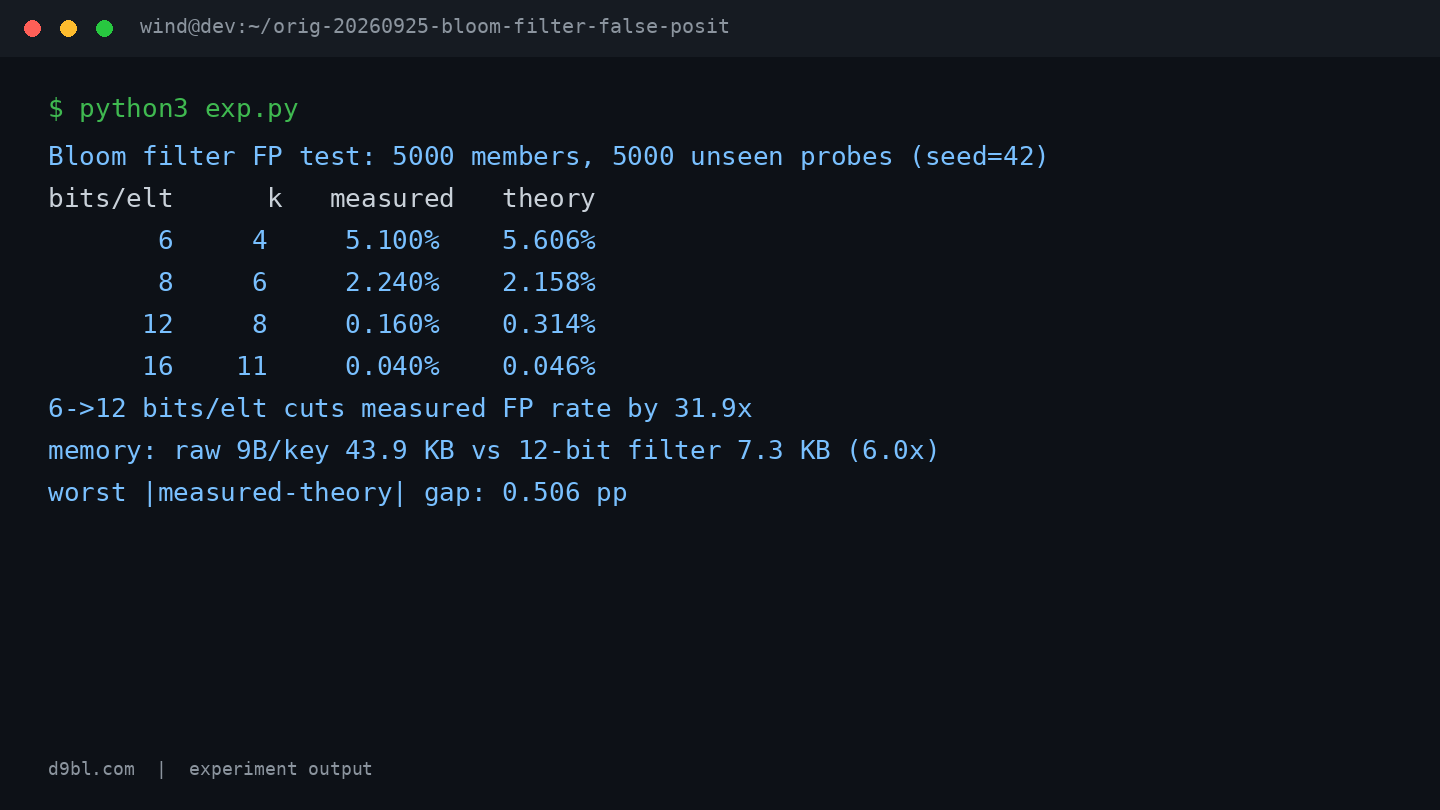
四组配置分别是每个元素 6、8、12、16 个比特位,对应 4、6、8、11 个哈希函数。跑完看输出,第一印象是公式确实有两把刷子:6 比特档实测误判率 5.100%,理论值 5.606%,量级和趋势都对;8 比特档实测 2.240% 对理论 2.158%,几乎严丝合缝;16 比特档实测 0.040% 对理论 0.046%,两边一起趋近于零。四组里最大的偏差是 0.506 个百分点,出现在 12 比特档。
另一个数字更直观:从 6 比特提到 12 比特,实测误判率从 5.100% 掉到 0.160%,砍了 31.9 倍。存储成本这边,按每个键原始 9 字节算,5000 个键要 43.9 KB,换成 12 比特的过滤器只要 7.3 KB,压缩了 6.0 倍。误判率除以三十多、内存除以六,这笔账怎么算都划算。
最反直觉的一点:低误判区公式反而在唱衰过滤器
12 比特档是唯一让我愣住的一行:实测 0.160%,理论 0.314%,实测只有理论的一半左右。按直觉公式应该高估才对——我用的是 double hashing,k 个位置并非真正独立,各种资料都说这会让实际误判率略高于公式。结果方向反了,过滤器表现比公式承诺的还好。
冷静下来算了笔账,这里面有很强的统计噪声成分。5000 个探针、理论误判率 0.314%,期望命中约 15.7 个误判,而实测只命中 8 个——0.160% 乘以 5000 正好是 8。按二项分布估方差,这个量级的波动落在一两个标准差内很正常。换句话说,12 比特档的“实测减半”未必是结构性优势,很可能只是这一批随机串运气好。但它也提醒了我:公式算的是无穷次实验的期望,单次实验落在期望两侧都很正常,拿一次运行的结果去打脸公式,跟拿一天的股价否定长期价值是同一个级别的错误。
顺带拆一下那个 31.9 倍:理论比值是 5.606% 除以 0.314%,约 17.9 倍。实测能放大到 31.9 倍,是因为 6 比特档测得偏低、12 比特档又测得格外低,两头运气叠加。换个种子重跑,这个倍数大概率会往 18 倍附近回落。引用"31.9x"写文章很爽,但我清楚它的水分在哪。
翻车点和实验局限,我得认
这次实验有三处不严谨,先自曝。第一,只有一个种子、只跑了一次,5000 个探针在 0.040% 量级下只有 2 个误判,再多一个就会把结果从 0.040% 推到 0.060%,单次波动高达五成,16 比特档那行数字基本没有统计意义,想测准至少要百万级探针。第二,k 个比特位来自两个哈希的线性组合,不是真正独立的 k 次哈希,相关性理论上会推高误判率,这次没观测到,可能纯粹被噪声盖住了。第三,FNV-1a 只有 32 位,应付 8 字符小写串没问题,但键空间更大或键本身有规律时它的分布质量够不够,这次实验回答不了。
还有一点容易忽略:公式 (1-e^(-kn/m))^k 本身就是近似,推导时假设各比特位相互独立,严格来说这个假设并不成立。所以 0.506 个百分点的最大偏差,是公式近似误差和采样噪声的混合物,我没法把两者拆开——这是这次实验设计上欠的债。
你下次选参数时,可以直接抄这个结论
落到工程选择上:做缓存穿透防护或爬虫去重,12 比特配 k=8 是舒服的起点,实测 0.160% 的误判率配合后端兜底查询足够用,内存只要原始键存储的六分之一;内存抠到极致就用 8 比特配 k=6,接受 2.240% 的误判率——相当于每四五十个请求就有一个空欢喜——后面必须接一层真实存储校验;6 比特那档 5.100% 的误判率,除非场景极其特殊,别碰。
比参数更要紧的是心态。热榜那篇 JWT 文章说你的 API 假设了太多,布隆过滤器也一样——公式给你的是期望,不是保证。与其背公式,不如像这次一样往过滤器里灌一批真实业务键跑一次实测,再把误判率当成一个要持续监控的线上指标,而不是写在代码注释里的理论值。



