在对话请求里附上一张照片,模型还没写出回答的第一个字,这次调用的 token 数量就可能暴涨上千。这个涨幅不只是计费问题——在语言模型开始琢磨你的问题之前,视觉编码器就先干了一轮实打实的活:把图像切成图块,再把每个图块转换成一个 token。本文将带你弄清这笔开销究竟从何而来、如何针对自己的业务负载算出具体数字,以及在它变成账单上的“意外支出”之前该如何应对。
核心要点
- 发给视觉语言模型的每一张图片,都会在模型作答前被转换成数百甚至数千个额外 token。这笔开销是在文本提示词成本之外另算的。
- 决定账单金额的因素有四个:模型规模、每次请求的图片分辨率与数量、回答的长短,以及请求在 GPU 上的批处理效率。
- 流量处于中低水平时,无服务器推理(按 token 计费)通常更划算;一旦请求量达到高位且保持稳定,专用推理(按 GPU 小时计费)反而可能更省钱。
- 别去猜一张图要消耗多少 token。直接从 API 响应的 usage 字段里取出真实数值,再据此计算实际成本。
- 一些小改动就能降本而不牺牲输出质量:发送前先压缩图片、对请求做批处理、效果够用时就换更小的模型,对时效要求不高的任务则交给批量推理。
- 在上线涉及图片的功能之前,就该测算好每次请求的成本,而不是等到第一张载有真实流量的账单寄来才行动。
几个术语的简明解释
- 多模态推理。运行一个能同时接收多种类型输入(比如文本加图片)并生成回答的模型。“推理”仅指模型在作答,而不是在学习。
- 视觉语言模型(VLM)。能够同时“看”图片并“读”文本,进而对两者综合推理的模型。代表有 LLaVA、Qwen-VL 和 Nemotron Nano VL。
- 视觉编码器。模型中负责把图片转换成语言模型可理解数值的组件。它先把图像切成小图块,再把每个图块转换成一个 token。
- Token。模型读取和输出的基本单位。文本会被切分成 token(大致相当于一个词或词的一部分)。图片同样会被切分成 token——视觉编码器产出的每个图块对应一个。
- 输入token与输出token。输入token是你发给模型的一切内容:提示词,外加所有图片。输出token则是模型返回的内容。输出token的单价几乎总是高于输入token。
- KV缓存。英文全称是“key-value cache”(键值缓存)。它是模型针对当前请求的短期记忆。模型生成回答期间,每个token(包括图片token)都会占用这块缓存的空间。token越多,占用的内存就越多。
- GPU小时。一块GPU运行一小时。专用推理和自托管推理都按这种方式计费。GPU忙也好、闲也好,成本都一样,所以只有让它一直有事可做,单个请求的成本才能降下来。
- 批处理。把多个请求合并成一批,一次性送入GPU处理,而不是一个一个来。这样GPU利用率更高,单个请求的成本也随之降低。
- 量化。用更小的数值格式来存储和运行模型(比如用FP8或INT4替代FP16)。这能减少内存占用,往往还能加快推理速度,代价是精度略有下降,但通常可以接受。
- 无服务器推理。按处理的token数量付费。无需自己管理服务器,没有任务运行时也不产生任何费用。
- 专用推理。按GPU小时为一整块专属GPU付费,不管它是否正在处理请求。
为什么图片的成本比看上去的要高
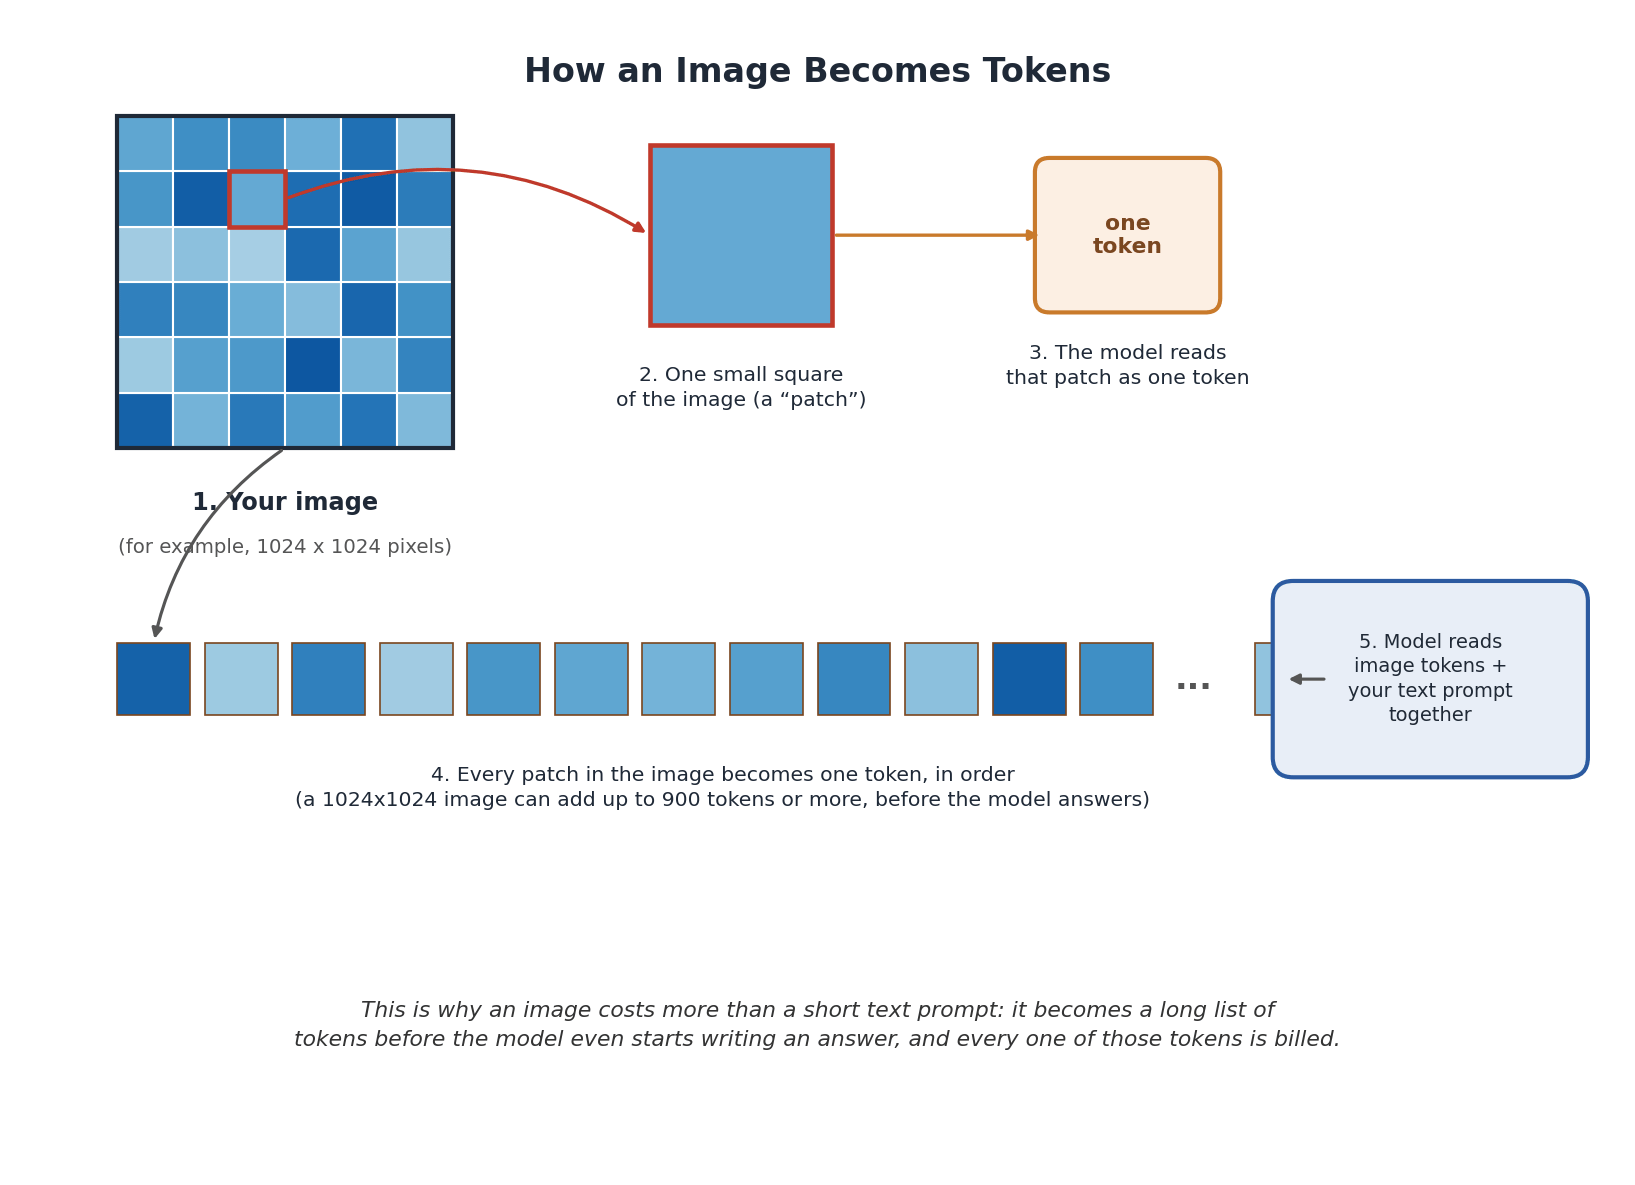
一句“总结一下”的文字提示,只有寥寥几个token。图片可就远不止了。
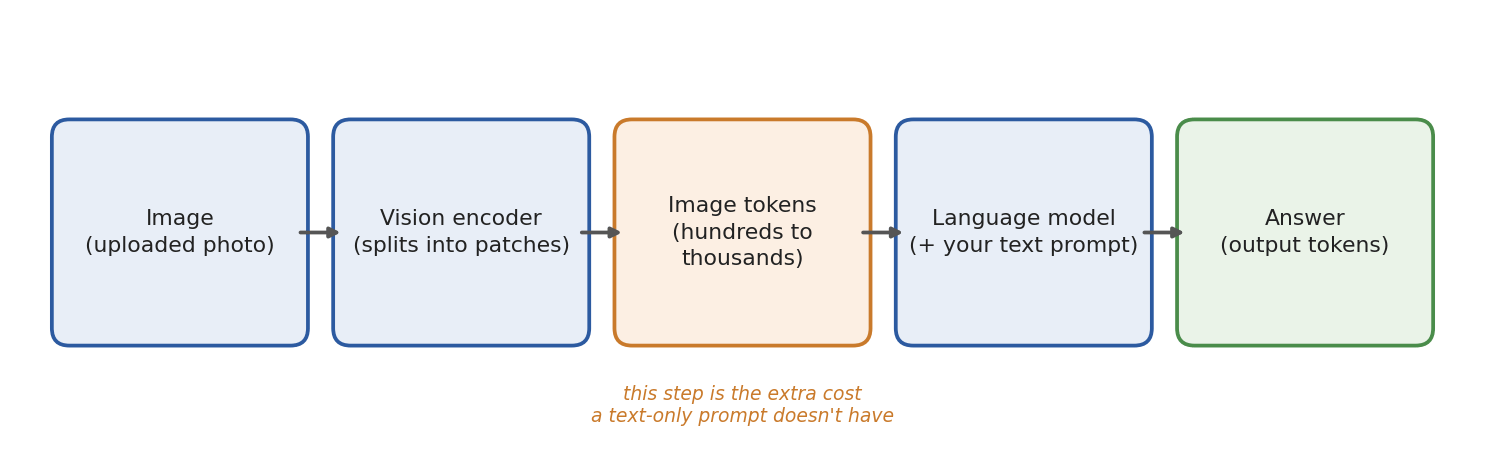
LLaVA、Qwen-VL以及NVIDIA的Nemotron Nano VL这类视觉语言模型(VLM),基本原理都如出一辙:视觉编码器先把图片切分成网格状的patch,每个patch再转换成一个或多个token,连同文字提示一起送入语言模型。具体的token数量取决于所用模型和图片尺寸,可千万别凭感觉去猜。
包括 DigitalOcean 在内,大多数推理 API 都会在每次响应中附带一个用量对象。在 DigitalOcean 的 Chat Completions API 上,这个对象长这样:{“prompt_tokens”: 43, “completion_tokens”: 8, “total_tokens”: 51},具体可参阅 Chat Completions API 文档。这些数字精确记录了本次调用消耗的输入和输出 token 数量,而这正是你实际计费的依据。无论用哪个 SDK,你都可以直接从响应对象里读到这些值;本文后面“调用托管视觉模型”一节会给出具体的代码行。
这对成本有三方面的直接影响:
- 每张图片都会推高输入 token 数量,而且幅度常常超过一整段文字。
- 这些图片 token 在整个生成期间都驻留在 KV 缓存中,因此它们不只是增加 token 计数费用,还会加重 GPU 的内存压力。
- 视觉编码器本身也需要运行,这在语言模型前向传播之外,又增加了额外的延迟和计算开销。
如果你只用不含图片的简短提示词做测试,上述成本完全不会显现。可一旦真实用户开始上传照片、截图和 PDF,问题很快就会浮出水面。
真正决定账单的是什么
以下四个因素决定了每次请求的费用:
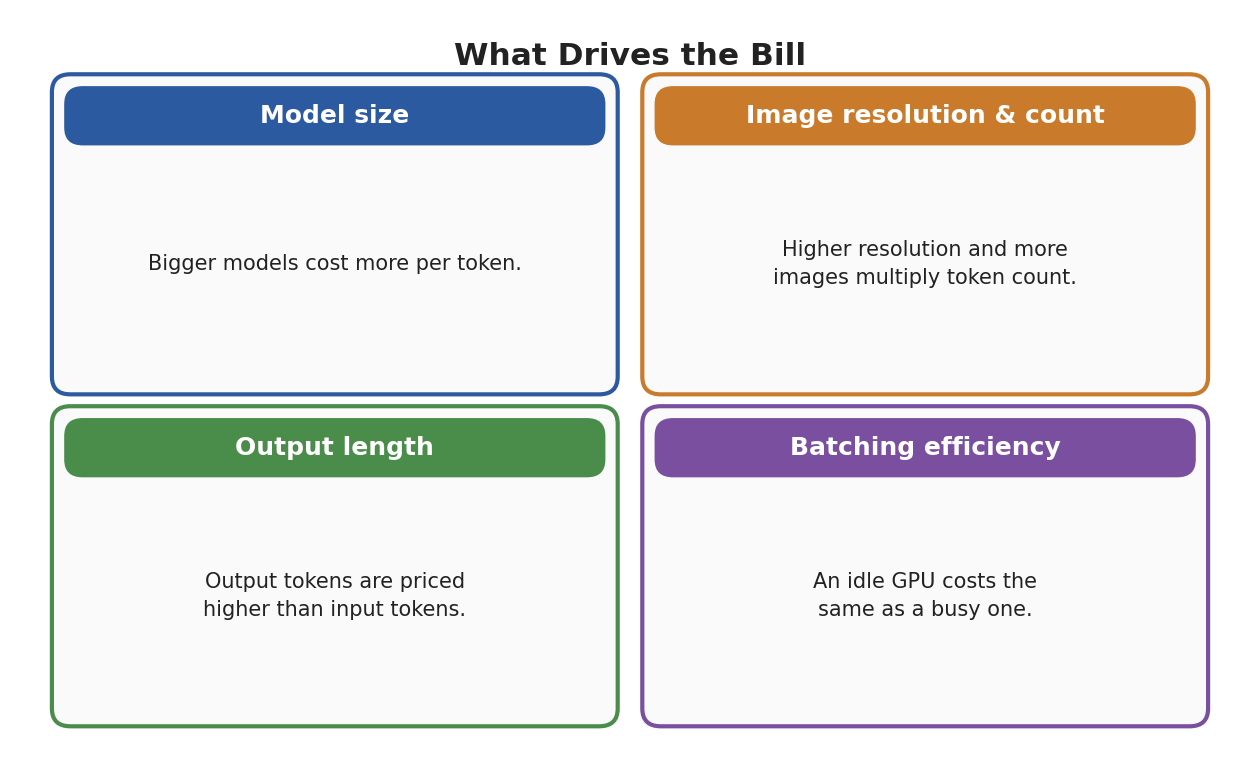
- 模型规模。120 亿参数的视觉语言模型,所需显存比 700 亿参数的更少,运行也更快。模型越大,单个 token 的价格就越高,没有例外。
- 图片分辨率和数量。分辨率越高、单次请求带的图片越多,token 数量就成倍增长。一条带四张 2K 截图的请求,其输入 token 可能比大多数人整段文字聊天记录还要多。
- 输出长度。在 DigitalOcean Inference 定价页上,几乎所有模型的输出 token 单价都高于输入 token,平台上托管的视觉语言模型也不例外。先“展示推理过程”再给出答案的模型,即使处理同一张图片,花费也更高。
- 批处理效率。GPU 的成本按时间计费,而不是按请求次数。一台干等下一个请求的 GPU,烧钱速度和满负荷运转时别无二致。谁能把你的模型服务得当,谁就能把批次填满;做不到的,GPU 时数就白白空转浪费了。
算一笔实际请求的账
假设你正在运行一个 12B 的视觉语言模型,发送一张图片和一段简短的提示词,得到一个 200 token 的回答。图片本身要消耗多少 token?这因模型而异,也不该单凭像素尺寸去估计——与其凭空猜测,不如先做一次测试调用,再从 API 响应的 usage 字段里取出真实数字。在本例中,假设那次测试调用显示图片耗用 900 token,提示词耗用 50 token:这些数字只是为了演示计算过程,并不代表任何具体模型的真实情况。
def calculate_request_cost(image_tokens, prompt_tokens, output_tokens,
                            input_price_per_million, output_price_per_million):
    input_tokens = image_tokens + prompt_tokens
    input_cost = (input_tokens / 1_000_000) * input_price_per_million
    output_cost = (output_tokens / 1_000_000) * output_price_per_million
    return input_cost + output_cost, input_tokens

cost, total_input = calculate_request_cost(
    image_tokens=900,     # from your API response's usage field, not estimated
    prompt_tokens=50,
    output_tokens=200,
    input_price_per_million=0.20,   # DO-hosted Nemotron Nano 12B VL input rate
    output_price_per_million=0.60,  # same model, output rate
)

print("total input tokens:", total_input)
print("cost per request: $%.6f" % cost)
print("cost per 100,000 requests: $%.2f" % (cost * 100_000))
$0.20 / $0.60 的每百万 token 费率,是 DigitalOcean 为 NVIDIA Nemotron Nano 12B VL 官方公布的 serverless 价格,来自Inference 定价页面(最后核对于 2026 年 9 月)。运行脚本得到的结果如下:
- 总输入 token 数:950
- 单次请求成本:$0.000310
- 每 10 万次请求的成本:$31.00
单看每次请求,这个价格确实便宜。可一旦乘上每月数百万次的请求量,再加上更大的图片、多图提示,或者换成更大的模型,它就没那么便宜了。确切的放大倍数取决于你的真实数据——这也正是要从 API 响应中读取这些数字、而不是凭空假设的原因。
这个练习的意义不在算出的具体数字,而在于养成习惯:上线之前就估算好单次请求的成本,而不是等账单寄到再算。
真正把模型跑起来的三种方式,以及各自的成本
VLM 并没有一个统一的“成本”——花多少钱取决于你怎么部署。DigitalOcean 的Inference 定价文档给出了三条路径,分别适合产品的不同阶段:
Serverless 推理。按 token 计费,没有闲置 GPU 的开销。DigitalOcean 托管着 NVIDIA Nemotron Nano 12B VL 这类模型,输入每百万 token $0.20、输出每百万 token $0.60。对大多数团队来说,这是最合适的起点:无需容量规划,没有白白烧掉的 GPU 时长,处理多少、付多少。等调用量大到、也稳定到专用 GPU 摊到每个 token 上更划算时,再考虑切换。
专用推理。按 GPU 小时计费,而不是按 token,机器开着多久,GPU 就归你用多久。在 DigitalOcean 上,价格从 AMD MI300X 的每小时 $2.59 到 NVIDIA B300 的每小时 $10.39 不等。单卡 MI300X 和 H100 的费率与 DigitalOcean 同规格硬件的按需GPU Droplets 定价一致,自 2026 年 8 月 1 日起生效。多卡节点单独定价,并不总按单卡费率线性叠加:一台 8×H100 节点总价为每小时 $30.32,折合每张卡约 $3.79,反而低于单卡 $4.41/小时的费率。当请求量足够大、也足够稳定,GPU 小时成本除以实际吞吐量后低于 serverless 的按 token 费率时,选它就划算了。
在 GPU Droplet 上自行托管。你可以在 GPU Droplet 上运行自己的推理服务器(vLLM 是常见选择),底层算力按秒计费,GPU 定价与专用推理方案一致。批处理、量化、模型选择都由你全权掌控,代价则是需要自己维护整套服务栈。DigitalOcean 的推理优化镜像已预装 vLLM,只需一条命令即可启动模型服务:
vllm serve Qwen/Qwen3-VL-8B-Instruct --port 8000
这三种方案的取舍逻辑很简单:Serverless 用控制权换来零闲置成本,专用实例和自托管则用固定的按小时计费换来完全的控制权,而两者的成本交叉点取决于你的实际请求量,不是拍脑袋猜出来的。
在 DigitalOcean 上算一笔真实的成本账
数字放到规模化场景里,就和单次请求时大不一样了。下面用一个具体案例来算笔账,价格取自 DigitalOcean 官方公布的 Inference 定价页和GPU Droplets 定价页(两处价格均核实于 2026 年 9 月)。token 数量沿用上文那组示例数据(每张图 900 个图像 token、50 个提示词 token、200 个输出 token,每次请求共 950 个输入 token):正式做预算前,记得换成你自己实测的数据。
场景设定:一个视觉 QA 功能,每月 50 万次请求。
方案一:用 Serverless 推理来跑,选用 DigitalOcean 托管的 Nemotron Nano 12B VL,输入 token 每百万 $0.20、输出 token 每百万 $0.60:
- 每月输入 token 数:475,000,000
- 每月输出 token 数:100,000,000
- 每月成本:$155.00
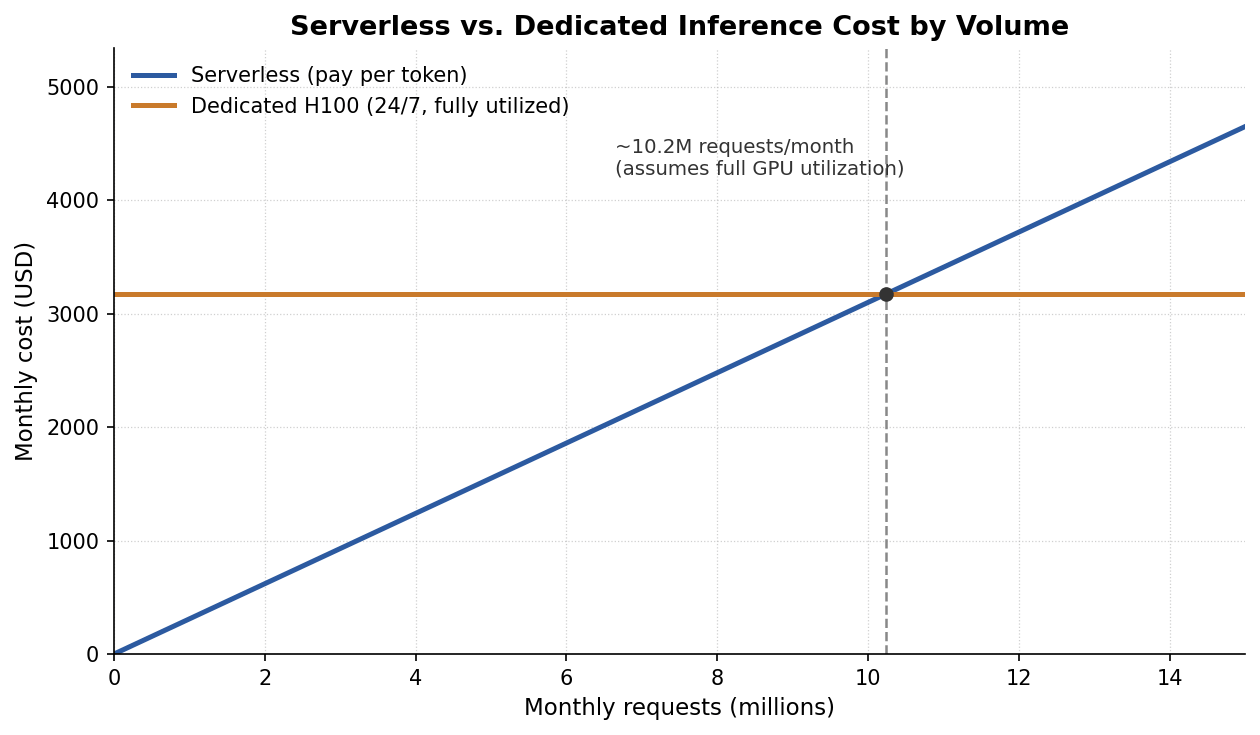
方案二:换成专用 H100 来跑,按 DigitalOcean 的按需价 $4.41/小时计费,而且不管 GPU 忙不忙,都照常收费:
- 24/7 全天候运行,每月成本:$3,175.20
想知道这块 GPU 的时间究竟用在了哪里,你得先弄清它的实际吞吐量:在你真实的批处理配置下,它每秒能处理多少个 token。这个数字不能靠假设,而要对你自己的模型和推理服务配置做基准测试才能得出,因为它取决于模型规模、批大小(batch size)和序列长度。没有实测验证过的吞吐量,你就说不清在每月 50 万次请求的负载下,$3,175.20 的月度成本里到底有多大比例变成了 GPU 的闲置时间——只能确定,其中确实有一部分是。
在这个请求量级下,Serverless 显然是更合理的起点:月成本更低,而且既不用规划容量,也不会有资源闲置。随着请求量增长,两种方案的成本会逐渐趋近。按同样的单次请求费用计算,月请求量一旦跨过约 1020 万次(即用 $3,175.20 除以上文 $0.00031 的单次请求成本),专用 H100 就会比 Serverless 更划算——前提是 GPU 全程保持满负荷运行。实际操作中,建议先对自己的吞吐量和利用率做基准测试,再做决定。如果达不到满负荷,真实的盈亏平衡点会高于 1020 万次。
这是大多数团队真正需要面对的决策,而不是假想中的选择题:估算自己的月请求量,实测真实的吞吐量,然后根据产品今天的实际情况来选择,而不是寄希望于一年后它可能达到的规模。从 Serverless 起步,等流量和成本的历史数据足以支撑时再切换到专用 GPU,这样做完全没问题,而且往往更明智。
调用托管视觉模型
下面借助 DigitalOcean 的 OpenAI 兼容端点,看看一次真实的 Serverless 调用是什么样子:
import base64
from openai import OpenAI

client = OpenAI(
    base_url="https://inference.do-ai.run/v1",
    api_key="YOUR_DO_API_KEY",
)

with open("screenshot.png", "rb") as f:
    image_b64 = base64.b64encode(f.read()).decode()

response = client.chat.completions.create(
    model="nvidia-nemotron-nano-12b-vl",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "What error is shown in this screenshot?"},
                {
                    "type": "image_url",
                    "image_url": {"url": f"data:image/png;base64,{image_b64}"},
                },
            ],
        }
    ],
)

usage = response.usage
print("input tokens:", usage.prompt_tokens)
print("output tokens:", usage.completion_tokens)
每次调用时读取并记录 response.usage,是成本控制中最有用的一个习惯。无法度量,就无法管理——而且一旦真实用户的图片开始流入,单次请求消耗的 token 数波动之大,往往超出大多数团队的预期。
降成本,不降质量
搞清楚成本从何而来之后,下面几处改动能带来立竿见影的效果:
- 发送前先压缩图片。大多数 VLM 回答问题并不需要 4K 输入。把图片缩小到模型的有效分辨率(通常为 1024px 或更低),可以大幅削减图像 token 数量,而精度损失微乎其微。
- 能合并的请求就批量处理。如果你的业务允许几百毫秒的缓冲,把多个请求合并到同一次 GPU 前向计算中,可以提升吞吐量并降低单次请求成本。这正是 vLLM 这类推理引擎自动替你完成的工作。
- 对模型做量化。用 FP8 或 INT4 代替 FP16 运行模型,可以降低内存占用,往往还能在同一块 GPU 上提高吞吐量,代价是精度略有下降——通常可以接受。DigitalOcean 面向推理优化的镜像已为受支持的模型内置了 FP8 处理。
- 缓存重复内容。如果同一张图片或文档会在对话的多个轮次中被引用,就不要每次都重新编码。应用设计上应当做到:只要底层图片没有变化,就复用视觉编码器的输出。
- 选择满足精度要求的最小模型。一个能胜任任务的 12B VLM,成本只有 70B 模型的零头。先从小模型测起,只有当精度确实不够时再升级。
- 非实时任务改用批量推理。如果你处理的是积压的图片,而不是响应用户的实时请求,那么受支持的模型使用批量推理时,价格最高可低至标准费率的五折。
结语
多模态推理之所以比文本推理更贵,是因为在模型真正开始干活之前,一张图片就已经转化成数百甚至数千个额外的 token。在本文前文的示例中,一张图片加上一段简短提示词共计 950 个输入 token,单次请求成本为 $0.00031。这个数字单看并不大,但按每月 50 万次请求计算,无服务器推理的费用将达到 $155;而同样的负载放到一台全天候运行的专用 H100 上,成本则是 $3,175.20,且与实际请求量多少无关。
这笔开销其实是可以预测的——只要你去实测。决定账单高低的有四个变量:模型大小、图片的分辨率与数量、输出长度,以及批处理效率。这四项没有哪项是玄学:只要从 API 响应的 usage 字段里取出真实数据,而不是凭感觉估算,就完全不必靠猜。Serverless 与专用方案的取舍也遵循同样的逻辑:请求量不大或中等时,Serverless 更划算;只有当每月请求量突破约 1020 万、且假设 GPU 满载运转的前提下,两条成本曲线才会交叉。低于这条线,一台专用 GPU 花掉的钱,大半都在为闲置时间买单。
被坑惨的,往往是那些上线前从没算过这笔账的团队。而毫发无损的团队,会把 token 统计当作开发过程中的一环:提前算清单次请求的成本,并随着实际请求量的变化重新权衡 Serverless 与专用方案的取舍,而不是等到账单寄来才临时补救。
参考资料
- DigitalOcean 推理服务定价——包含 Serverless 的 token 单价、专用推理的 GPU 小时单价,以及批量推理折扣。DigitalOcean 最后核验于 2026 年 9 月 16 日。
- DigitalOcean GPU Droplets 定价——按需、预留和竞价型 GPU 价格。2026 年 8 月 1 日起生效。
- DigitalOcean GPU Droplet 推荐配置——推理优化镜像与 vLLM 的相关细节。
- 如何在 DigitalOcean GPU Droplet 上部署 Qwen-3——GPU Droplet 上的 vLLM 部署实操指南。
- DigitalOcean Chat Completions API——文档说明了每次响应都会返回的
usage对象。
以上价格均核验于 2026 年 9 月,可能随时调整。编制预算前,请查看链接页面获取最新价格。文中示例所用的 token 数量是为演示计算过程而选取的示意数字,并非来自任何具体模型的实测;做预算之前,请从你自己 API 响应的 usage 字段中提取真实数据。



