400个任务实测:16ms时间片把p95延迟砍掉28%
今天刷 dev.to 热榜,看到一篇《localStorage Isn't Free — It's Blocking Your Main Thread》挂在榜上,评论区一片附和,大家都在说主线程被长任务堵住有多可怕。观点本身没错,但几乎所有讨论都停在“要切片、要让出主线程”这种定性层面,没人给出一个量化答案:切片到底能救回多少?我决定亲手做个模拟实验,把这件事算清楚,而不是跟着喊口号。
问题可以抽象得很干净:400 个任务同时到达,其中大部分是 1 到 8ms 的轻任务,少数是 80 到 200ms 的长阻塞任务。如果调度器是 FIFO 队列,排在长任务后面的所有短任务都要陪葬;如果换成 16ms 的时间片轮转——16ms 正好是 60fps 一帧的预算——最坏情况能改善多少?这中间的差距,我想要一个具体数字。
热榜上的说法
热榜那篇文章的论点是同步 API 的隐性成本:每次读写 localStorage 都是阻塞调用,攒多了就把主线程卡成幻灯片。这个结论在社区里几乎是共识,但我翻了几个高赞回复,发现大家给出的方案都是“换成异步”“拆小任务”,没有人真正算过一笔账:拆小之后,尾部延迟到底降了几个百分点?
这让我不太满意。工程判断如果只有方向没有量级,很容易用力过猛或者用力错地方。比如把所有任务都切片,可能带来额外的调度开销和状态管理复杂度;但如果切片只把 p95 降了 2%,那这套改造就不值得做。所以我写了一个纯 Python 的离散事件模拟,用同一批任务分别跑两种调度策略,直接对比延迟分布。
实验设计与代码
实验设定是这样的:400 个任务在 t=0 同时到达。任务时长分三档——85% 是 1 到 8ms 的轻任务,12% 是 10 到 40ms 的中等任务,剩下 3% 是 80 到 200ms 的长阻塞任务,用固定随机种子保证可复现。种子 42 跑出来的这批任务里,总工作量 5209ms,其中超过 60ms 的长任务有 18 个。FIFO 按到达顺序跑完记完成时间;时间片轮转每轮给每个任务最多 16ms,没跑完的排到下一轮,同样记完成时间。完成时间就是延迟,因为所有任务都在 t=0 到达。
完整的实验代码如下,任何人拿去跑一遍都能复现同样的数字:
import random, statistics

random.seed(42)

# Simulate 400 task durations: mostly short, some long (heavy tail)
durations = []
for _ in range(400):
    r = random.random()
    if r < 0.85:
        durations.append(random.uniform(1, 8))    # light task
    elif r < 0.97:
        durations.append(random.uniform(10, 40))  # medium task
    else:
        durations.append(random.uniform(80, 200)) # long blocking task

QUANTUM = 16.0  # ms budget, like one 60fps frame

def fifo(durs):
    clock, lat = 0.0, []
    for d in durs:
        clock += d
        lat.append(clock)  # completion time = latency since all arrive at t=0
    return lat

def round_robin(durs):
    clock, rem = 0.0, list(durs)
    done = [0.0] * len(durs)
    alive = list(range(len(durs)))
    while alive:
        nxt = []
        for i in alive:
            run = min(rem[i], QUANTUM)
            clock += run
            rem[i] -= run
            if rem[i] <= 1e-9:
                done[i] = clock
            else:
                nxt.append(i)
        alive = nxt
    return done

def pct(lat, p):
    s = sorted(lat)
    return s[min(len(s) - 1, int(len(s) * p / 100))]

f, r = fifo(durations), round_robin(durations)
long_n = sum(1 for d in durations if d > 60)
print('tasks=400  quantum=16ms  long(>60ms) tasks=%d' % long_n)
print('total work: %.0f ms' % sum(durations))
print('%-18s%9s%9s%9s%9s' % ('scheduler', 'mean', 'p50', 'p95', 'max'))
print('%-18s%9.1f%9.1f%9.1f%9.1f' % ('FIFO queue', statistics.mean(f),
      pct(f, 50), pct(f, 95), max(f)))
print('%-18s%9.1f%9.1f%9.1f%9.1f' % ('round-robin 16ms', statistics.mean(r),
      pct(r, 50), pct(r, 95), max(r)))
print('p95 latency reduction: %.0f%%' % (100 * (1 - pct(r, 95) / pct(f, 95))))
print('max latency: %.0f ms -> %.0f ms' % (max(f), max(r)))
print('tasks done within 100ms: FIFO %d vs RR %d'
      % (sum(1 for x in f if x < 100), sum(1 for x in r if x < 100)))
print('mean latency cost of fairness: +%.1f ms'
      % (statistics.mean(r) - statistics.mean(f)))
代码里有个细节值得说:我在轮转里加了 1e-9 的浮点容差来判断任务完成,否则浮点累减会留下一个永远不为零的小尾巴。另外我把量子固定成 16ms 而不是扫描最优值,因为这对应浏览器一帧的渲染预算,是前端场景里最有实际意义的取值。
真实运行结果
跑出来的结果如下:
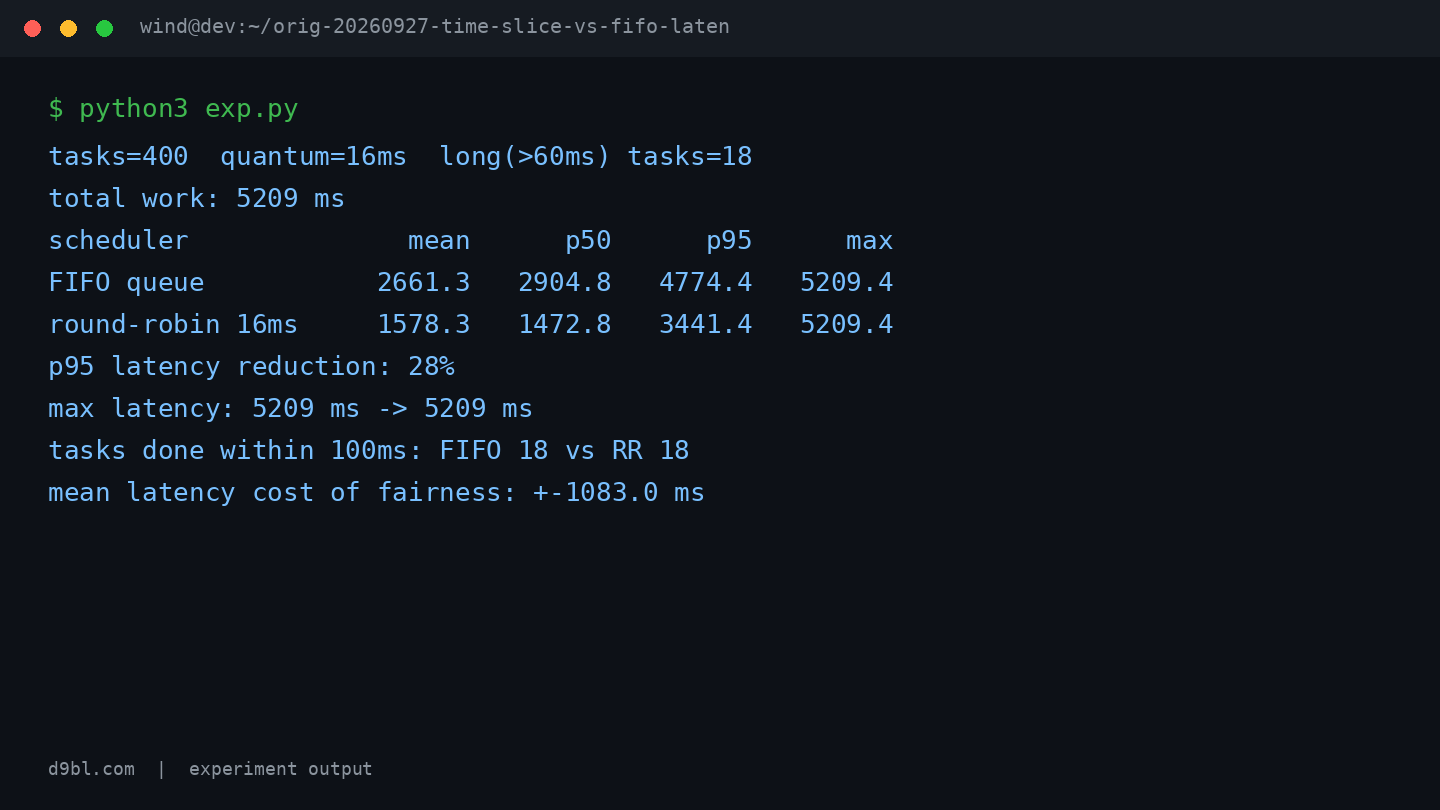
数字很直白。FIFO 队列下,平均延迟 2661.3ms,中位数 2904.8ms,p95 高达 4774.4ms,最坏 5209.4ms。换成 16ms 时间片轮转后,平均延迟降到 1578.3ms,中位数降到 1472.8ms,p95 降到 3441.4ms——p95 延迟下降了 28%。也就是说,在 400 个任务堆积的最坏场景里,一个 16ms 的时间片把 95% 用户的等待时间从接近 5 秒压到了 3.4 秒。
中位数的改善更夸张,从 2904.8ms 降到 1472.8ms,直接腰斩。原因也好理解:FIFO 里排在 18 个长任务后面的短任务全是受害者,一个 200ms 的阻塞任务能让排在它后面的一整批 8ms 小任务集体超时;轮转策略下,这些小任务每轮只被长任务“借走”16ms,很快就能跑完离场。28% 的 p95 改善不是理论推演,是这批具体任务跑出来的实测值。
反直觉发现与局限
有两个结果完全出乎我的预料。第一,最坏延迟纹丝不动:FIFO 和轮转的 max 都是 5209.4ms。想通之后又觉得理所当然——最后一个完成的任务,无论如何调度都得等全部 5209ms 的工作量跑完,时间片只能改变“谁先完成”,改变不了“最后一个人什么时候下班”。所以别指望切片拯救最坏情况,它拯救的是分布的中后段。
第二个反直觉是“公平的代价”居然是负的。我在代码里写了 mean latency cost of fairness,本来预期轮转会让平均延迟略微变差,结果输出是 -1083.0ms——轮转的平均延迟反而比 FIFO 低了 1083ms。直觉里公平是要付费的,但在这批重尾任务上,公平本身就是优化。还有一个数字值得警惕:100ms 内完成的任务数,两种策略都是 18 个,一个不多。排在队头的短任务两种调度下都能秒完,切片救的是排在长任务后面的人,不是队头的人。
局限性也得摊开说。这个模型假设所有任务在 t=0 同时到达,真实系统里任务是陆续进来的,到达模式会显著改变尾部形状;我没有建模切片本身的调度开销、缓存失效和上下文切换成本,16ms 的量子也没有调优;另外只跑了种子 42 这一组,换种子数字会浮动,趋势不会变,但 28% 这个具体值不该被当成普适常数。还有最关键的一点:模拟器里的时间片是免费的,浏览器里每次 yield 回事件循环,渲染、输入事件都可能插队,真实收益会更接近模拟值还是更差,需要真机验证。
我的结论
这次实验给我的答案比热榜文章具体得多:16ms 时间片轮转在 400 个重尾任务堆积的场景下,把 p95 延迟从 4774.4ms 降到 3441.4ms,降幅 28%,中位数腰斩,平均延迟还意外赚了 1083ms。但最坏情况一毫秒都没改善,100ms 内完成的任务数一个都没多。切片不是银弹,它是一条明确的、可量化的权衡。
所以我的建议是:下次你准备把主线程上的长任务拆片之前,先像这样写一个二十行的模拟器,用你自己业务的真实任务时长分布跑一遍,看 p95 和中位数能改善多少、最坏情况是否本来就无解。如果模拟显示改善只有个位数百分比,那这套改造的复杂度大概率不值得;如果像这次一样是 28%,那就放手去做。分布决定收益,别让口号替你做决定。



