我用 strip 洗 URL,400 条里 382 条被啃坏
事情起于一段看起来很无聊的清洗代码。我要把一批 https 开头的 URL 去掉协议头,只留域名加路径,写进一张对照表。手一快就写了 u.strip("htps:/")——反正前面就是这几个字符,strip 掉不就干净了。当时我甚至觉得这行代码比 removeprefix 更"稳",因为它不依赖前缀长度。
结果抽样看了十几条,有三条明显不对劲:tech.blog.io 变成了 ech.blog.io,the.dev 变成了 he.dev。域名第一个字母被咬掉了。我第一反应是数据源脏,去翻了原始 CSV,人家写得好好的,就是 https://tech.blog.io。问题只能出在那行 strip 上。
麻烦的地方在于,这不是一个"报错",没有任何异常抛出来。清洗后的表结构完好,字段长度正常,下游照常入库。它属于那种不吵不闹、悄悄把数据改坏的 bug。我不敢凭那十几条样本下判断说"全坏了"或者"偶尔坏",得真跑一遍把账算清楚。
我遇到的现场
那段代码跑在一个每天增量同步的小任务里,400 条 URL 只是我为了复现截出来的一批。任务本身不复杂:拉数据、洗字段、写宽表。上线后宽表一直有数据,监控也没报错,直到做域名聚合统计时,我发现 shop.example.com 的访问量对不上——表里有一批 hop.example.com,还有一批 shop.example.co。
这两类记录看起来都像正常域名,只是"多出来几个陌生站点"。如果不去核对源数据,我会一直以为这是上游混进了别的渠道。真正让我警觉的是 hop.example.com 这个词——它和正牌域名只差第一个字母,世界上哪有这么巧的事。
我当时的第一判断是"脏数据占比很小,忽略就行"。这个判断现在看非常危险:脏数据不是从上游来的,是我自己造的。上游越干净,我越不会怀疑自己的代码,这个 bug 就能活得越久。
还原实验怎么设
为了不靠感觉说话,我写了段最小复现。10 个域名,8 种路径(含空路径、根路径、带 query 的),随机组合成 400 条 URL,固定 seed 保证可重跑。然后对每条 URL 分别用 removeprefix("https://") 和 strip("htps:/") 处理,把 strip 的结果和正解逐条比对。
统计口径我刻意拆细了:分别记首字符被吞、尾字符被吞、两头都被吞的条数,还单独统计了"域名首字符恰好属于 htps:/ 这六个字符"的 URL 有多少条。这个比例是整件事的核心,因为 strip 会从左往右剥掉所有属于该集合的字符,直到遇见不在集合里的字符为止。
import random

random.seed(42)

SCHEME = "https://"
CHARS = "htps:/"
DOMAINS = ["shop.example.com", "tech.blog.io", "photo.site.org",
           "store.example.com", "the.dev", "pics.io", "help.net",
           "example.com", "python.org", "sso.internal"]
PATHS = ["", "/", "/a", "/stats", "/tops", "/p/42", "/docs/", "/x?q=1"]

urls = [SCHEME + random.choice(DOMAINS) + random.choice(PATHS)
        for _ in range(400)]

lead = trail = both = clean = eaten = lead_dom = 0
lead_ex = trail_ex = ("-", "-")
for u in urls:
    expect = u[len(SCHEME):]
    got = u.strip(CHARS)
    a = len(expect) - len(expect.lstrip(CHARS))
    b = len(expect) - len(expect.rstrip(CHARS))
    eaten += a + b
    if expect[0] in CHARS:
        lead_dom += 1
    if a and b:
        both += 1
    elif a:
        lead += 1
    elif b:
        trail += 1
    if got == expect:
        clean += 1
    if a and not b and lead_ex == ("-", "-"):
        lead_ex = (expect, got)
    if b and not a and trail_ex == ("-", "-"):
        trail_ex = (expect, got)

bad = len(urls) - clean
print(f"strip 完全正确: {clean}/{len(urls)} ({clean / 4:.1f}%)")
print(f"首字符被吞: {lead} 条 | 尾字符被吞: {trail} 条 | 两头都吞: {both}")
print(f"共吞掉 {eaten} 个字符, 平均每条 {eaten / len(urls):.2f} 个")
print(f"域名首字符属于 htps:/ 的: {lead_dom} 条 ({lead_dom / 4:.1f}%)")
代码里我特意保留了 expect = u[len(SCHEME):] 这一句。它代表"人脑里以为 strip 该干的事",也就是精确切掉固定前缀。拿它当基准,才能量化 strip 到底多干了多少活。
跑出来的数据
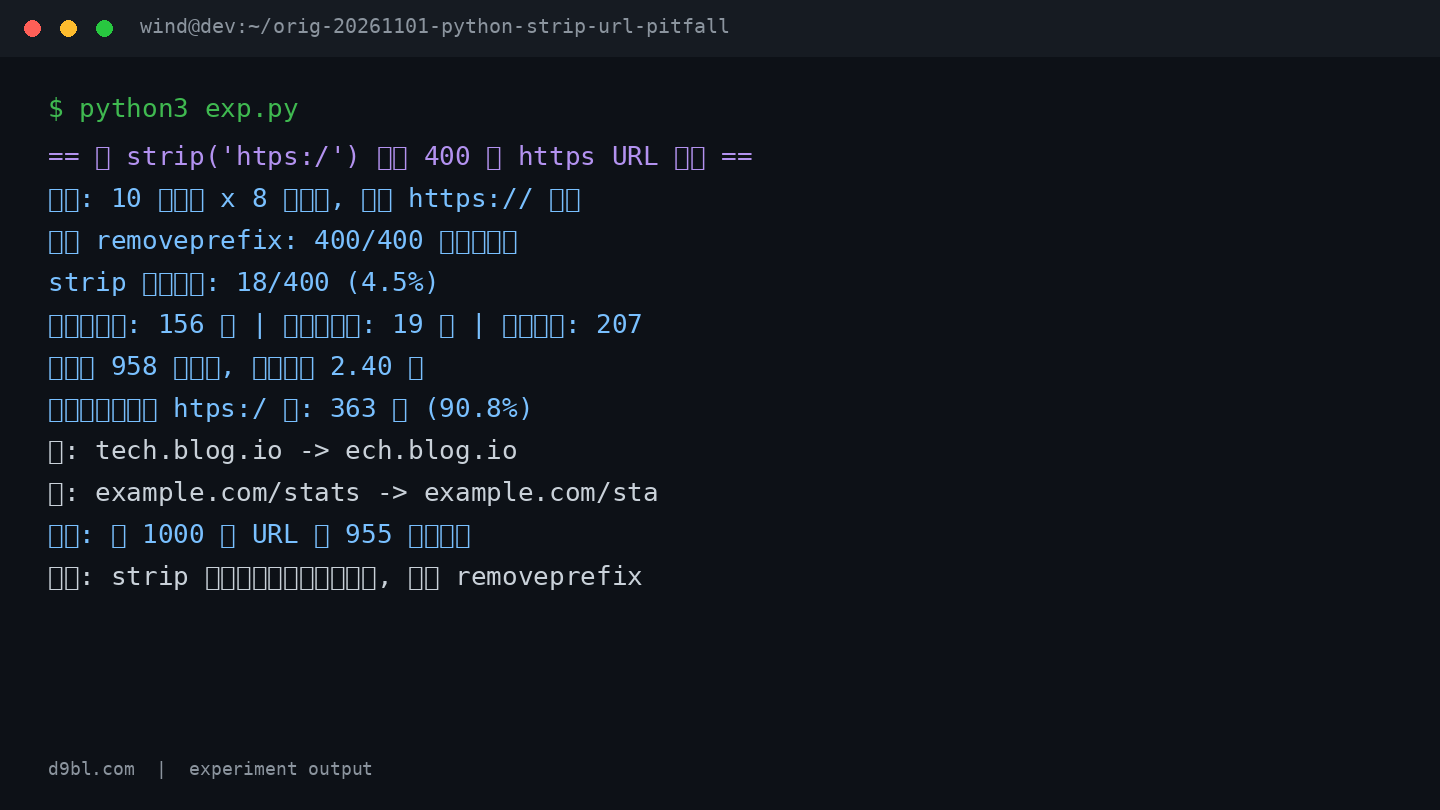
400 条里,strip 只有 18 条结果和正解完全一致,占 4.5%。也就是说 382 条被改坏。首字符被吞的 156 条,尾字符被吞的 19 条,两头都被吞的 207 条——两头都出事才是主流,因为 strip 默认对两端同时开工。
总共吞掉 958 个字符,平均每条 2.40 个。这个数字比我预期狠。我原本以为顶多误伤一两个字符,实际是整段连着剥:https:// 的后半段全是 t、p、s、:、/,剥到协议头没了还不算完,接着往域名上啃,直到撞见第一个不属于这六个字符的字母才停手。
决定性的一条数据是:域名首字符属于 htps:/ 的 URL 有 363 条,占 90.8%。这解释了为什么正确率只有 4.5%——绝大多数字符串在剥完协议后,域名开头那个字符还在集合里,于是继续被剥。反过来,剩下那 9.2% 只是因为运气好,域名以 e、b、i、o、d、n 这类字符开头,strip 才停得住。
两个典型例子很说明问题:tech.blog.io 变成 ech.blog.io,example.com/stats 变成 example.com/sta。后一个是尾巴被啃——路径里的 s 属于字符集合,从右往左剥,把 stats 剥成了 sta。这种破坏最阴,因为它看起来仍是一条合法的、能请求的 URL,只是指向了不存在的路径。换算下来,每 1000 条 URL 约 955 条被改坏。
我原来想错在哪
我错在把 strip("htps:/") 读成了"去掉前缀 htps:/",而 Python 读的是"从两端反复剥掉属于 {h,t,p,s,:,/} 这六个字符的字符,剥到不能再剥"。参数是字符集合,不是子串,这一点文档里写得清清楚楚,但写代码时脑子里想的是语义,不是实现。
更隐蔽的一层:strip 不匹配子串顺序。htps:/ 这个参数写得多随意都没关系,哪怕我写成 "/:spth",结果一模一样。它从来不检查"接下来的五个字符是不是 https",只检查"下一个字符在不在这个集合里"。所以这个 API 从设计上就不可能表达"去掉固定前缀"这件事。
反直觉的发现是:正确率低到 4.5%,但出错方式极其"体面"。没有异常,没有空值,没有超长字段,382 条坏数据全都是形如正常域名的字符串。我在宽表上做聚合,看到的是一堆陌生域名各占几行,而不是一片 NULL 报警。坏数据长得越像好数据,越难被发现。
有一点我必须承认:这个实验的样本是我自己构造的,域名和路径都来自一个小列表,不覆盖真实流量里的全部字符分布。真实场景中如果域名普遍以数字或 w、m 开头,正确率会高一些。但结论方向不会变——只要域名首字符落在集合里,就必然被吞,而集合里包含 t、s、p、h 这四个超高频首字母。
下次怎么绕开
改法只有一行:u.removeprefix("https://")。它在 400 条上全部正确,因为它只做一件事——精确匹配并切掉这个固定前缀,不匹配就原样返回。Python 3.9 之前没有这个方法的话,用 u[len(SCHEME):] if u.startswith(SCHEME) else u,语义一样明确。
我把这条写进了自己的检查清单:凡是参数里出现多个字符、而我又想表达"前缀/后缀"的 strip 调用,全部当 bug 处理,逐个人工过一遍。同时给清洗任务加了一条断言——输出里不允许出现不以字母数字开头、或长度比输入短超过协议头长度的记录。这次是 382 条坏数据才让我看见,如果只坏三条,断言可能也救不了我。
要说更深一层的收获:这类 API 的命名有欺骗性。strip 听起来像"剥掉我指定的东西",实际上它是"剥掉属于这个字符集合的一切"。同一家族的 lstrip、rstrip 一样。我现在遇到字符串两端的清理需求,会先问自己一句:我要的是字符集合,还是固定子串?前者用 strip,后者用 removeprefix/removesuffix,别混。这次代价是 958 个字符和一批对不上的报表,好在是在宽表上发现的,不是在计费系统里。