DeepSeek-V4.1-Flash 首先告诉我,它自己的文档其实是错的。
我之前读过的 模型卡 描述了一种可连续调节的推理工作量设置:取值范围是 1 到 100 的整数。DigitalOcean 在该模型的发布文章里也重复了这一说法。于是我发送了一个包含 reasoning_effort: 50 的请求,返回结果如下:
reasoning_effort must be one of [low high xhigh max] for this model.
四个字符串。没有 medium。没有关闭开关。没有整数。DigitalOcean 自己的模型参考文档明确列出了目录中其他模型的努力级别(GLM-5.3 获得 “low, high, and max”,Claude Sonnet 5 获得五级列表),但对 deepseek-v4.1-flash 的努力级别毫无说明。
这种差异很小,但它定了接下来两天的基调。此模型的头条功能确实存在且有趣。它们对您的账单产生的影响是另一个问题,答案不在定价页面上。
我进行了 844 次 API 调用才弄清楚。以下是我的发现。
Key findings: DeepSeek-V4.1-Flash prompt caching and reasoning effort on DigitalOcean
- 缓存以 64-token 块的形式工作,全部或无。 在 DigitalOcean Serverless Inference 上,每次 DeepSeek-V4.1-Flash 缓存命中恰好覆盖
floor(prompt_tokens / 64) × 64个 token。请求要么缓存到其最后一个完整的 64-token 块,要么根本不缓存。 - DeepSeek-V4.1-Flash 在 200K token 的热轮次中有 78.6% 命中缓存。为了与 GLM-5.3-Flash 持平,它大约需要 96% 的命中率,而 GLM-5.3-Flash 在 50K 和 200K token 的热轮次中均实现了 100% 命中。
- 在 DeepSeek-V4.1-Flash 上,15 轮、200K token 的代理会话花费为 0.2588 美元,是 GLM-5.3-Flash 的 0.1167 美元的 2.2 倍,尽管 V4.1-Flash 在目录中拥有最深的缓存折扣(每 M 缓存 token 0.006 美元,相当于其输入费率的 2%)。
- 如果缓存完全可靠,同样的 DeepSeek-V4.1-Flash 会话成本将为 0.082 美元,比 GLM-5.3-Flash 便宜约 30%。每次会话大约有三次未命中,每次约 0.059 美元,这弥补了差距。
- DeepSeek-V4.1-Flash 的
reasoning_effort仅接受low、high、xhigh和max,而非模型卡中描述的 1–100 整数。在 40 个测试问题上,max的成本最高可达low的 1.88 倍,且从未提高准确率。
Why DeepSeek-V4.1-Flash needs an 88% cache hit rate to break even on input cost
根据 DeepSeek 的模型卡片,DeepSeek-V4.1-Flash 是一个混合专家模型,主干参数量达 552B,采用因果编码器-解码器架构:整个 Transformer 共 40 层,前 20 层是因果编码器,后面接 20 层解码器。解码器的全局 KV 缓存并非取自解码器各层自身的隐藏状态,而是由编码器最终的隐藏状态投影得到。这样一来,模型在预填充阶段每个 token 只需激活 8B 参数,解码阶段为 16B——DeepSeek 表示,这种划分正是为输入量占大头的智能体工作负载而设计的。
第二项技术是 SWA Bounded Replay,只需重放最近的 n_win 个 token,就能重建缺失的滑动窗口 KV 状态。这彻底免除了把 SWA KV 持久化到 SSD 的必要,持久化 KV 缓存的占用也随之降到 DeepSeek-V4-Flash 的约八分之一。再叠加 FP4 KV 缓存和跨层 KV 共享,模型卡片给出的全局 KV 缓存为每 token 890 字节,约为 DeepSeek-V4-Flash 的四分之一。这些都是 DeepSeek 自己给出的数字;我没有测量过模型内部,只算过跑起来要花多少钱。
缓存存得少,理应就少收钱——这个理念也直接体现在DigitalOcean 的价目表里。V4.1-Flash 的标价为每百万输入 token 0.30 美元、输出 1.20 美元、缓存输入 0.006 美元。缓存读取费用只有输入价格的 2%。
这是 DigitalOcean 目录里最低的比例,不过领先幅度不大。Claude Fable 5.1 的缓存读取占其输入价格的 2.5%,DeepSeek V4 Pro 0813 则是 3.3%:
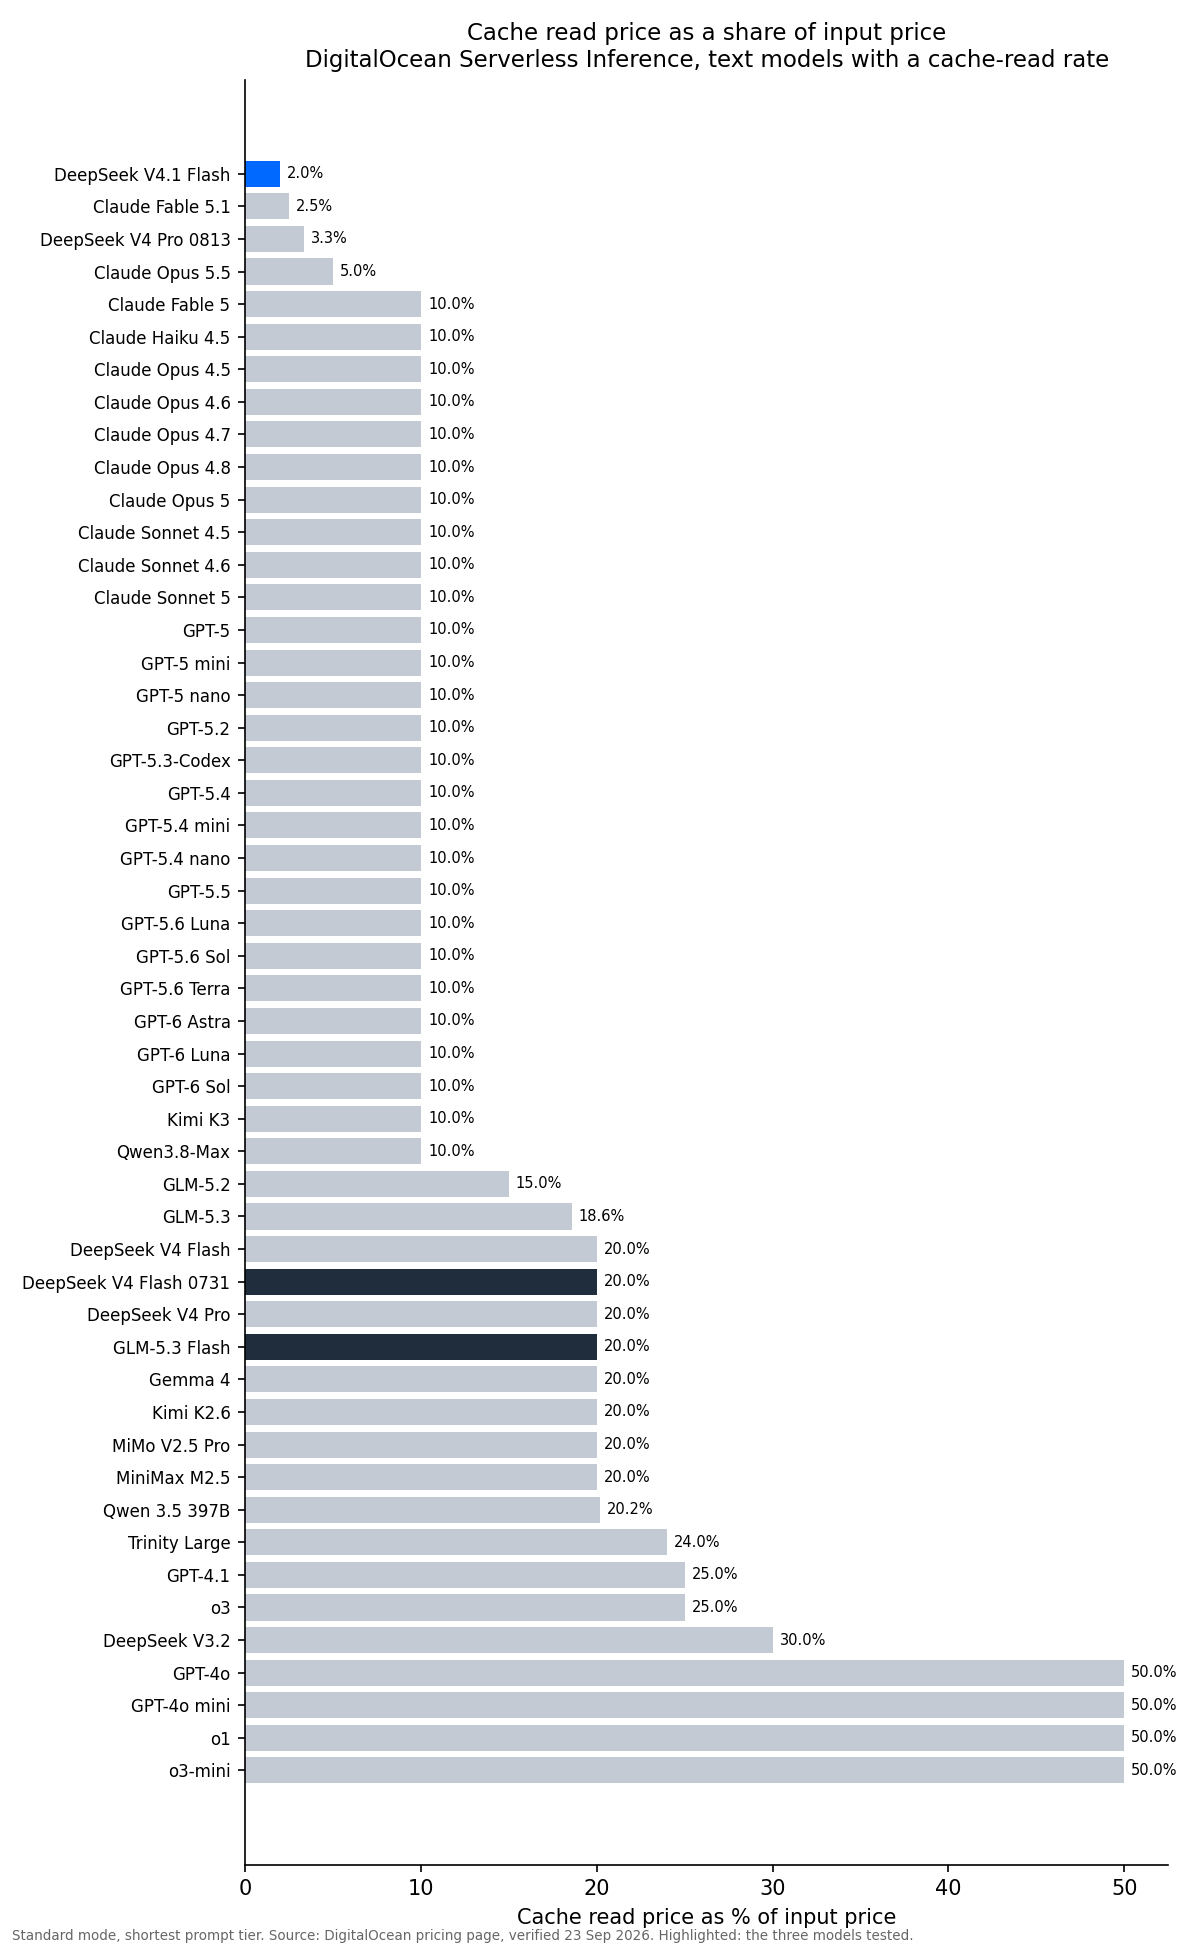
Claude Opus 5.5 为 5%,再往后,目录里的大多数模型都落在 10% 到 30% 之间,其中包括我拿来对比的两个:DeepSeek-V4-Flash-0731 和 GLM-5.3-Flash 均为 20%。如果你构建的智能体每轮都要重新读取一大段固定上下文——大多数真正有用的智能体正是如此——那么这个数字看上去就是唯一值得关注的指标。
但别忘了其他价格也在动。V4.1-Flash 的输入价格是上一代的 2.1 倍(0.30 美元,而 DeepSeek-V4-Flash-0731 为 0.14 美元),是 GLM-5.3-Flash(0.15 美元)的 2 倍;输出价格则是上一代的 4.3 倍(1.20 美元对 0.28 美元)。新架构买来了大幅的缓存折扣,定价则用更高的标价为此买单。这是一场豪赌,赌的就是你的工作负载以缓存命中为主。
这场赌局要多准才划算?其实很容易算出来。在相同命中率 h 下,令两者的输入账单相等:
(1 − h)(0.30) + h(0.006) = (1 − h)(0.14) + h(0.028)
h ≈ 0.879
如果两款模型的缓存命中率相当,V4.1-Flash 要在输入成本上追平它所替代的模型,命中率大约需要达到 88%;要追平 GLM-5.3-Flash,则需要约 86%。
这个公式背后悄悄藏着一个假设:两款模型的可靠性不相上下。于是问题的全部就在于——你实际能不能拿到 88%?竞品能不能拿到更多?而这两个数字,没有任何一方公开过。
我是如何在 DigitalOcean Serverless Inference 上实测提示词缓存的
三款模型,均具备 100 万 token 的上下文窗口,均部署在 DigitalOcean 无服务器推理服务上:DeepSeek-V4.1-Flash、DeepSeek-V4-Flash-0731 和 GLM-5.3-Flash。
针对每款模型,我都在一份大型静态文档上进行 15 轮对话。文档放在系统消息里,整个会话期间绝无变动,增长的只有对话尾部。这既是智能体在真实场景中的运行形态,也是提示词缓存定价所预设的形态。文档共三部(《白鲸》、《战争与和平》和《堂吉诃德》,均取自 Project Gutenberg),各有两种规模:约 5 万和 20 万 token。总计 18 个会话、270 次调用。
有两个设计细节比我想象的更关键。
每个会话开头,系统消息的最顶端都放一个全新的 UUID。DigitalOcean 的缓存匹配要求 token 前缀完全一致,开头只要有一个 token 不同,就无法命中。用这种方式给每个会话做命名空间隔离,既能保证第 1 轮是名副其实的冷启动,也能防止昨天的运行把今天的数据衬得过于便宜。
三份文档互不相关。我最初试跑时,每种提示长度用的都是同一段重复的填充短语,结果所有测试条件彼此共享前缀,本应是冷调用的请求返回时却已部分命中缓存。这种错误很容易犯,而且会在不知不觉中虚增你的命中率。
在会话测试之外,我还额外运行了:
- 针对 V4.1-Flash 的缓存块大小探测:从 540 到 6,220 token 共九种提示长度,每种重复五次;另外在单一长度上单独跑了两轮各 20 次的重复实验(合计 85 次调用)。
- 两轮推理力度扫描,覆盖全部四个档位,每档重复三次:20 道单步问题(240 次调用),以及 20 道需要真正多步计算的问题(240 次调用)。每道题的答案都在 Python 中计算并验证过,而非凭记忆作答。
- 正式运行前的 9 次调用冒烟测试。
以下内容均基于同一账号、同一地区,大约在2026年9月的两天内进行。该平台对开源模型提供提示缓存功能,而四桶工作量限制很可能是DigitalOcean可随时更改的网关选择。请将所有信息视为过时资料。
特别说明价格:DeepSeek-V4-Flash-0731 的费用在我运行和发表之间发生了变化。当时它的标价为输入 $0.08,缓存命中 $0.0252,输出 $0.252。文章中所有 V4-Flash-0731 的费用均基于当前标价(输入 $0.14,缓存命中 $0.028,输出 $0.28)以及记录的 token 数重新计算,因而对比反映的是您今天实际需要支付的费用。命中率和 token 数不受影响。原始日志保存了旧价格,因此如果您从仓库重新跑数字,请先为该模型重新定价。在依赖这些计算之前,请先查看 实时数据。
DeepSeek-V4.1-Flash 提示缓存的工作原理:64-token 块,全有或全无命中,且无保证命中
在进行昂贵的测试之前,我使用九种不同长度的提示词,每种重复五次来探测其机制。
每次缓存命中(共计九种提示词大小中的 20 次)返回的缓存 token 数恰好为 exactly floor(prompt_tokens / 64) × 64。不是近似值。每次都如此。
因此缓存以 64-token 为块进行操作。命中时,它会覆盖每个完整的块,仅对尾部剩余部分按全价计费。覆盖具有确定性且实际上是最大的,这意味着 你永远不会得到部分缓存。你只能得到最后一个完整的 64-token 块之前的全部内容,或者一无所获。
这极大地简化了经济模型。命中 幅度 是已解决的变量。命中 可靠性 是唯一尚未解决的问题,且相同的探测表明它仍未得到解决。这 20 次命中来源于 36 次重复调用,每次提示词与几秒前发送的完全相同。这就得到 56% 的命中率,而在九种长度中每种都出现了未命中。
在单个 3,193-token 提示词上进行的两次更长的探测,各重复 20 次,表现更好:19 次调用中有 16 次命中以及另一组 19 次调用中有 18 次命中。未命中的情况分散出现,而非集中在开始。即便是在最简单的情况下,此模型的温缓存也只是可能出现,而非保证。
一种改进,在会话运行中可见:随着对话增长,缓存的 token 通常对应于 较早 请求的块对齐前缀,而不是当前请求。在 V4.1-Flash 的 67 次会话命中中,有 66 次匹配了当前提示或较早轮次的 64-token 对齐长度,其中 51 次匹配了较早的轮次。在一次 50K 的会话中,第 2 轮返回了 51,392 个缓存 token。这等于 floor(51453 / 64) × 64,即第 1 轮的提示长度,而不是第 2 轮的。此后累积的尾部将按全价计费。在面对 200K 前缀时,每轮几百个 token 的误差属于舍入误差,但这解释了为什么测量的命中率在 99.x% 处趋于平稳,而不是达到 100%。
DeepSeek-V4.1-Flash 与 GLM-5.3-Flash 以及 DeepSeek-V4-Flash-0731 的对比:15 轮代理会话的成本
以下是一张表格中的完整实验。十五轮,200K-token 文档,三份文档的平均值,当前列表价格:
| V4.1-Flash | V4-Flash-0731 | GLM-5.3-Flash | |
|---|---|---|---|
| 标称输入费率 | $0.30/M | $0.14/M | $0.15/M |
| 缓存读取费率 | $0.006/M | $0.028/M | $0.03/M |
| 命中缓存的热轮次(共 42 次) | 33 | 26 | 42 |
| 热轮次的有效输入费率 | $0.0691/M | $0.0707/M | $0.0304/M |
| 一次 15 轮会话的成本 | $0.2588 | $0.2273 | $0.1167 |
“热轮次” 指第 2–15 轮,在刻意设置的冷启动第一轮之后:每会话 14 轮,三份文档共 42 轮。
DeepSeek-V4.1-Flash 的成本是 GLM-5.3-Flash 成本的 2.2 倍,完成相同工作。在 50K 时,顺序相同:每会话 $0.0641、$0.0455、$0.0322。
GLM-5.3-Flash 在纸面上拥有 较差 的缓存折扣:相比 V4.1-Flash 的 2%,其比例为 20%。其缓存 token 的成本高出五倍。尽管如此,它仍以明显优势获胜,因为它在两种上下文规模下的 全部 84 次热轮次都命中了缓存。V4.1-Flash 在 200K 时有 9 次未命中(共 42 次),在 50K 时有 8 次未命中(共 42 次)。
按 turn 绘制累计成本,机制可见于线条的形状。GLM-5.3-Flash 是一条直线。V4.1-Flash 是一个阶梯,每一步都是一次缓存未命中。
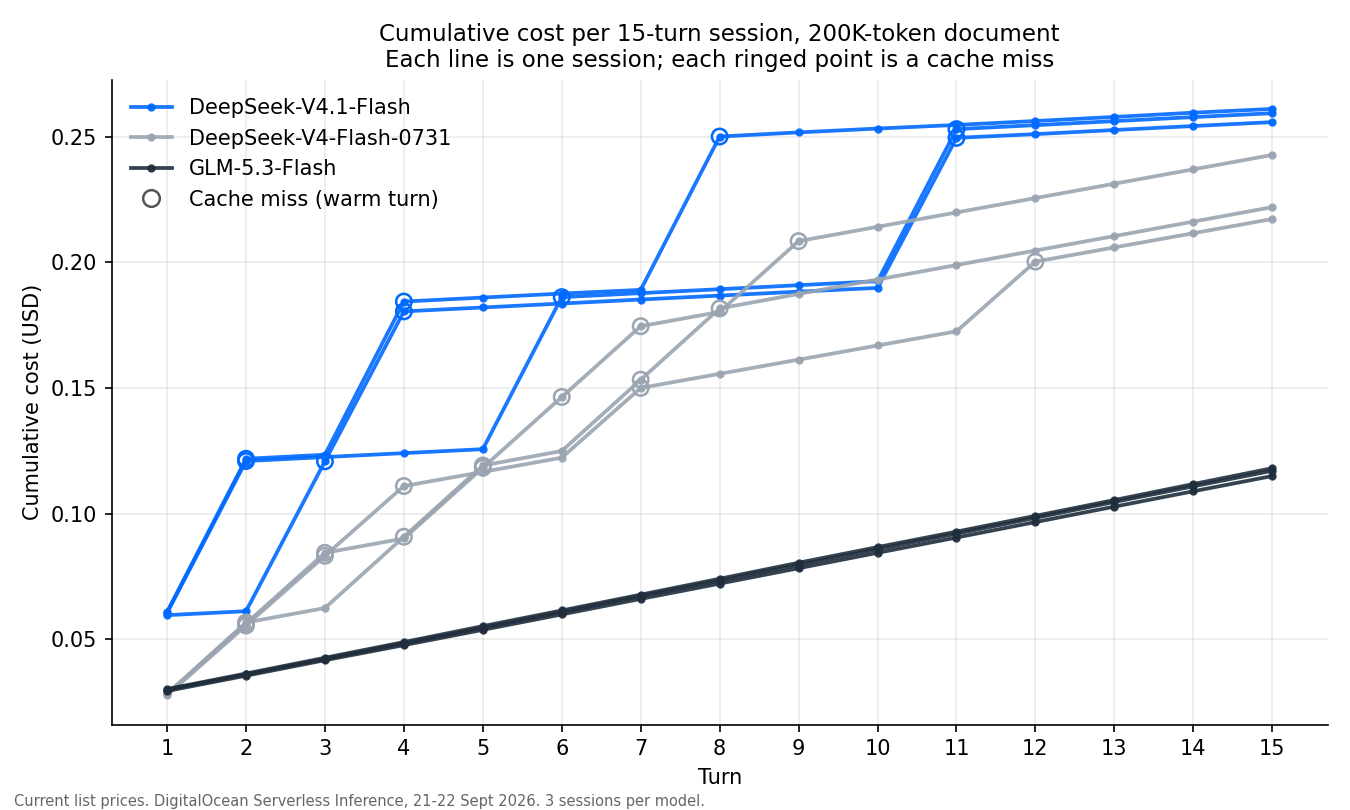
观察 V4.1-Flash 两条曲线上的第 10 到第 11 轮:在几轮每轮成本约为六分之一美分之后,单轮成本跳升六美分。这表示一次未命中。
DeepSeek-V4.1-Flash 单次会话成本拆解:冷启动回合、缓存命中、缓存未命中与输出
把每次会话的账单逐项拆开,情况就一目了然了:
| 每次会话(200K) | V4.1-Flash | V4-Flash-0731 | GLM-5.3-Flash |
|---|---|---|---|
| 冷启动首轮 | $0.0600 | $0.0280 | $0.0298 |
| 未命中的热回合 | $0.1801 | $0.1494 | $0.0000 |
| 命中的热回合 | $0.0136 | $0.0487 | $0.0853 |
| 输出 token | $0.0051 | $0.0013 | $0.0017 |
| 合计 | $0.2588 | $0.2273 | $0.1167 |
V4.1-Flash 的缓存命中便宜得出奇:每次会话 11 次命中的费用加在一起,还比不上 GLM-5.3-Flash 一次冷启动回合的价钱。问题出在另一列。每次会话的 3 次未命中,占掉了 V4.1-Flash 账单的 70%。
在 DeepSeek-V4.1-Flash 上,一次缓存未命中要花多少钱
在 200K token 规模下,每个热回合要么命中、要么未命中,而日志为两种结果都给出了精确的价格:
| 单个热回合(200K) | 命中时的输入成本 | 未命中时的输入成本 | 未命中的额外成本 |
|---|---|---|---|
| V4.1-Flash | $0.0012 | $0.0600 | $0.0588 |
| V4-Flash-0731 | $0.0056 | $0.0280 | $0.0224 |
| GLM-5.3-Flash | $0.0061 | (零未命中) | — |
V4.1-Flash 一次未命中的成本是命中的 50 倍,每发生一次,整场会话就多花约 6 美分。V4.1-Flash 平均每次会话出现 3 次未命中。这 3 个回合共花费 $0.180,而若全部命中只需 $0.004,也就是说,未命中让一场本可以只花 $0.082 的会话多花了 $0.177。三次 200K 会话合计,9 次未命中额外多花了 $0.53。
这个0.082美元是值得深思的反事实价值。使用完全相同的日志会话,将每一次未命中都转换为命中。如果缓存完全可靠,V4.1-Flash 每次会话的成本将是0.082美元:比GLM-5.3-Flash便宜0.034美元,也是三者中最便宜的。 架构和定价正好兑现了它们的承诺。未命中把0.034美元的领先转变为0.142美元的亏损。
同样的算术得出真实的盈亏平衡点。V4.1-Flash 相对于 GLM-5.3-Flash 的0.034美元优势在经历0.58次未命中后被耗尽,每次未命中成本为0.0588美元。这相当于在14次热启动中略超过半次未命中,或者说大约是96%的命中率。实际测量为78.6%。之前得到的86%盈亏平衡过于乐观,因为它假设GLM-5.3-Flash的未命中频率与V4.1-Flash相同。实际上GLM-5.3-Flash几乎没有未命中。
在小规模下,这些只是几分钱。但在生产规模下,情况就不一样了。如果一个代理每天运行1000次会话,具有这种形状和未命中率,仅因未命中每天就会花费约177美元,一个月约5300美元。
这种失效模式具有非对称性,足以让人感到担忧。V4.1-Flash 在未命中时的输入速率是 GLM 的2倍,在命中时是0.2倍。这是一种高方差的定价结构,而在试图预测账单时,方差是不利的。
DeepSeek-V4.1-Flash 与 DeepSeek-V4-Flash-0731 对比:为什么更新的模型每次会话成本高出14%
与 V4-Flash-0731 的比较更为接近且更具趣味性。两种模型在热启动时的有效输入速率基本持平:V4.1-Flash 为0.0691美元,V4-Flash-0731 为0.0707美元,V4.1-Flash 仅略占优势,尽管其命中缓存的频率要高得多(78.6% 对比 61.9%)。
V4.1-Flash 仍然每次会话贵14%,差额为0.031美元。费用分解说明了原因。其较便宜的命中每次可节省0.035美元,而其较昂贵的未命中则多花0.031美元,两者基本相互抵消。剩下的部分是冷启动的第一轮,由于 V4.1-Flash 在前200K token 上支付0.30美元而非0.14美元,导致多花0.032美元。输出 token 的贡献不到半美分。
换句话说,2.1倍的输入溢价需要在每次冷启动和每次未命中时支付。只有在命中时,缓存折扣才能收回这部分成本。短会话、频繁的前缀变化以及不可靠的缓存都会使计算对 V4.1-Flash 不利。
DeepSeek-V4.1-Flash、DeepSeek-V4-Flash-0731 和 GLM-5.3-Flash 在 50K 与 200K token 下的 Prompt 缓存命中率
| 预热轮次命中率 | 50K 上下文 | 200K 上下文 |
|---|---|---|
| V4.1-Flash | 81.0% (34/42) | 78.6% (33/42) |
| V4-Flash-0731 | 78.6% (33/42) | 61.9% (26/42) |
| GLM-5.3-Flash | 100% (42/42) | 100% (42/42) |
随着上下文增长,V4-Flash-0731 的表现明显变差。V4.1-Flash 几乎没有变化;差异仅为一次轮次。结合块大小探测中短提示的 56% 命中率,证据并不支持“小上下文是安全的”。GLM-5.3-Flash 在两种规模下均未出现遗漏。
这些遗漏与内容无关:在 200K 时,V4.1-Flash 在每份文档中恰好遗漏了三次预热轮次。
DeepSeek-V4.1-Flash 在缓存命中和缓存未命中的延迟
| 200K 的预热轮次 | 命中 | 未命中 |
|---|---|---|
| V4.1-Flash | 6.90s | 19.67s |
| V4-Flash-0731 | 10.92s | 24.83s |
| GLM-5.3-Flash | 5.84s | (从未遗漏) |
在 V4.1-Flash 200K 下,一次未命中几乎相当于 3× 的墙钟时间以及 50× 的输入价格。如果您正在构建任何交互式应用,不可靠缓存的尾部延迟与费用同样重要。
DeepSeek-V4.1-Flash reasoning_effort:支持的值、token 成本和准确性
回到 reasoning 旋钮。我在所有四个桶上各进行了两次遍历,每次重复三次。
在 20 个单步问题上,调节 dial 基本没有作用。每个桶中的中间 reasoning 长度在 26 到 28 token 之间,max 下的平均成本仅比 low 高 6%,所有答案均正确。
第二轮测试选用了20道真正需要多步推算的题目:约瑟夫环幸存者位置、错排计数、模幂运算,以及大数幂的数位和。
| 档位 | 推理 token 中位数 | 90分位数 | 平均成本 | 准确率 |
|---|---|---|---|---|
| low | 362 | 2,238 | 1.00× | 100% |
| high | 372 | 2,708 | 1.20× | 100% |
| xhigh | 372 | 2,993 | 1.75× | 100% |
| max | 432 | 4,497 | 1.88× | 98.3% |
max 在20道题中有17道的单项成绩超过 low,单题比值的中位数为1.55×。这个效应真实存在,而且呈单调变化。
但请注意差异藏在哪。中位数几乎没动:从 low 到 max 只涨了19%,90分位数却翻了一倍。这个旋钮在模型觉得容易的题目上几乎不起作用,只在困难的尾部题目上才拉开差距。如果把两类题目平均到一起看,你将完全察觉不到它。
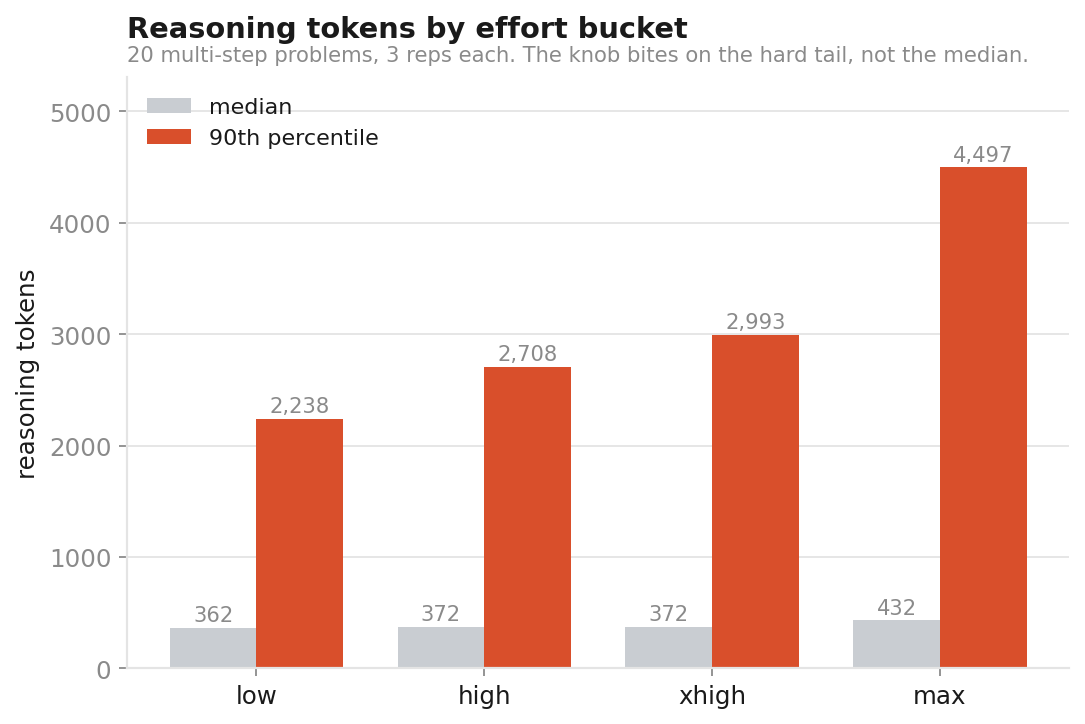
各档位之间的间距同样不对称。按推理 token 中位数看,low、high 和 xhigh 几乎无法区分;按平均成本看,low → high 涨了 +20%,high → xhigh 涨了 +46%,而 xhigh → max 只涨了 +7%。真正的台阶出现在 high 和 xhigh 之间,而最上面的两档成本几乎一样。
准确率自始至终没有提升。全部480次调用中唯一的准确率事件发生在 max:其中一道题把16,000 token的推理上限全部耗尽,最后返回了一个空响应。不是答错了——是压根没有答案。low 遇到同一道题三次全部答对;xhigh 在另一次调用中也险些重蹈覆辙,花了15,698个推理 token,距上限只差302个,才总算答对。
也就是说,在这类任务上,你最多要多付1.88倍的输出 token(输出价格按每百万 $1.20 计费),却测不出任何收益;而且最高档还因为思考超出了 token 上限,制造了整轮测试中唯一的一次失败。
需要坦白说明的局限是:这40道题全部是确定性的整数计算,本来就属于额外深思难以派上用场的任务类型。我无法断言这些档位在一般场景下都没用;我只能说,在这次测试里我检测不到任何收益,而且如果你习惯性地直接选 max,最好先确认它到底给你带来了什么。
如何为提示词缓存选择模型并组织提示词结构
在根据缓存价格选择模型之前,先测量自己的命中率。 提示缓存 在 DigitalOcean 上的开源模型中是自动启用的,因此无需手动开启,只需检查即可。只需花费一个下午和几美元。usage 对象在每次调用时会提供 prompt_tokens_details.cached_tokens;记录该值并进行除法运算。模型的缓存命中率是公开的数字,而其缓存 可靠性 则不是;根据此证据,后者更为重要。
下面是使用 OpenAI Python SDK 针对 DigitalOcean 的 OpenAI 兼容端点进行日志记录的最小示例:
import os
from openai import OpenAI

client = OpenAI(base_url="https://inference.do-ai.run/v1",
                api_key=os.environ["MODEL_ACCESS_KEY"])

document = open("reference.txt").read()  # static prefix: never changes within a session
messages = [{"role": "system", "content": document}]

for question in ["Summarize chapter 1.", "Who is the narrator?", "What happens next?"]:
    messages.append({"role": "user", "content": question})
    resp = client.chat.completions.create(model="deepseek-v4.1-flash",
                                          messages=messages, reasoning_effort="low")
    u = resp.usage
    cached = (u.prompt_tokens_details.cached_tokens or 0) if u.prompt_tokens_details else 0
    print(f"prompt={u.prompt_tokens} cached={cached} hit_rate={cached / u.prompt_tokens:.1%}")
    messages.append({"role": "assistant", "content": resp.choices[0].message.content})
第一轮之后,每行应显示约 99% 的命中率。任何打印 cached=0 的行都是未命中,按全额输入费率计费。在几十个会话中统计这些行,即可得到你自己的可靠性指数。仓库链接中提供的完整测试套件增加了成本核算、会话命名空间和 JSONL 日志。
根据实际会话成本比较模型,而非价目表。 相同命中率的盈亏平衡点表明 V4.1-Flash 需要 86% 才能与 GLM-5.3-Flash 持平。相对于 GLM-5.3-Flash 的实际可靠性,它大约需要 96%。在你的工作负载上运行两种模型并比较账单。
构造提示词以实现精确前缀匹配,并验证其有效。 静态内容放前,动态内容放后。系统提示词顶部附近的一个模板时间戳会悄然让你付出全部代价。64-token 的块粒度意味着你还希望稳定前缀明显长于 64 个 token,实际上这不会产生额外费用。
统计你的冷启动次数。 V4.1-Flash 在每次冷启动时需支付全部 2.1× 输入溢价:每个新会话、每次前缀更改、每次未命中。在 200K-token 上下文中,这相当于每次 0.06 美元,而 GLM-5.3-Flash 为 0.03 美元。在稳定前缀上的长期会话是缓存折扣发挥作用的地方;短会话和频繁重建的上下文则不然。
关注输出,但这里不是问题所在。 每会话约 4,200 个完成 token,输出仅占 V4.1-Flash 账单的约 2%。如果你的代理大量生成输出,相较于 V4-Flash-0731 的 4.3× 输出溢价将开始显现,请将其纳入建模。
不要默认使用 max。 从 low 开始,仅在你测量到准确率提升的任务类别上逐步提升。上限失效是真实风险,而非仅理论上的。
请将上述内容视为易失信息。 这些是单一平台上的列表价格,在两天内单一账户上测得,并针对开源模型启用了提示缓存。在发布前,三种模型中的一种已被重新定价。
结论:缓存可靠性比缓存价格更重要
我无法从外部验证 DeepSeek-V4.1-Flash 的内部实现,但其定价讲述了一个一致的故事。DeepSeek 报告称其持久 KV 缓存仅为前身的八分之一,而 DigitalOcean 将此作为其目录中最低的缓存读取比例:是 GLM-5.3-Flash 及其自身前身的十分之一。这并非营销手段。如果缓存始终命中,它将是我测试过的最便宜的模型。
尽管该模型的缓存-token 价格高出五倍,但它仍然让我花费了相当于该模型 2.2 倍的费用,完成完全相同的工作,因为该模型每次都命中缓存,而这个模型则有五次中有一次未命中。
缓存可靠性是一个定价术语。只是没有人会把它印出来。
所有测量均在 2026 年 9 月 21–22 日针对 DigitalOcean Serverless Inference(inference.do-ai.run)进行。共 844 次 API 调用(270 次会话,480 次努力扫 sweep,85 次块大小探测,9 次烟雾测试),总费用约为 2.42 美元(按我运行时的价格计算)。V4-Flash-0731 的费用按当前列价显示。原始 JSONL 日志及完整测试套件:github.com/Jameshskelton/cache_review



