运行窗口:2026年10月28日 12:01 UTC 至 2026年10月30日 11:53 UTC。
我们在 DigitalOcean Serverless Inference 上对四个模型进行了48小时计时测试:GLM-5.3、DeepSeek V3.2、Gemma 4 31B 和 Llama 4 Maverick(共3,456次请求)。在约1,000 token的提示词下,GLM-5.3、Gemma 4 和 Llama 4 Maverick 的首个回复中位时间约为1.0至1.1秒,100次请求中有99次在3.4秒内开始响应。DeepSeek V3.2 的中位首响时间为1.35秒,100次请求中有99次在13.7秒内开始。全部请求成功率为99.74%,Gemma 4 完成了全部864次请求。GLM-5.3 流式输出最快,达到每秒59个token,但它会先进行推理:首个答案token约需26秒。
本次测试建立在此前的TTFT延迟审计(单次运行测量了380次冷调用)和并发基准测试(考察负载下的表现)基础之上。此次的新意在于:审计提供的是快照,并发基准测试改变负载,而本次运行将负载固定为每次一个请求,观察延迟在48小时内的变化、尾部表现(p95和p99)以及按时间段的变化。我们还测量了回复的流式传输速度,并检查审计中发现的 DeepSeek V3.2 长时间等待是否会再次出现。
结果一览
中等提示词(约1,000至1,100 token)的首token时间(TTFT)、每秒token数以及所有提示词长度下的错误率。每个模型864次请求。
| 模型 | TTFT p50 | TTFT p95 | TTFT p99 | 每秒token数 p50 | 每秒token数 p5 | 错误率 | 回复中位数(token) |
|---|---|---|---|---|---|---|---|
| GLM-5.3 | 1,049 ms | 1,846 ms | 2,130 ms | 59.4 | 52.4 | 0.12% | 约1,990(推理) |
| Gemma 4 31B | 1,059 ms | 1,986 ms | 2,225 ms | 43.9 | 24.6 | 0.00% | 224 |
| Llama 4 Maverick | 1,119 ms | 2,116 ms | 3,332 ms | 15.0 | 6.8 | 0.12% | 235 |
| DeepSeek V3.2 | 1,353 ms | 5,837 ms | 13,654 ms | 32.6 | 5.4 | 0.81% | 165 |
如何解读:
- TTFT 是请求等待首个token到达的时间。p50代表典型请求,p95和p99代表100次请求中95次和99次优于的时间。
- GLM-5.3 在回答前先进行推理,因此其首个token到达较早,但首个答案token的中位时间为25至27秒(见推理部分)。
本文使用的关键术语
- 延迟:发出请求后等待响应的时间。我们把它拆成首 token 时间和每秒 token 数。
- Token:模型读写的基本单位,大约相当于四分之三个英文单词。
- TTFT(首 token 时间):回复的第一个 token 到达需要多久。它决定界面感觉有多快。
- 每秒 token 数:第一个 token 之后,token 流出的速度(CSV 中该列名为
decode_tps)。它决定长回答需要多久才能完成。 - p50(中位数):典型请求的耗时。一半请求更快,一半更慢。
- p95 和 p99:分别有 95% 和 99% 的请求快于这两个时间。它们反映最慢的 1/20 和 1/100 请求有多慢。
- p5(针对每秒 token 数):慢速端。只有 5% 的请求流出速度比它更慢。
- 推理模型:先写出思考过程再给出答案的模型,因此它的第一个 token 并不是答案的开头。
- 提示词缓存:复用服务已见过的提示词前缀上的计算,从而降低重复前缀的 TTFT。
- HTTP 529(“平台过载”):服务返回该状态,表示当时容量已满。DigitalOcean 的文档指出,共享容量上可能出现“过载”响应。
为什么关注 TTFT 和每秒 token 数
设想一个基于托管大模型 API 搭建的客服助手。如果回复通常在一秒内开始,用户会觉得即时;而偶尔一次要等十秒的请求,恰恰是客户会记住的那次。你实际感受到的数字不是平均值,而是每二十次里最慢的那次、每百次里最慢的那次——这正是我们报告 p95 和 p99 的原因。
TTFT 决定聊天或语音界面的响应感。每秒 token 数决定长回答需要多久才能写完。对聊天而言,TTFT 占主导;对长文本生成(如代码或报告),每秒 token 数占主导。对 Agent 循环来说,两者都重要,而且都要乘以步数。2 秒的 TTFT 一次可以接受;但在一个 15 步的 Agent 运行中,这意味着在计入任何模型输出之前就要等 30 秒。
对推理模型来说,流式输出的第一个 token 往往是推理 token,并不属于答案内容。我们统计的 TTFT 是任意类型的第一个 token,这样各模型之间可以横向比较;同时我们也单独报告推理模型输出第一个答案 token 的时间。
方法
所有数字都来自我们随原始数据一同发布的脚本。测试设置集中说明如下:
- 模型:
glm-5.3、deepseek-3.2、gemma-4-31B-it、llama-4-maverick。我们选了 DigitalOcean 托管的四个开放权重模型,分别来自四家不同的实验室,参数量从 310 亿到 7530 亿不等:glm-5.3(Z.ai,753B,始终开启推理)、deepseek-3.2(DeepSeek,680B)、llama-4-maverick(Meta,400B)和gemma-4-31B-it(Google,31B)。DeepSeek V3.2 和 Gemma 4 也正是我们此前审计中点名存在长时间等待、长提示词下变慢的两个模型,因此可以借此复验那些结论。我们略去了更大、更贵的模型(如 Kimi K3),以把整轮测试成本控制在 15 美元左右。参数量取自 DigitalOcean 的支持模型页面。 - 提示词:每个请求都要求完成同一项任务。系统消息携带一个随机会话 ID。用户消息是一份编号列表,内容为虚构的服务运维笔记(队列批处理、重试、缓存淘汰、证书轮换、部署等),重复填充到约 60、750 或 7,500 词,然后提问:“根据这些笔记,写恰好 5 个编号要点,每个约 40 词,说明值班工程师应优先检查什么。”提示词 token 中位数因分词器而异:短提示 159 至 185,中提示 1,035 至 1,133,长提示 9,551 至 10,900(各模型明细表见代码仓库)。长提示与此前审计中使用的 10,000 token 提示词一致。
- 回复长度:所有模型收到相同指令,但回复长度各不相同。中提示下的回复 token 中位数:DeepSeek V3.2 为 165,Gemma 4 为 224,Llama 4 Maverick 为 235,GLM-5.3 约 1,990(它会推理,回复通常顶到上限)。回复长度直接影响总耗时,也会让短回复的每秒 token 数波动更大:165 token 的回复按每秒 33 token 输出,流式传输约 5 秒,一次短暂停顿就会让速率明显变化。跨模型比较每秒 token 数时请留意这一点。
- 节奏:每 10 分钟一次,每次一个请求,顺序打乱。共 288 轮、3,456 个请求,每个模型 864 个,每个模型每种提示长度 288 个。
指标定义
我们调用流式 /chat/completions 端点,参数为 stream: true、stream_options: {include_usage: true}、temperature: 0.2 和 max_completion_tokens: 2000,并在响应到达时逐块读取。我们把每个数据块称为一个 event。所有计时都在我们自己的机器上完成,使用单调递增的时钟。
- 计时起点:发送请求之前,连接已经建立。因此 TTFT 不含建立连接的时间,但包含从我们的服务器到端点的网络往返、请求排队等待的时间,以及模型读取提示词的时间。
- TTFT:从计时起点到第一个 delta 中含非空 token 的 event 所经过的时间。推理 token 计入。只携带 role 或空 delta 的 event 不计入。我们会单独记录第一个任意类型的 event(
first_chunk_ms),但不使用该数据。 - 首个回答 token 时间:使用同一时钟,但只有非空
content字段才计入。该指标仅对推理模型与 TTFT 不同。 - 每秒 token 数:
(completion_tokens - 1) / (最后一个 token event 的时间 - 第一个 token event 的时间)。completion_tokens取自最后一个 event 的usage对象,而非统计 event 数量。时间窗口从第一个 token 开始,因此 TTFT 不计入该数值。 - 推理 token:两项指标都计入推理 token。流式推理 token 会启动 TTFT 计时,也包含在每秒 token 数的时间窗口内。GLM-5.3 报告的
completion_tokens达到了我们 2,000 token 的上限(中位数 1,911),尽管其可见回答很短,这与usage计入推理 token 相符。因此它的每秒 token 数是推理流与回答流合并后的速率。 - 分块批量发送:DeepSeek V3.2 每个流式事件大约发送两个 token(其请求的中位数为 2.01,另外三家为 1.00 至 1.02)。由于 token 数取自
usage,批量发送不会改变分子,最多让结果偏移一个 token(对于典型的 165 token 回复,影响不到 1%)。批量发送也无法解释 DeepSeek 最快的那些请求:最快的 5% 请求每个事件的 token 数与其余请求相同(2.04 对 2.01,与速度的相关性为 0.05)。 - 我们看不到的部分:服务器或中间网络设备的缓冲。我们测量的是事件到达客户端的时间,因此缓冲后的集中发送会抬高请求的实测速率。请把最快的离群值视为客户端观测到的速率。
- 请求总时间:从同一开始时间到流结束。如果 HTTP 状态不是 200、连接出错,或没有任何 token 到达,该请求计为失败。
为什么每个提示词都以随机 nonce 开头
DigitalOcean 会自动为 DO 托管的模型缓存提示词。如果我们反复发送相同的提示词,大多数请求会命中缓存,TTFT 看起来会比首次请求好得多。在每个提示词开头加一个唯一的 nonce,可以强制模型每次都读取完整提示词。在一次简短验证中,重复相同前缀的 TTFT 低于带 nonce 的版本,说明这一效应确实存在。因此我们的数据反映的是未缓存的情况。如果你的应用有稳定的系统提示词,TTFT 应低于我们报告的值。参见使用提示词缓存。
结果:按模型和提示词长度统计的首 token 时间
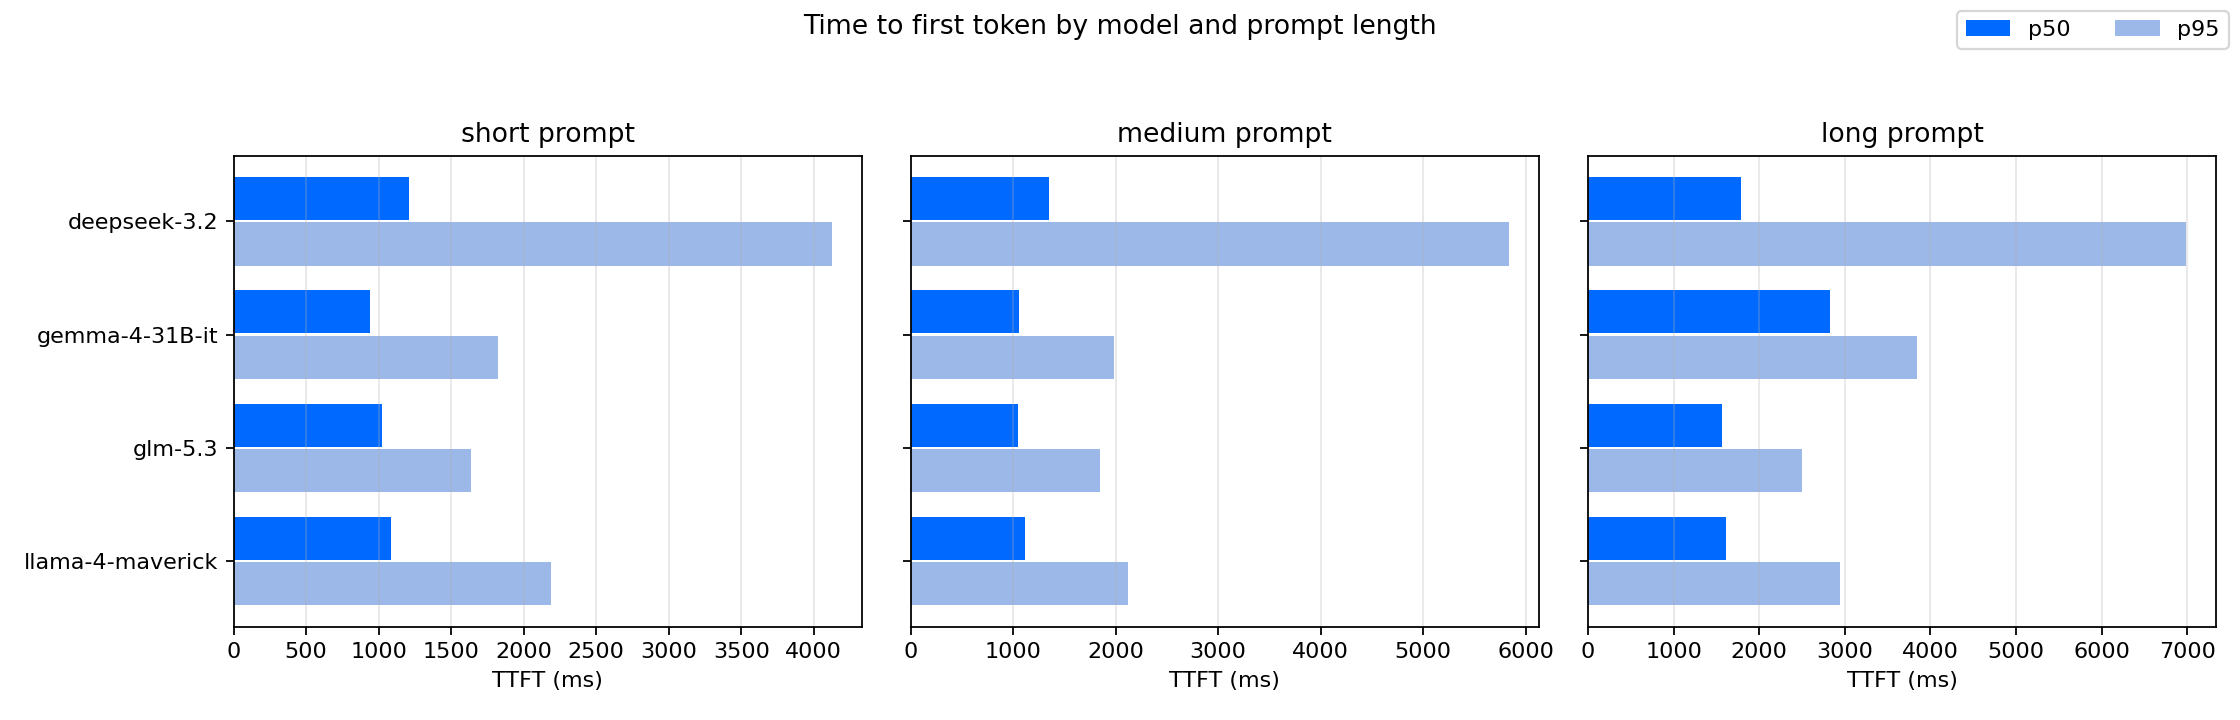
GLM-5.3:中等提示词下 p50 为 1,049 ms、p95 为 1,846 ms、p99 为 2,130 ms,长提示词下 p99 为 2,889 ms。这对回答意味着什么,见下一节。
Gemma 4 31B:短提示词下 p50 为 942 ms,中等提示词为 1,059 ms,长提示词(约 10,900 token)为 2,830 ms。这是所有模型中随提示词长度上升幅度最大的,与我们此前审计看到的一致。部分原因是分词器差异:Gemma 的长提示词约 10,900 token,而其他模型为 9,551 至 9,907。按此归一化后,效应依然存在:Gemma 的 TTFT 中位数每增加 1,000 个提示词 token 上升约 181 ms,而其他三家为 51 至 58 ms。其尾部与中位数差距不大:长提示词下 p99 为 4,308 ms。
Llama 4 Maverick:中等长度提示词下 p50 为 1,119 ms、p95 为 2,116 ms、p99 为 3,332 ms,长提示词下 p99 为 5,910 ms。最长的一次请求总共耗时 44 秒。
DeepSeek V3.2:中等长度提示词下 p50 为 1,353 ms、p95 为 5,837 ms、p99 为 13,654 ms,长提示词下 p99 为 20.2 秒(约 9,700 个 token)。其 p50 与其他模型处于同一区间,p99 则偏高;下文给出的超时与重试设置,可以简单有效地把这个区间控制在用户可接受的范围内。
推理模型:首个 token 不等于首个答案 token
GLM-5.3 会先流式输出推理 token,再给出答案。它的首个 token 约 1 秒到达,但首个答案 token 的中位到达时间为:短提示词 25.1 秒、中等提示词 27.0 秒、长提示词 26.9 秒(p95 约 34 至 36 秒)。
在 2,000 token 的输出上限下,863 次成功请求中有 373 次(43%)在上限处停止,其中 277 次(占全部请求的 32%)始终没有产出答案 token。我们的“答案到达时间”只统计了 586 次真正产出答案的请求,因此该数值只是真实情况的下界。另有 607 次请求(70%)总耗时超过 30 秒。
DigitalOcean 的模型页面为 GLM-5.3 列出了 low、high、max 三档推理强度,API 默认使用 max,并说明其推理无法关闭。我们按默认档位测试,因此如果你的产品在意首个答案的到达时间,首先应尝试调低推理强度。请测量首个答案 token 的到达时间,并设置推理预算。
结果:每秒 token 数
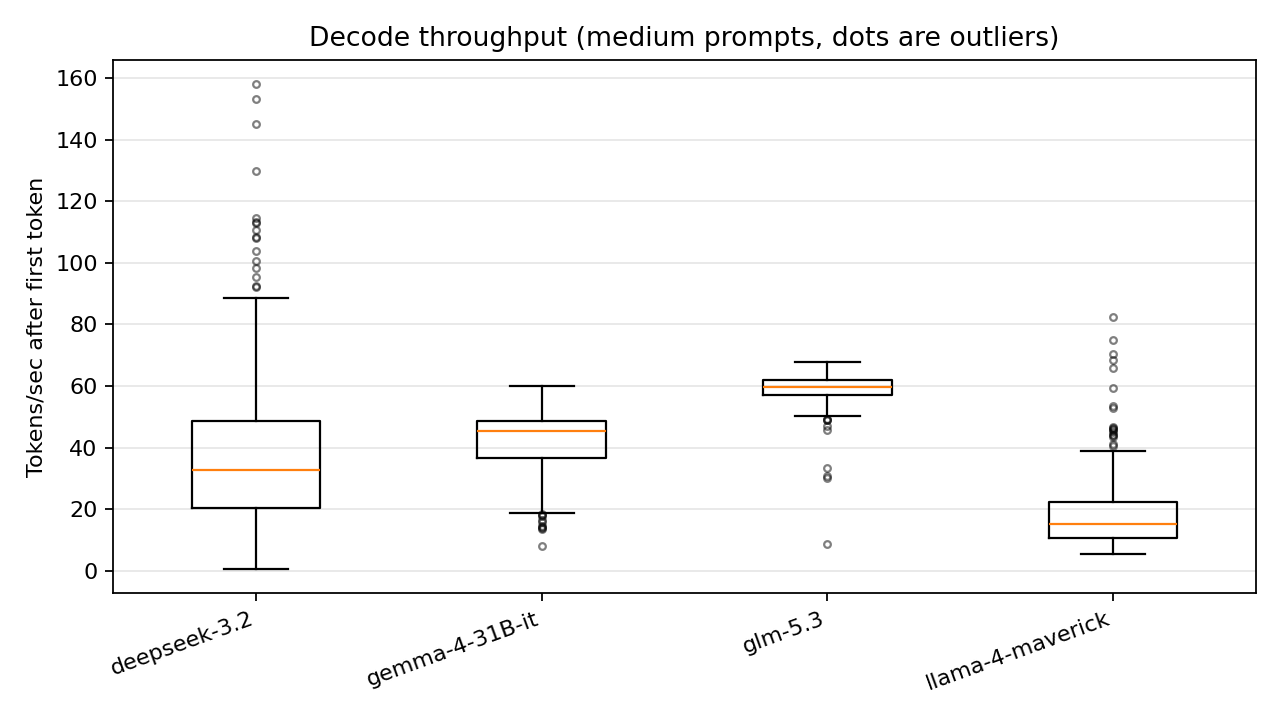
GLM-5.3 的速率最高也最稳定:p50 为每秒 59.4 个 token,p5 为 52.4。Gemma 4 次之,为 43.9(p5 为 24.6);DeepSeek V3.2 中位数为 32.6,p5 为 5.4;Llama 4 Maverick 中位数为 15.0(p5 为 6.8)。按每秒 15 个 token 计算,500 token 的回复约需 33 秒;按 p5 的 6.8 计算则需 74 秒。如“方法”一节所述,短回复得出的速率噪声更大,这对 DeepSeek V3.2 影响最大(其中位回复长度为 165 个 token)。
DeepSeek V3.2 的速率也能冲到很高:部分请求的流式速率超过每秒 150 个 token。我们手动核查了这些最快请求和最慢请求,两端都不是统计方式造成的假象(参见上文“我们如何定义指标”):最快的一次约 1 秒内输出约 158 个 token,最慢的一次则用 242 秒输出 133 个 token。
时段
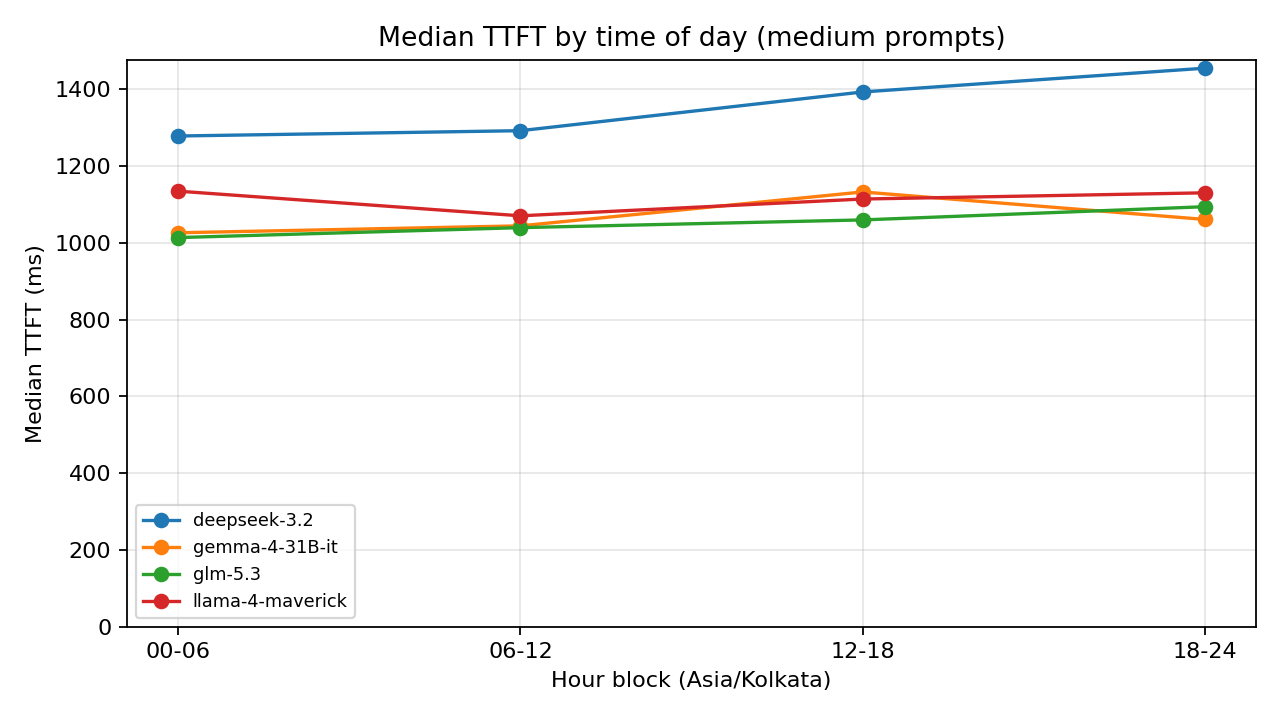
在这个时间窗口内,每个模型在相邻6小时区块之间的TTFT中位数变化都不超过14%,每个区块中每个模型有72个请求。DeepSeek V3.2的p95 TTFT和每秒token数在印度标准时间06:00至18:00区块中看起来不如另外两个区块(区块表格见results.md),但仅凭两天的数据,我们无法判断这是规律还是偶然。
尾部延迟与错误:我们观察到的现象及简单应对方法
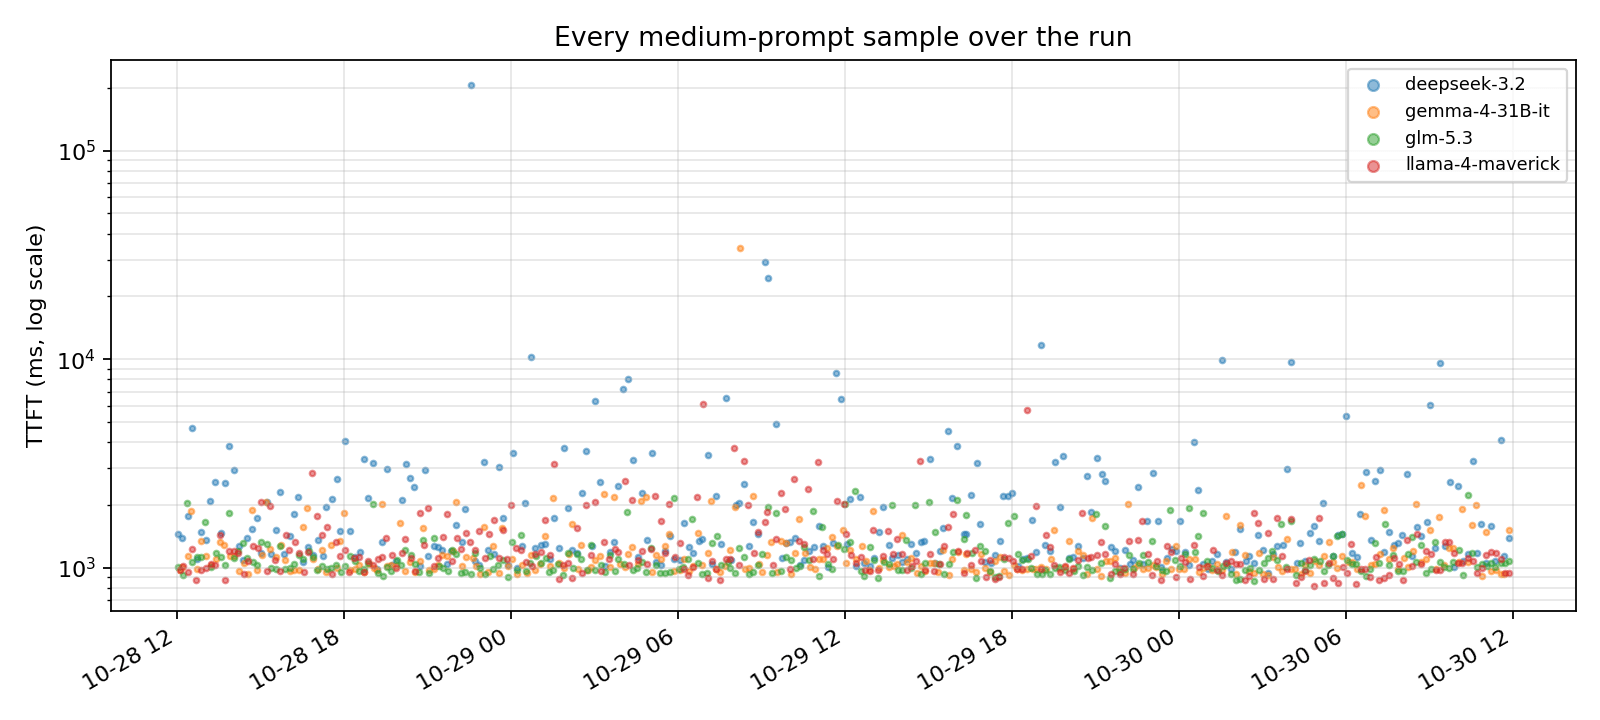
更长的等待。我们此前的审计记录到DeepSeek V3.2有两次首token等待时间很长(80次调用中分别为186.9秒和78.3秒)。在48小时内,我们又看到了几次,但频率很低:857次成功的DeepSeek V3.2请求中,有2次发送首token耗时超过60秒(206.5秒和210.0秒,约每430次出现1次),4次超过30秒,14次超过10秒。另有14次请求总耗时超过60秒,通常是因为首token正常返回后token流式输出变慢。首token超时覆盖前一组情况,总时长超时覆盖后一组,因此我们两者都报告。其他模型没有出现这种量级的等待:Gemma 4有1次请求总耗时超过60秒(89秒),Llama 4 Maverick则没有(最长44秒)。
错误。99.74%的请求成功(3,456次中有9次返回错误,占0.26%),Gemma 4完成了全部864次请求。DeepSeek V3.2的错误包括6次HTTP 529“平台过载”响应和1次空的200响应,GLM-5.3和Llama 4 Maverick各有1次529。DigitalOcean的限制文档说明,无服务器推理运行在共享容量上,按商业上合理的努力原则提供,即使在你配额范围内也可能出现过载响应,因此在生产客户端中做短暂重试是良好实践。本次测试我们没有重试,所以这些是首次尝试的结果。
如何利用这些结果
按工作负载选择模型。
- 短提示词和中提示词上的交互式聊天:Gemma 4 31B或Llama 4 Maverick。它们在中提示词上的p99 TTFT分别为2.2秒和3.3秒,且Gemma 4完成了每一个请求。对于接近10,000 token的提示词,Llama 4 Maverick和GLM-5.3的TTFT中位数更低(各约1.6秒,Gemma 4为2.8秒)。
- 长回答,或可以等待推理完成的工作:GLM-5.3的每秒token数最高(59.4,p5为52.4)。如果需要更快拿到首个回答,可以降低其推理强度。
超时和重试的设置要与你的延迟目标相匹配。
- 首 token 超时:以你所用提示词规模对应的 p99 为起点,再留出余量。对 Gemma 4、GLM-5.3 和 Llama 4 Maverick 来说,10 秒足以覆盖我们测到的所有 p99,包括 10,000 token 的提示词(最长 5.9 秒)。对 DeepSeek V3.2 来说,30 秒可覆盖其 p99(最长 20.2 秒),857 次请求中只有 4 次的首 token 启动时间超过这一数值。
- 总时长超时:可参考我们观察到的最长耗时。120 秒覆盖了 Gemma 4 和 Llama 4 Maverick 的全部请求(最长分别为 89 秒和 44 秒)。对 DeepSeek V3.2 和 GLM-5.3,在 2,000 token 上限下,300 秒覆盖了全部请求(最长分别为 242 秒和 229 秒)。这些是我们两天内观测到的最大值,请根据你自己的测量结果调整。
- 重试:遇到 HTTP 529、首 token 超时或空流时,做一次重试并配合短暂且有上限的退避,是平滑掉偶发繁忙时段的简单办法。DigitalOcean 发布了针对 HTTP 429 的重试与退避指南。我们没有找到专门针对 529 的指南,因此沿用同样的做法是合理的起点。
需要自有容量时,考虑专用推理。如果你的流量稳定且高,或者需要比上述 p99 更紧的延迟目标,专用推理可为你提供专属 GPU 容量,按 GPU 小时计费。撰写本文时,DigitalOcean 的模型页面列出 DeepSeek V3.2、Gemma 4 和 Llama 4 Maverick 可在专用推理上使用,GLM-5.3 则仅支持无服务器模式。我们在此没有对专用推理做基准测试。如需选择方面的帮助,请参阅我们的无服务器、专用与批处理推理对比教程。
用自己的实际负载跑一遍。你的提示词、回复长度和区域都跟我们的不一样。先创建一个模型访问密钥,然后用自己的模型和提示词跑上一两天。快速入门里介绍了如何发出第一个请求。我们完整跑满48小时,token费用约为14.66美元。
这些数字什么时候可信,什么时候不可信
不要拿这些数字做高并发场景的容量规划。我们每次只发一个请求。负载下的表现请参考我们的并发基准测试。也别把它们当成SLA。DigitalOcean的serverless inference按商业上合理的努力水平运行,不提供任何延迟保证。同样不要用它们来比较不同厂商,因为客户端、区域和提示词都不一样。
局限性
- 只覆盖一个客户端区域(blr1)。
- 只跑了48小时,涵盖两个日常周期,不含周末。时段差异只是这个窗口内的观察结果,并非普遍规律。
- 每次只发一个请求,提示词为单一任务类型的合成数据,输出上限设为2,000 token。这个上限截断了GLM-5.3 43%的回复。
- 各模型回复长度不同,会影响总耗时,也让短回复的每秒token数波动更大。
- 结果反映的是2026年10月28日至30日的模型版本,之后会发生变化。
常见问题
用大白话说,你们测了什么?
在48小时里,班加罗尔的一台小型服务器每10分钟向DigitalOcean Serverless Inference上的四个模型发一次请求,并记录响应时间。我们记录了首个token到达的耗时,以及之后token的流式输出速度。整个测试期间共发出3,456次请求,覆盖三种提示词长度。
p50、p95和p99是什么意思?
这些是百分位数。p50 代表典型请求:一半请求更快,一半更慢。p95 是 100 个请求中有 95 个都能达到的时间,也就是说最慢的 1/20 比它更差。p99 同理,对应最慢的 1/100。用户记住的往往是慢的那些,所以我们报告这些数据,而不只是平均值。
该选哪个模型?
取决于工作负载。对于短提示词和中长提示词的交互式聊天,Gemma 4 31B 和 Llama 4 Maverick 的 p99 TTFT 分别为 2.2 秒和 3.3 秒。对于长回答,GLM-5.3 的每秒 token 数最高(59.4)。DeepSeek V3.2 适合偶尔多等一会儿也能接受的任务。“这些结果怎么用”一节给出了每个模型的超时和重试设置。
GLM-5.3 要 26 秒才回答,为什么首个 token 这么快?
GLM-5.3 是推理模型。它先流式输出推理过程,首个 token 通常就是推理的一部分,所以大约 1 秒就能到达。回答要等推理结束才开始,中位数为 25 到 27 秒。有 32% 的请求在还没开始回答时就达到了我们 2,000 token 的上限。如果你基于推理模型构建应用,要测量首个回答 token 的时间;如果需要更快拿到答案,就降低推理强度。
你们早先审计中 DeepSeek V3.2 的首 token 长等待,这次又出现了吗?
出现了几次,但比例很低。857 个成功的 DeepSeek V3.2 请求中有两个超过 200 秒才发出首个 token(206.5 秒和 210.0 秒),大约 1/430。四个请求启动超过 30 秒,14 个请求总耗时超过 60 秒。设置 30 秒首 token 超时并重试一次,这些情况下额外等待大约 30 秒。
延迟会随时段变化吗?
典型请求不会。每个模型的中位 TTFT 在 6 小时时段之间的波动不超过 14%。DeepSeek V3.2 的 p95 和每秒 token 数在印度标准时间 06:00 到 18:00 的时段看起来不太理想,但只有两天数据,我们无法区分这是规律还是偶然。
请求返回错误的频率有多高?
99.74% 的请求成功。3,456 次请求中有 9 次(0.26%)返回错误,Gemma 4 则全部 864 次请求均成功完成。这 9 次错误中,8 次是 HTTP 529“平台过载”响应,1 次是内容为空的 200 响应,涉及 DeepSeek V3.2、GLM-5.3 和 Llama 4 Maverick。我们没有重试,因此这些均为首次尝试的结果。
超时时间该设多少?
以对应提示词规模的 p99 为起点,再留出余量。10 秒的首 token 超时足以覆盖我们测得的 Gemma 4、GLM-5.3 和 Llama 4 Maverick 的全部 p99,30 秒则能覆盖 DeepSeek V3.2。总时长超时方面,Gemma 4 和 Llama 4 Maverick 设为 120 秒,DeepSeek V3.2 和 GLM-5.3 在 2,000 token 上限下设为 300 秒。遇到 529 响应时短暂退避后重试一次,可平滑掉偶发的繁忙时刻。
我的应用延迟会比这些数字更低吗?
有可能。我们强制模型在每次请求时都读取完整提示词。如果你的应用发送的是稳定前缀(例如较长的系统提示词),DigitalOcean 会为 DO 托管的模型自动缓存该前缀,TTFT 应当更低。参见使用提示词缓存。
这些数字能和其他提供商比较吗?
不能直接比较。客户端位置、提示词、输出上限和计时方式都会影响结果。要比较不同提供商,请从同一客户端用同一脚本分别对每家运行。脚本和原始数据都在代码仓库中。
这是 SLA 吗?
不是。DigitalOcean 按商业上合理的努力提供无服务器推理服务,不发布延迟保证。以上仅为某一个 48 小时窗口内的观测结果。
复现
完整运行共消耗 12.93M 输入 token 和 2.05M 输出 token,按 DigitalOcean 公布的无服务器推理价格计算约为 $14.66(依据 CSV 中的 token 数计算,而非账单):GLM-5.3 $11.20,DeepSeek V3.2 $1.80,Llama 4 Maverick $0.93,Gemma 4 $0.73。GLM-5.3 约占总成本的四分之三,因为其推理 token 计入输出。
python3 collect.py --models "glm-5.3,deepseek-3.2,gemma-4-31B-it,llama-4-maverick" \
  --duration-hours 48 --interval 600 --max-tokens 2000 --client-region blr1 \
  --out data/latency.csv
python3 analyze.py data/latency.csv --tz Asia/Kolkata --outdir results