扩容实测:取模搬走91.5%的会话,哈希环只动8.7%
昨天在热榜上刷到一条标题,叫“I lost half a day to an n8n workflow that was 'working.' It never ran.”,作者花了半天排查一个 n8n 工作流,界面上的状态一直是绿的,日志里一次触发都没有。我看完笑了一下,然后有点心虚,因为我上个月也在一句类似的话上停了很久——“一致性哈希扩容只迁移 1/N 的数据”。这句话我信了很多年,讲课讲、评审讲,但从来没有在自己写的 2000 个会话 key 上真量过一次。
所以我把项目里那段分片逻辑抠出来,删掉依赖,写成一个能跑的对照实验。我要验证的不是“一致性哈希比取模好”这种没信息量的结论,而是两个具体数字:10 个节点扩到 11 个时,取模到底搬多少、一致性哈希到底搬多少;以及把虚拟节点数调小之后,负载会歪成什么样。
热榜那条“跑通了”的 workflow
那条帖子的细节很有意思:工作流在编辑器里能手动执行,节点连线也没报红,但定时触发器压根没生效,所以它“working”了半个月,实际一次都没跑过。作者说他一直看的是编辑器里的状态灯,没去看执行历史。这跟我见过的另一类错误几乎一模一样——很多人判断分片方案健不健康,只看“扩容时迁移了多少数据”这一个指标,因为它最直观、最好汇报,却不去看迁移完之后每个节点身上压了多少 key。
我不认同的正是这个默认前提:迁移量小就等于扩容平滑。教科书上那句“一致性哈希加一个节点只搬 1/(N+1)”是一个平均值结论,它说的是期望,不是最坏情况。而在真实实现里,最坏情况取决于虚拟节点有多少个——这个参数在很多项目里被随手设成 1,理由是“一致性哈希本来就均匀”。我想看看这个理由在 10 个节点、2000 个 key 的规模上到底站不站得住。
实验设计与代码
实验设置很朴素:2000 个会话 ID,10 个节点扩到 11 个,哈希函数用 FNV-1a,随机种子固定成 42 保证可复现。三种策略跑同样的 key 集合:直接取模、一致性哈希但每个物理节点只挂 1 个虚拟节点、一致性哈希每个物理节点挂 100 个虚拟节点。每种策略记录四个数:搬家的 key 数量、搬家占比、最热节点相对平均值的倍数、最冷节点持有多少 key。
import random, collections

def fnv(s):
    h = 2166136261
    for c in s.encode():
        h = ((h ^ c) * 16777619) & 0xFFFFFFFF
    return h

def ring_of(nodes, reps):
    r = [(fnv(n + "#" + str(i)), n) for n in nodes for i in range(reps)]
    r.sort()
    return r

def pick(r, key):
    h = fnv(key)
    if h > r[-1][0]:
        return r[0][1]
    lo, hi = 0, len(r) - 1
    while lo < hi:
        m = (lo + hi) // 2
        if r[m][0] < h:
            lo = m + 1
        else:
            hi = m
    return r[lo][1]

random.seed(42)
keys = ["sess-" + str(random.randrange(10  9)) for _ in range(2000)]
base = ["n" + str(i) for i in range(10)]
grow = base + ["n10"]
avg = len(keys) / 10.0

def build(nodes, reps):
    r = ring_of(nodes, reps)
    return {k: pick(r, k) for k in keys}

cases = [("modulo", {k: base[fnv(k) % 10] for k in keys},
                    {k: grow[fnv(k) % 11] for k in keys}),
         ("ring vnode=1", build(base, 1), build(grow, 1)),
         ("ring vnode=100", build(base, 100), build(grow, 100))]

print("keys=%d nodes 10 -> 11  hash=FNV-1a  seed=42" % len(keys))
print("%-14s %7s %8s %9s %5s" % ("strategy", "moved", "share", "max/avg", "min"))
print("-" * 47)
seen = {}
for name, a, b in cases:
    mv = sum(1 for k in keys if a[k] != b[k])
    cnt = collections.Counter(a.values())
    vals = [cnt.get("n%d" % i, 0) for i in range(10)]
    seen[name] = 100.0 * mv / len(keys)
    print("%-14s %7d %7.1f%% %8.2fx %5d"
          % (name, mv, seen[name], max(vals) / avg, min(vals)))
    if name == "ring vnode=1":
        lo, hi = min(vals), max(vals)

print("expansion churn: modulo %.1f%% vs ring-100 %.1f%%"
      % (seen["modulo"], seen["ring vnode=100"]))
print("ring vnode=1 load: coldest %d keys, hottest %d keys (avg 200)" % (lo, hi))
print("theory: one added node on a wide ring moves about 1/11 = 9.1%")
pick 函数做的是标准的一致性哈希查找:把 key 哈希到 32 位空间,在排好序的 vnode 数组里二分找第一个大于等于它的位置,找不到就回绕到环头 r[0]。这里我特意没用 Python 内置的 hash(),因为它对字符串带随机盐,同一次进程内稳定,跨进程不可复现,跑出来的数字没法贴给别人核对。FNV-1a 只有十几行,但确定性够用。
还有一个设计上的取舍:我固定哈希函数、固定种子、固定 key 集合,只让分片策略这一个变量变化。这样三种策略之间的差异完全来自算法本身,不来自随机波动。代价是这组数字只代表这一个样本,后面讲局限时我会回来说这件事。
跑出来的三行数字
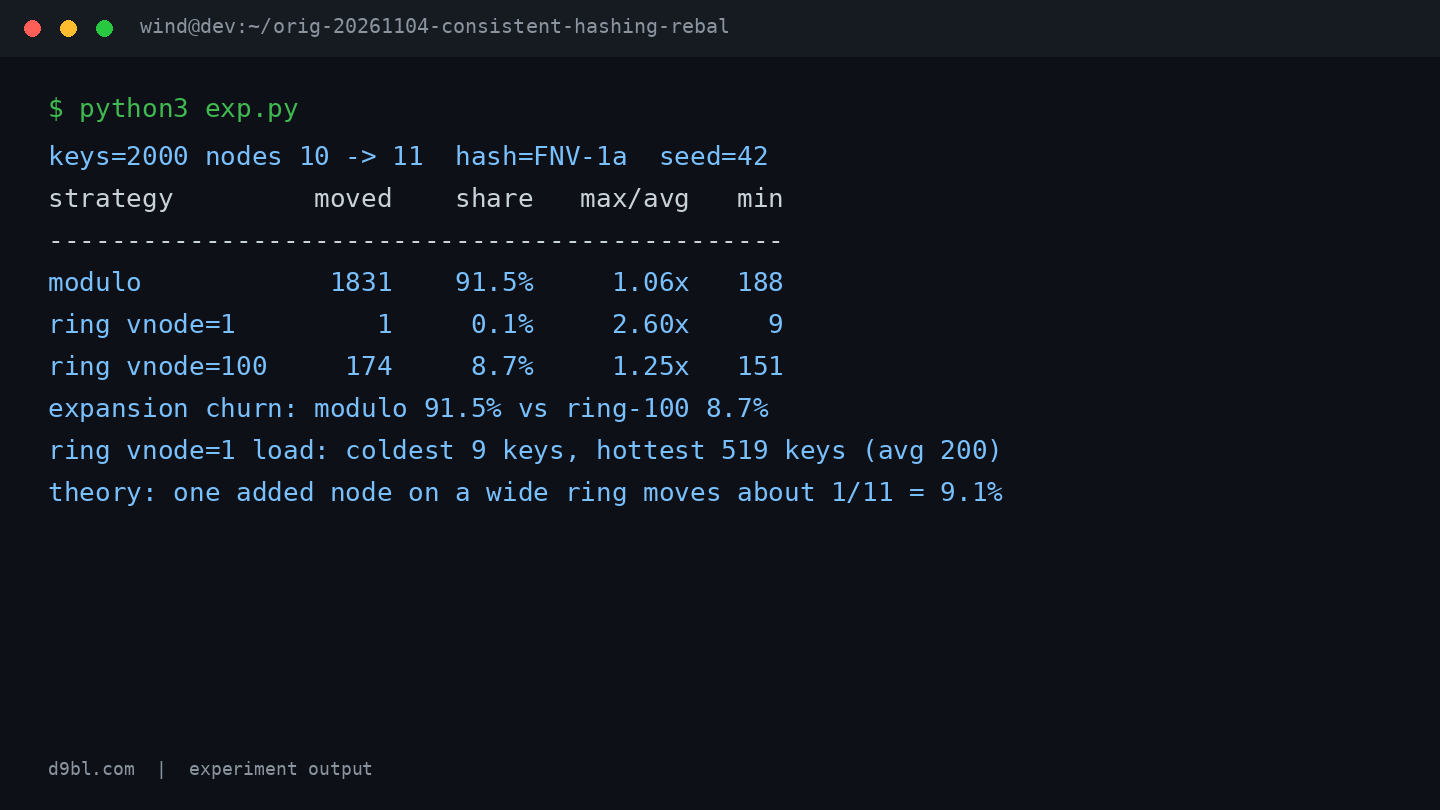
取模那一行最刺眼:10 个节点扩到 11 个,2000 个 key 里有 1831 个换了家,占比 91.5%。这跟理论完全对得上——取模的映射是 k mod N,N 一变,几乎每个 key 的余数都变。而 ring vnode=100 只搬了 174 个,占比 8.7%,和理论值 1/11 = 9.1% 只差 0.4 个百分点。差距来自于 vnode 在环上的落点是随机的,不是理想等分,所以实际迁移比例总会围绕 9.1% 抖一抖。
ring vnode=1 那一行更极端:只搬了 1 个 key,占比 0.1%。如果只看这一列,结论会是“虚拟节点越少扩容越平滑”,那显然荒谬。所以右边两列才是关键。取模的 max/avg 是 1.06x,最冷节点 188 个 key,离平均值 200 非常近,这是取模被低估的优点:只要哈希本身均匀,它几乎精确均分。ring-100 的 max/avg 是 1.25x,最冷 151。到 ring-1,max/avg 直接飙到 2.60x,最冷节点只有 9 个 key。
只搬 1 个 key 的那一行,是个陷阱
vnode=1 时“迁移量最小”是个纯粹的假象。11 个 vnode 把整个环切成 11 段,段长服从指数分布,长的能长到平均值的几倍,短的就一小截。结果是最热的那个节点拿走 519 个 key,是平均值 200 的 2.6 倍;最冷的节点只有 9 个,相差 57 倍。扩容那天晚上你确实不用搬数据,因为这套分片本来就没分好,只是之前没人看而已。这跟热榜那条 workflow 是同一类错误:状态灯是绿的,业务是坏的。
反过来说,ring-100 的表现也没有我预期的那么好。1.25x 的最热/平均比意味着最忙的节点要比别人多扛四分之一的流量,这个数字在生产里不算能接受的范围。我原本以为 100 个虚拟节点足够把负载压平,实测说明在这个规模下还差一档。
局限也得说清楚。2000 个 key 的样本不大,一个 key 的差异就是 0.05 个百分点,8.7% 和 9.1% 之间的那点差距说明不了太多。FNV-1a 只有 32 位,2000 个 key 里出现碰撞的概率不为零,只是这次没影响结论。我只测了“加一个节点”这一种变更,没测缩容、没测节点宕机、没测连续加三个节点的情况。虚拟节点也只取了 1 和 100 两档,中间那些值我没扫。真要上线,这些都得补。
还有一个我事先没料到的结果:取模的最冷节点是 188,比 ring-100 的 151 还高。我原本的预期是一致性哈希在均匀性上至少不会输给取模,实测它输了一档。原因也简单,取模的均匀性来自哈希函数本身,一致性哈希的均匀性来自 vnode 数量,100 个 vnode 划分 32 位空间还是太粗。
我的结论
如果 key 规模在百万级以下、节点变动不频繁,我会直接用取模加固定槽位:先划 1024 个逻辑槽,再把槽映射到物理节点,扩容时按槽搬,均匀性和迁移量都可控,实现还比哈希环简单。如果场景必须频繁加减节点、或者节点数本身会动态变化,那用一致性哈希没问题,但虚拟节点数别低于 100,我这次 100 个 vnode 也只有 1.25x,建议按 200 到 500 起步,上线前拿真实 key 分布跑一遍 max/avg 再定。
判断一个“平滑扩容”方案值不值得用,别只看迁移比例这一个数。迁移比例决定扩容那天晚上你要不要值班,最坏节点负载决定扩容之后一个月你要不要值班。这两个数一起看,才不会掉进“只搬了 1 个 key 所以很完美”这种坑里。