一个列表越跑越长:我花了两小时才怀疑到默认参数
事情发生在上个月的一个内部报表服务上。接口本身很简单:给每个来取数据的用户拼一个当次请求的结果列表,签名大概长这样 def collect(user, rows=[]),然后在函数里往 rows 里塞内容再返回。上线头两天没问题,第三天开始有运营同事反馈"导出的报表里怎么有别人的数据",我第一反应是权限校验漏了,把鉴权中间件从头翻了一遍,没找到任何漏洞。
更怪的是另一个现象:服务越跑越慢,重启之后就快,跑几个小时又慢下去。我当时的想当然判断是数据库连接池没释放,或者缓存键设计有问题,甚至去查了内存泄漏。这两件事——串数据、变慢——在我脑子里是两条独立线索,我从没想过它们是同一个原因。也正因为不敢凭感觉下结论,我决定把这套调用逻辑单独拎出来,写个能跑数的小实验,而不是继续靠翻代码猜。
我遇到的现场
先把那个函数的真实形态还原出来。它比示例代码多几行业务逻辑,但核心就是可变默认参数:def bad_push(user, bucket=[]),调用方大多只传 user 一个参数,bucket 走默认值。在写这段代码的人眼里,这个 [] 的意思是"每次调用都给我一个新的空列表"。
Python 的实际语义不是这样。默认参数在 def 语句执行的那一刻就被求值了,[] 只创建一次,之后所有不传第二个参数的调用,拿到的都是同一个列表对象的引用。函数里 append 修改的就是这个共享对象,于是它跨调用、跨请求、跨用户地累积下去。这解释了两件事:越长越慢是因为列表里堆的东西越来越多,串数据是因为后来者读到的是前面所有人的历史。
危险之处在于它不会报错。没有异常、没有堆栈、没有日志警告,返回值结构完全合法,只是内容是错的。这类 bug 排查成本远高于崩溃类问题,因为崩溃会告诉你行号,而它只会在业务层面表现为"数据偶尔不对",你还得先相信这是真的不对。
还原实验怎么设
我把实验压到最小:四个用户 alice / bob / carol / dave,随机抽 1000 次调用,random.seed(42) 保证可复现。同时准备两个版本,bad_push 用可变默认参数,good_push 用 None 哨兵,进函数后判空再建新列表。然后对每个版本跑同一份调用序列,统计五个量:与上一次调用是否复用同一个列表对象、列表最长长度、有多少次调用在列表里看到了别人的条目、累计读到多少条他人数据、累计总行数。
import random
random.seed(42)

# Pitfall: a list default argument is built once, at def time
def bad_push(user, bucket=[]):
    bucket.append(user)
    return bucket

# Fix: sentinel default, a fresh list per call
def good_push(user, bucket=None):
    if bucket is None:
        bucket = []
    bucket.append(user)
    return bucket

N = 1000
USERS = ["alice", "bob", "carol", "dave"]
calls = [random.choice(USERS) for _ in range(N)]

def run(fn):
    reuse = longest = dirty = foreign = rows = 0
    prev = None
    for u in calls:
        b = fn(u)
        if b is prev:
            reuse += 1
        prev = b
        longest = max(longest, len(b))
        rows += len(b)
        others = [v for v in b[:-1] if v != u]
        if others:
            dirty += 1
        foreign += len(others)
    return reuse, longest, dirty, foreign, rows

br, bl, bd, bf, bro = run(bad_push)
gr, gl, gd, gf, gro = run(good_push)

print("mutable default arg: %d calls, %d users" % (N, len(USERS)))
print("-" * 50)
print("buggy  calls reusing last list : %4d / %d" % (br, N))
print("buggy  longest bucket          : %4d  (want 1)" % bl)
print("buggy  calls seeing others     : %4d  (%.1f%%)" % (bd, 100.0 * bd / N))
print("buggy  foreign rows read       : %6d  (%.1f%% of rows)" % (bf, 100.0 * bf / bro))
print("fixed  calls reusing last list : %4d / %d" % (gr, N))
print("fixed  longest bucket          : %4d" % gl)
print("fixed  calls seeing others     : %4d  (%.1f%%)" % (gd, 100.0 * gd / N))
print("fixed  foreign rows read       : %6d" % gf)
print("fix cost: 2 lines + %d list allocs, 0 wrong rows" % N)
这里有个细节值得说:我特意用 is 而不是 == 判断复用,因为要抓的是对象身份,不是内容相等。两个空列表内容一样但不是同一个对象,用 == 会把真问题抹平。另外"看到别人"的判定是排除掉自己当前这条之后的剩余条目,这样既统计了次数也统计了规模,避免只看到"有没有"而忽略"有多严重"。
跑出来的数据
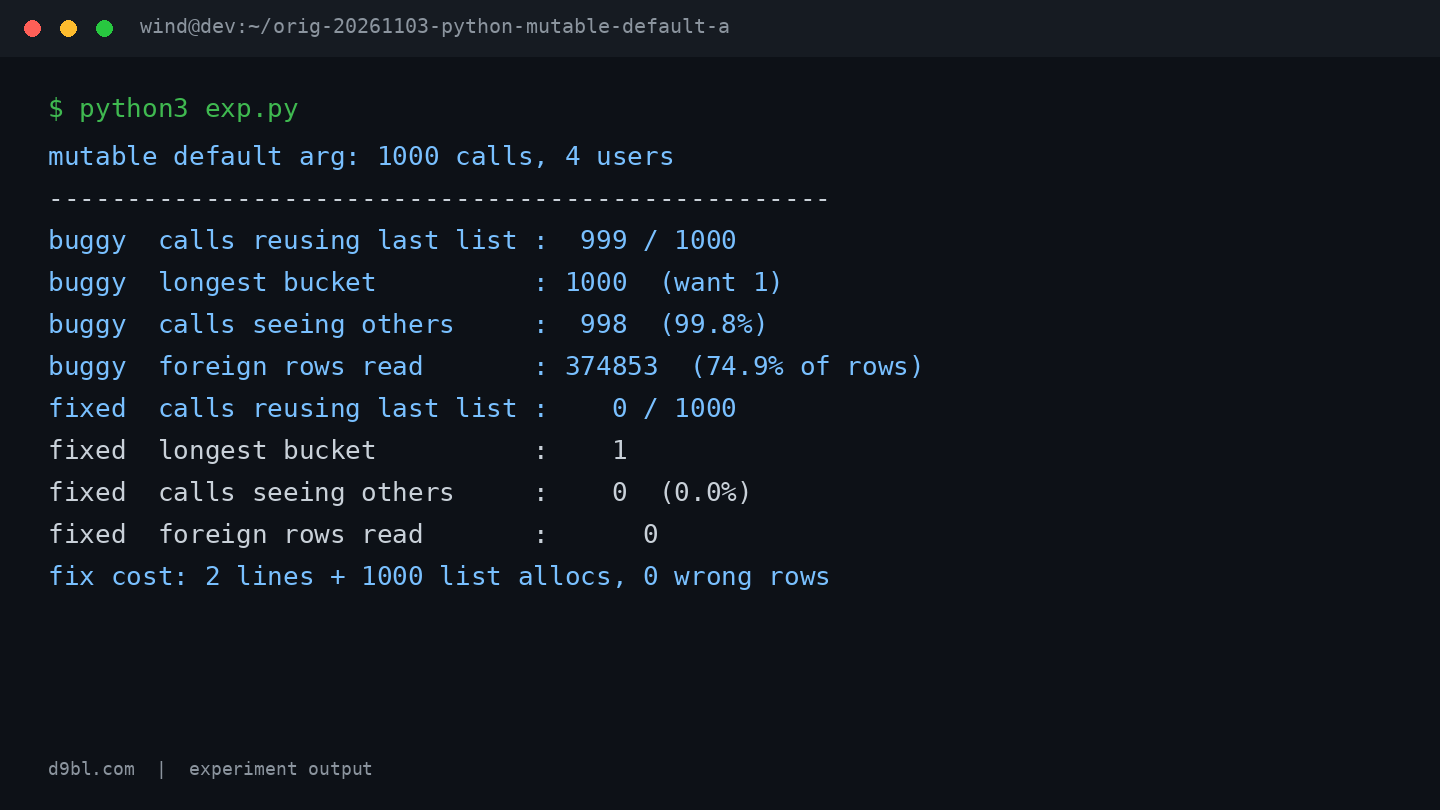
结果比我预期狠。bad_push 在 1000 次调用里 999 次复用了上一次的同一个列表——唯一没复用的那次是第一次调用,因为还没有"上一次"。列表最长长到 1000 个元素,理想值应该是 1,也就是每次调用只有自己这一条。这个 1000 就是全部调用次数,说明这个列表从第一次调用起就再没被放下过。
更直观的是串数据比例:998 次调用在返回结果里看到了别人的行,占 99.8%。累计读到他人数据 374853 条,占全部输出行的 74.9%——接近七成半的返回内容根本不是这次请求自己的。这意味着如果这是对外的报表接口,用户看到的大部分内容都属于别人,只有四分之一的输出是对的。
换成 None 哨兵之后,五个指标全部归零:复用 0 次、最长列表 1、看到他人 0 次、他人行 0 条。修复成本写得很清楚,两行改动加 1000 次列表分配,1000 次调用对应 1000 次新列表,一次不多一次不少。也就是说,这个 bug 的"性能优势"完全是错觉,它省下的那点分配开销,代价是把正确性整个换掉了。
我原来想错在哪
我最初的两个判断都错了。第一,我以为串数据是权限问题,实际上权限校验根本没执行到那个环节,数据在函数内部就已经混了。第二,我以为变慢是连接池或缓存问题,实际上慢的原因就是那个列表越来越长,后面每次调用都要处理前面九百多次留下的历史,复杂度是跟着调用次数线性涨的。两条线索合成一条,才说得通。
还有一个更隐蔽的错,是我写这段代码时的心理:bucket=[] 读起来太自然了,"默认给个空列表"符合几乎所有语言的直觉。但 Python 的默认值是定义期绑定,不是调用期绑定,这个语义跟直觉正好相反。反直觉的地方在于它不报错——如果它抛 TypeError,我五分钟就能定位;它偏偏返回一个格式正确、内容错误的结果,把排错方向引到别处去。
实验局限也说一下。我这里是单线程顺序调用,共享列表的累积是线性的、可预测的;真实服务是多线程多请求并发,情况会更乱——列表长度增长无序,还可能出现读到一半被追加的情况。另外我只测了四个用户、一种负载分布,换成高基数用户,他人行占比会变,但"复用同一个对象"这个根因不会变。这个实验能证明的是机制,不是精确的业务影响量级。
下次怎么绕开
具体可执行的只有一条:默认值永远不用可变对象,列表、字典、集合一律用 None 哨兵,进函数先判空再建。要多传一个参数就多传,别指望默认值帮你做初始化。这条规则没有例外场景,我目前没找到任何一个"这里用可变默认参数更合适"的真实案例。如果团队里有静态检查,把 B006 这类规则打开,让它在提交前就报,而不是等业务方来告诉你数据不对。
再往上一层,这个坑给我的教训不是"记住这个语法点",而是"默认值到底是什么时候求值的"值得对每个语言都确认一遍。JavaScript 的默认参数是调用期求值,Python 是定义期,Go 压根没有默认参数。同一个写法在不同语言里语义不同,凭手感迁移就是给自己埋雷。
留个开放的问题:如果这段代码在有类型标注、有 code review、有单测的项目里,它能不能活到线上?我的看法是,只要单测每次都新建对象、不检查调用间的对象身份,它就活得下来。要不要在测试里加一条"两次调用的返回值不是同一个对象"的断言,这取决于你觉得哪种成本更高。