23个人就能撞生日?我不信,跑了一万次模拟
今天刷 dev.to 热榜,一边是有人把 GitHub 主页改成了 Roguelike 地牢,一边是某篇文章声称“我给 AI 的上下文越多,它改得越差”。翻到概率相关话题时,我又看到了那个被讲烂的说法:一个房间里只要凑够
美国开源权重大模型全球现状情况的评估
Introduction 美国生产了全球最广泛使用的开放权重模型之一,涵盖超大规模厂商发布的 Meta 的 Llama 和 Google 的 Gemma,来自 NVIDIA 的硬件优化模型,微软 Phi 团队的小型但强大的模型,以及非营利组织 Allen Institute for AI 的完全透明
如何将 OpenAI API 迁移到 DigitalOcean 无服务器推理服务的完整步骤
DigitalOcean Serverless Inference 提供 OpenAI 兼容的 API 端点,因此许多现有的 OpenAI SDK 工作流只需少量配置更改即可迁移。对于基本的 Chat Completions 调用,您可以继续使用 OpenAI Python SDK,仅需修改基础 U
用提问引导 AI 修复:为何会陷入道歉死循环及如何提升初级开发者
我四十年带新人的经验似乎也适用于今天的 Agentic 编码。 "指导的真正目标从来不是提供答案,而是把手电筒照进状态空间的黑暗角落,让学生自己发现怪物。" — Randal L. Schwartz 1. 提示词泛滥:为什么“提示词技巧”正在让你失效今天在 YouTube、Twitter 或开发者博
我给排序的 key 加了计数器,调用次数差了 11 倍
今天早上刷 dev.to 热榜,看到一篇讲 Schwartzian Transform 的文章,评论区吵起来了:有人说 Python 的 sorted(key=...) 本质上就是这个变换,key 只算一次;也有人咬定“
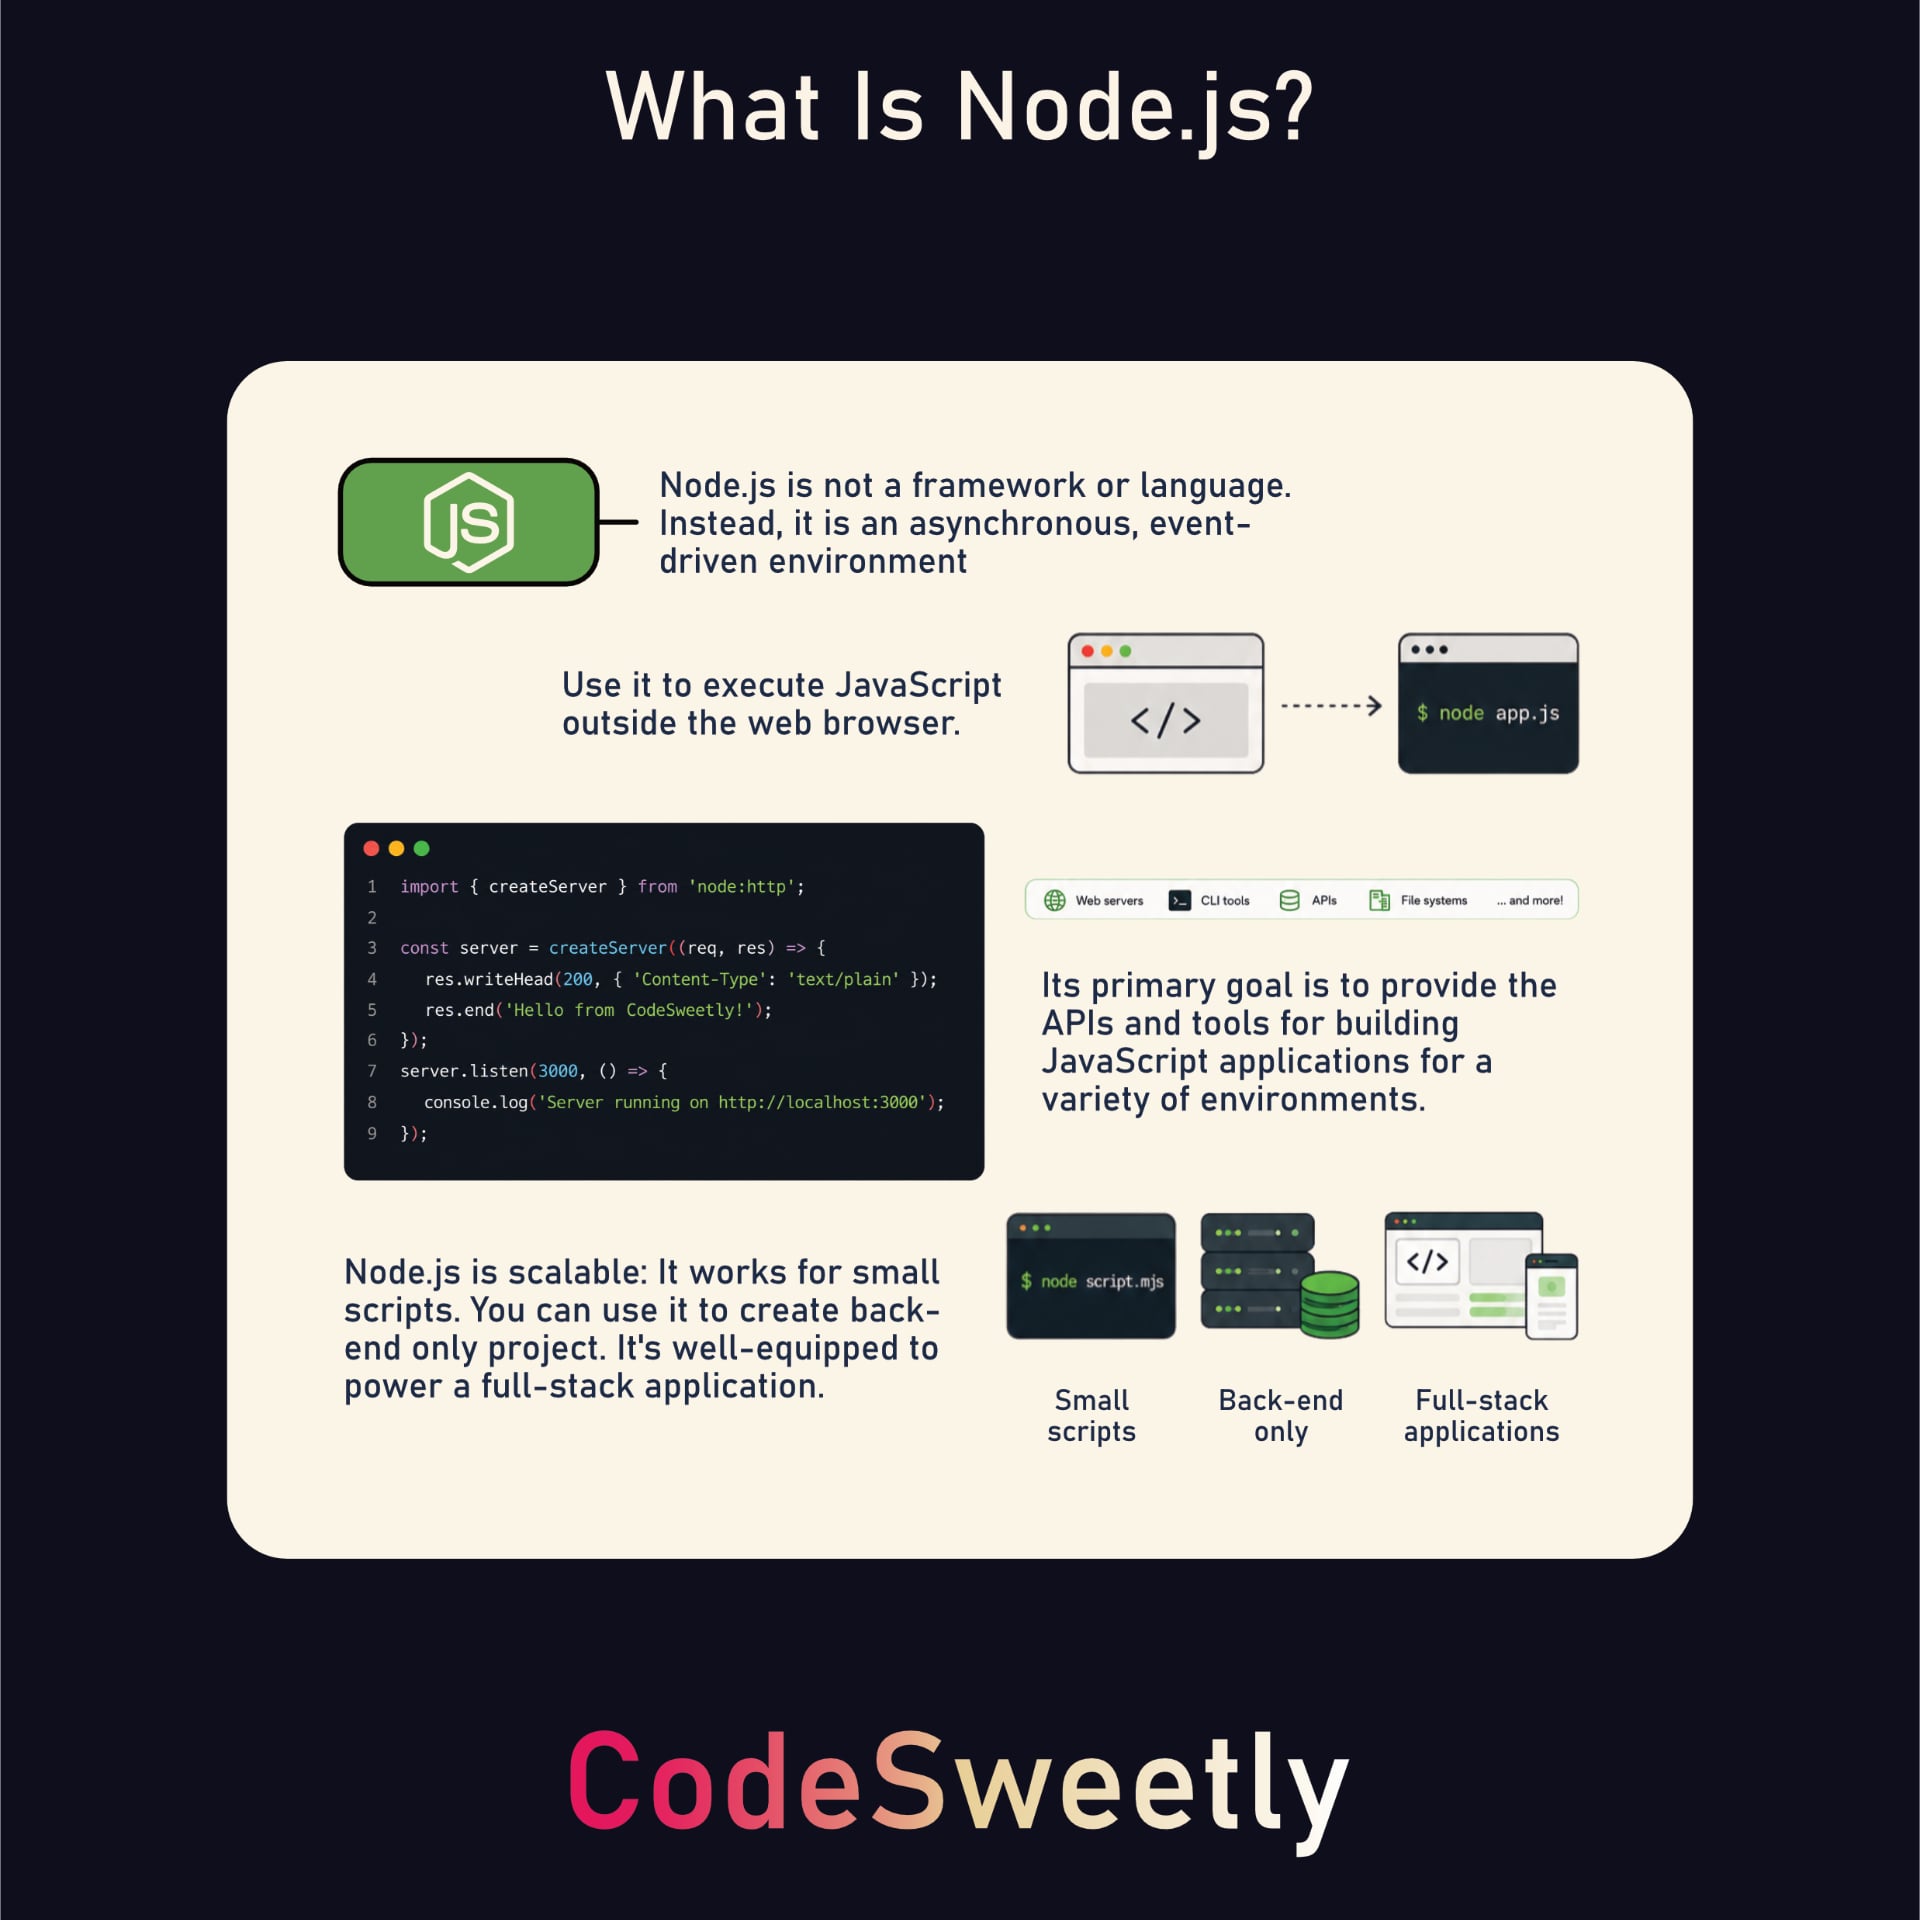
Node.js 和 Express.js 入门指南:服务器、路由、路由器和视图详解
Node.js 是一个能在浏览器之外运行 JavaScript 的运行时环境。无论是小脚本还是大型后端应用,Node.js 都提供了构建各类 JavaScript 应用所需的 API 和工具。 但学习 Node.js 可能让人望而生畏。API、包、工具和各种概念太多了,很容易迷失方向。 正因如此,本
实测15个大模型:发现攻击目标是真实公司后,多数选择沉默
这是一份提交给 Kaggle Benchmarking Challenge 我向15个AI模型提供了越来越多的证据,表明它们的“练习”黑客目标实际上是一家真实公司的系统。当证据收集完毕时,62%的回答如此表明,且没有一个模型登录。但当一个模型写下 "这是一个真实的生产系统" 时,它有 73% 的时间
基于 Next.js 与 Jev 构建智能 Bug 自动路由到 GitHub 的 AI 支持系统
每个网站都会收到反馈,但大部分反馈最终会被放到一些尴尬的地方。访客发现按钮坏了,给你发邮件。另有人在社交媒体上留言,说某个页面在手机上打不开。还有人在你的联系表单里填写功能建议,这条信息就这样夹在新闻通讯和收据之间,躺在你的收件箱里。 当你终于坐下来想要修复这些问题时,错误报告分散在三个不同的地方。
我实测两次选择负载均衡:多问一句,热桶从2个变0个
今天刷 dev.to 热榜,看到一篇讲 2025 年 6 月那次 Cloudflare 故障的文章,评论区顺着聊到了负载均衡。有个说法被顶得很高:负载均衡的时候,每个请求不要只随机挑一个节点,而是随机抽两个候选、把请求发
在DigitalOcean Serverless Inference上真实的首次令牌延迟是什么样子
如果你在构建语音代理或聊天机器人,用户评判它不仅仅看答案有多聪明,而是看他们在它开始回复之前需要等待多久。这种等待被称为首 token 延迟(time-to-first-token,简称 TTFT),即从发送请求到看到第一个词返回之间的间隔。 大多数在选择交互式应用模型的人其实从未实际测量过这一点。