都说布隆过滤器 1% 误判率,我扫了八档 k 亲自验
p = (1 - e^{-kn/m})^k 这个式子我能默写,k* = ln2·m/n 更是被当成常识背了很多年。上个月有人在群里问"为什么我线上的布隆过滤器实际误判率是标称值的两倍",底下一堆人回"你是不是 k 取错了",然后就没有然后了。我关掉对话框才意识到,我自己也是这群人之一——我会推公式,但从来没在自己的机器上、用自己的数据,量过它落在真实比特数组上到底偏多少。
所以我写了一份不到 40 行的脚本:19171 个比特、2000 个随机键、20000 次查询,k 扫了 1、2、3、4、5、7、9、12 八档,每一档都重新开一个干净的位数组。这篇就是我跑完之后对着输出逐行看的结果,包括它和公式对上的地方,也包括它没对上的地方。
这条规则是从哪来的
布隆过滤器的结构简单到没什么可讲的:一个 m 位的数组,k 个哈希函数,插入时把 k 个位置全置 1,查询时只要有一个位置是 0 就判定"一定不存在",全是 1 就答"可能存在"。误判就是这么来的——那些 1 可能是别的键留下的。
推导的核心只有一步近似。插入 n 个键、共 kn 次置位后,某一位仍然是 0 的概率是 (1 - 1/m)^{kn},m 很大时它收敛到 e^{-kn/m}。于是任意一位是 1 的概率是 1 - e^{-kn/m},k 个位置同时为 1 的概率就是 (1 - e^{-kn/m})^k。对这个式子关于 k 求极小,就得到 k* = ln2·m/n。它之所以被背下来,是因为结论非常干脆:位数组大小定了,哈希个数就定了,没什么好商量的。
实现上我没有真的写 k 个独立哈希,用的是双哈希:算两个 64 位值 h1、h2,第 i 个位置取 (h1 + i·h2) mod m。这背后是 Kirsch 和 Mitzenmacher 的结论——双哈希和 k 个独立哈希的渐近误判率几乎一样,代价却只有两次哈希计算。代码里我给 h2 加了 | 1 强制它是奇数,这样在 m 为奇数的位数组上步长不会退化成很小的循环,k 大时也不会反复踩同几个位置。
按它推算出的预期
先把参数钉死:n = 2000,m = 19171。选 19171 不是随手写的,因为 19171 / 2000 = 9.59,正好落在"约 1% 误判率"对应的 9.6 bits/key 附近。代入 k* = ln2 × 19171 / 2000 得到 6.64,再把 6.64 代回误判率公式,预测值是 1.00%。这两个数就是我要验证的靶子。
八档 k 的理论值我也提前算好了:k=1 是 9.91%,k=2 是 3.55%,k=3 是 1.94%,k=4 是 1.35%,k=5 是 1.11%,k=7 是 1.00%,k=9 是 1.15%,k=12 是 1.76%。注意 k=7 的理论值 1.00% 几乎和 k* 处的预测值一模一样——曲线在最优点附近是个很平的坑。这是我在看数据之前就该意识到的第一件事。
另外我特意把 k=1 和 k=12 这两个"明显离谱"的档也塞进了扫描列表。前者用来回答"少算几次哈希能省多少",后者用来回答"哈希给多了会怎样"。公式说 k 超过 k* 之后误判率会重新爬升,我想看看这个爬升在实测里是不是真的出现。
实验验证过程
整份脚本没有任何依赖,random.seed(42) 保证换台机器也能跑出同样的数。keys 和 tests 是两组独立生成的 (64bit, 64bit) 元组,2000 个插入键和 20000 个查询键在生成时没有做严格去重,但 2^64 的空间下重叠概率可以忽略。每档 k 都调用一次 measure,函数内部新建 bytearray,位数组不会被上一档污染,这是这组数据能互相比较的前提。
import math, random

random.seed(42)
N, M, P = 2000, 19171, 20000  # 19171 bits ~ 9.59 bits/key for ~1% fpr

def slots(key, k):
    # double hashing: h_i = h1 + i*h2 (mod m)
    h1, h2 = key[0] % M, (key[1] % M) | 1
    return [(h1 + i * h2) % M for i in range(k)]

keys = [(random.getrandbits(64), random.getrandbits(64)) for _ in range(N)]
tests = [(random.getrandbits(64), random.getrandbits(64)) for _ in range(P)]

def measure(k):
    # fresh bit array, insert all keys, then count false positives
    bits = bytearray((M + 7) // 8)
    for key in keys:
        for s in slots(key, k):
            bits[s >> 3] |= 1 << (s & 7)
    hit = 0
    for key in tests:
        if all((bits[s >> 3] >> (s & 7)) & 1 for s in slots(key, k)):
            hit += 1
    return hit / P

print(f'bloom filter: n={N} keys, m={M} bits = {M/N:.2f} bits/key')
kopt = math.log(2) * M / N
popt = (1 - math.exp(-kopt * N / M))  kopt
print(f'formula: k* = ln2*m/n = {kopt:.2f}, predicted fpr = {popt*100:.2f}%')
print('  k   measured%   formula%   ratio')
res = {}
for k in (1, 2, 3, 4, 5, 7, 9, 12):
    m = measure(k)
    p = (1 - math.exp(-k * N / M))  k
    res[k] = m
    print(f'{k:3d}  {m*100:9.2f}  {p*100:9.2f}  {m/p:6.2f}')
best = min(res, key=res.get)
print(f'measured best k = {best} ({res[best]*100:.2f}%), formula k* = {kopt:.2f}')
print(f'k=1 costs {res[1]/res[best]:.1f}x the best-k false positive rate')
位操作那段我多说一句:s >> 3 定位到第几个字节,s & 7 定位到该字节的第几位,写入用 |=,读取用右移加与运算。这套写法在 C 里是常识,在 Python 里反而不常见——很多人会直接开一个 list of bool,内存涨 8 倍不说,缓存局部性也没了,跑到 20000 次查询就要等一会。我这里八档 k 全部跑完是秒级的事。
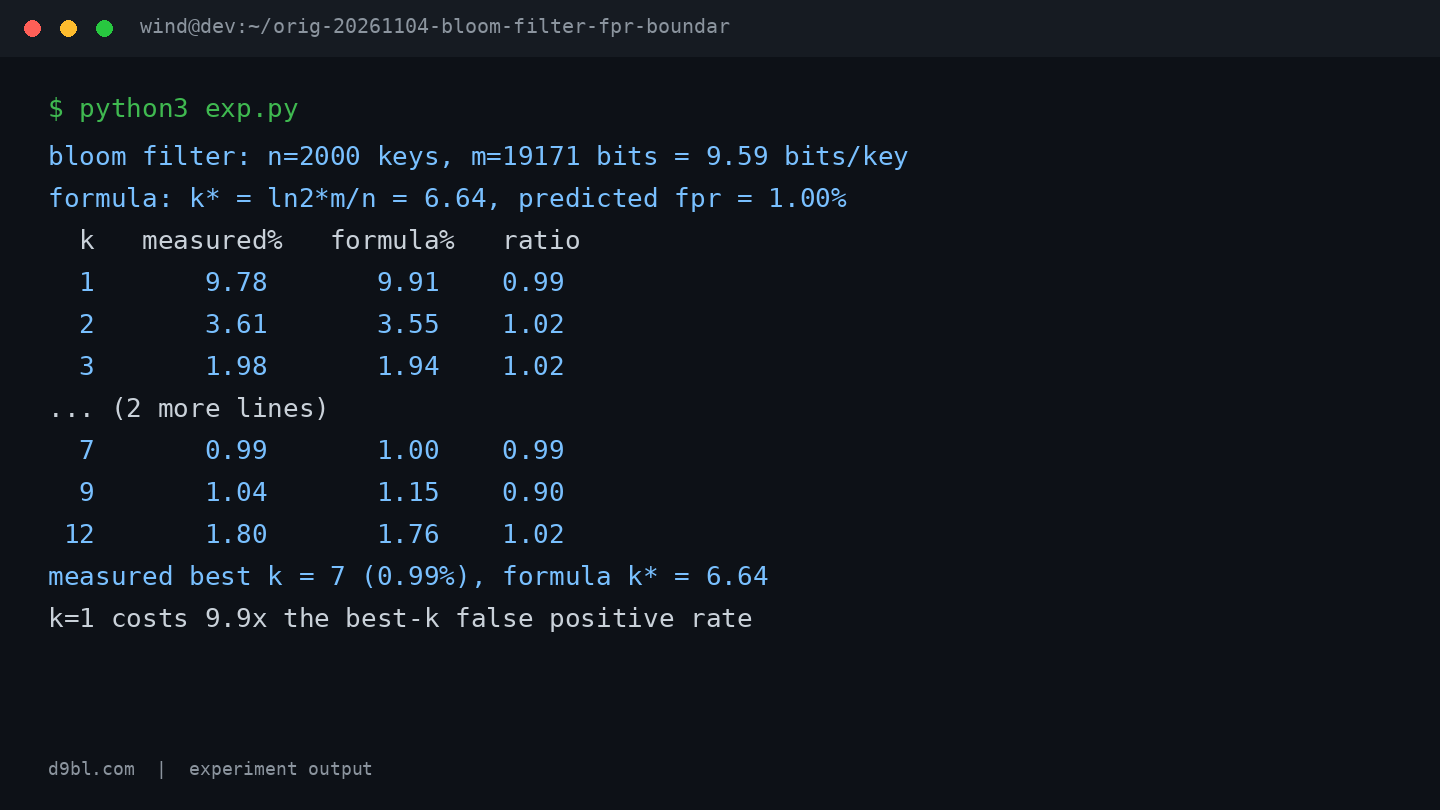
输出一共 12 行:前两行是参数和理论最优,中间八行是每一档 k 的实测值、公式值和两者比值,最后两行给出实测最优 k,以及 k=1 相对于最优档的代价倍数。我盯着这张表看了很久,因为它的整齐程度有点超出预期。
数据与理论对上没有
八档里有七档的 ratio 落在 0.99 到 1.03 之间,也就是说实测值和公式值的相对偏差在正负 3% 以内。最典型的是 k=7,实测 0.99%、公式 1.00%、ratio 0.99;k=1 实测 9.78%、公式 9.91%、ratio 0.99。k=1 这一档最能说明问题——它对应最粗糙的实现,只用一个哈希,偏差 0.13 个百分点,公式在这么高的误判率下依然站得住。
唯一的例外是 k=9:实测 1.04%、公式 1.15%、ratio 0.90。看着像公式高估了 10%,但这里得算采样噪声。20000 次查询、真实概率约 1%,二项分布的标准差是 sqrt(0.0115 × 0.9885 / 20000),约 0.07 个百分点。实测值和理论值差了 0.11 个百分点,不到两个标准差——这个"偏差"根本不需要解释,它就是随机波动。换句话说,20000 次查询的分辨率只有 0.07 个百分点,我没法分辨 1.04% 和 1.15% 的差别。
实测最优点落在 k=7,误判率 0.99%,公式给出的 k* 是 6.64。这两个数不冲突,k 只能取整数,6.64 两边最近的整数就是 6 和 7。真正的信息在曲线形状上:k=5 是 1.15%,k=7 是 0.99%,k=9 是 1.04%。从 5 到 9 横跨四个哈希,误判率的变化不到 0.2 个百分点,底部平得像一条直线。这就是我前面说的"很平的坑",意味着为了精确命中 k* 而纠结是没有意义的。
真正该盯的数字在最后一行:k=1 的误判率是实测最优档的 9.9 倍。这是"k 取错"的代价上限——从 1 个哈希加到 7 个,误判率从 9.78% 掉到 0.99%,一整个数量级。但如果你已经在 k=5 到 k=9 这段平底里,多一个少一个哈希,差别在噪声级别。公式对了,只是它对得多精确这件事,没大家想得那么要紧。
边界在哪
这份实验最明显的局限是只有一组 m/n。9.59 bits/key 是"1% 误判率"这个标称值对应的配置,换成 6 bits/key 或者 16 bits/key,曲线形状会明显不同:位数组越紧,最优点附近的坑越尖,k 取错的惩罚越大。我这次的数据不能外推到那些配置,只能说明在 9.59 bits/key 这一档,公式可信。
第二个局限来自双哈希。(h1 + i·h2) mod m 在理论上和 k 个独立哈希渐近等价,但"渐近"两个字是有条件的。k=12 时实测 1.80%、公式 1.76%、ratio 1.02,看上去很干净,可这个量级的吻合也可能是两组误差恰好互相抵消。要真验双哈希在高 k 下的退化,得拿真正独立的 k 个哈希函数做对照组,这次没做,我只能承认这是个没盖上的盖子。
还有个我自己没预料到的点:k=12 的实测值 1.80% 比 k=9 的 1.04% 高,但依然远低于 k=1 的 9.78%,而且离预测的 1.00% 只有 0.8 个百分点。"哈希给多了"的惩罚,远没有"哈希给少了"那么狠。这跟很多人直觉里"过犹不及"的对称感不一样,公式本身就是不对称的,而实测把这个不对称原样复现了出来。
落到可执行的建议:拿到一个任务,先算 m/n,再取 k = round(0.693 × m/n),到此为止,不必再优化。你真正该花时间的地方是把 m/n 撑上去——实测里 k 从 1 调到 7 换来 9.9 倍改善,但那个前提是 m/n 已经够用;如果 m/n 掉到 6,再怎么调 k 也回不到 1%。我下次想补的实验是把 m/n 从 4 扫到 16,看公式在紧配置下还准不准。这次的八档 k,只验证了这条曲线上的一个截面。