同一批键塞进 1024 槽:查空 25.7 次对 1.9 次
上周评审,有人坚持哈希表就该用链地址法,理由是线性探测在 0.9 负载下会退化成链表;另一位当场反驳,说链地址法每个节点一次指针跳转,缓存全部打穿,真正扛量的实现都该往开放寻址走。两个人说的都对,也都不能直接拿来当决策依据——他们的负载不同、读写比例不同、语言的内存布局也不同。我翻了一圈网上的文章,大半在复述教科书公式,小半拿某种语言的标准库做黑盒 benchmark,连"探测次数"这个最基础的指标都没有对齐口径。
再吵下去没有意义。我写了六十行 Python,用同一批键、同一个槽位数、同一个随机种子,把两种做法在四个负载点上并排跑了一遍,输出就贴在下面。我要的不是"哪个更好"这种没法落地的结论,而是代价曲线在哪个负载点开始分叉,分叉之后有多陡。
两个做法的分歧点
线性探测把所有键塞进一个数组,冲突就往后挪一格,挪到空位为止;链地址法维持 M 个桶,每个桶挂一条链,冲突就往链上追加。书本上讲的区别很干净,落到工程里其实就三条:内存是不是连续、删除好不好做、代价对负载有多敏感。
真正吵起来的是第三条。线性探测的失败查找要多走一整个"簇",而簇长对负载是超线性的,负载从 0.75 抬到 0.90,簇长能翻好几倍;链地址法这边,失败查找的代价几乎就是 1 加上平均链长,随负载线性地爬。可反过来,链地址法每跳一个桶、每走一个节点都是指针追逐,理论上缓存不友好,而线性探测访问的是一段连续内存。于是就有了"高负载线性探测必死"和"链地址法缓存全打穿"两种说法,双方都没在对方的场景下跑过数据。
我关心的具体问题很窄:在 1024 个槽、键全唯一、读多写少这种最常见的形态下,两种做法的差距到底从哪个负载开始变得不能忽略——是 0.50,还是 0.75,还是只有 0.90 才有区别。
对比实验怎么设
固定 seed 42,槽位 M 取 1024,从 0 到 100 万里随机抽 1024 个互不相同的键当键集;再抽 2000 个落在 200 万到 300 万之间的键,这批键保证不在表里,专门用来测查空。四个负载点取 0.25、0.50、0.75、0.90,都是拿键集前缀去建表,这样同一个键在四个负载下的哈希起点完全一致,比较是干净的。
import random

random.seed(42)
M = 1024
KEYS = random.sample(range(1000000), M)
MISS = random.sample(range(2000000, 3000000), 2000)

def build_linear(keys, m):
    t = [None] * m
    tot = 0
    for k in keys:
        i, p = k % m, 1
        while t[i] is not None:
            i = (i + 1) % m
            p += 1
        t[i] = k
        tot += p
    return t, tot / len(keys)

def probe_linear(t, k, m):
    i, p = k % m, 1
    while t[i] is not None:
        if t[i] == k:
            return p
        i = (i + 1) % m
        p += 1
    return p

def build_chain(keys, m):
    t = [[] for _ in range(m)]
    tot = 0
    for k in keys:
        b = t[k % m]
        tot += len(b)
        b.append(k)
    return t, tot / len(keys)

def probe_chain(t, k, m):
    b = t[k % m]
    for i, v in enumerate(b):
        if v == k:
            return i + 1
    return len(b) + 1
三个指标:ins 是插入一个新键平均探测几次,hit 是查一个存在的键平均几次,miss 是查一个不存在的键平均几次。探测次数的定义统一成"访问了几个槽位",第一个槽就算 1 次,这样两种做法才能放进同一张表里比。链地址法的桶用 Python 的 list,插入时累加插入前桶里已有的长度,代表"确认这个键不在桶里"需要做的比较。
print("open addressing (linear probe) vs separate chaining, seed 42")
print("load  strategy       ins    hit     miss")
rows = []
for a in (0.25, 0.50, 0.75, 0.90):
    n = int(M * a)
    ks = KEYS[:n]
    tl, il = build_linear(ks, M)
    tc, ic = build_chain(ks, M)
    hl = sum(probe_linear(tl, k, M) for k in ks) / n
    hc = sum(probe_chain(tc, k, M) for k in ks) / n
    ml = sum(probe_linear(tl, k, M) for k in MISS) / len(MISS)
    mc = sum(probe_chain(tc, k, M) for k in MISS) / len(MISS)
    print(f"{a:4.2f}  {'linear':10s}{il:6.2f} {hl:6.2f} {ml:8.2f}")
    print(f"{a:4.2f}  {'chaining':10s}{ic:6.2f} {hc:6.2f} {mc:8.2f}")
    rows.append((a, il, ic, ml, mc))
a, il, ic, ml, mc = rows[-1]
print(f"load {a:.2f}: miss lookup {ml:.1f} vs {mc:.1f} probes -> {ml/mc:.0f}x")
print(f"          insert cost {il:.1f} vs {ic:.1f} probes -> {il/ic:.0f}x")
代码没有任何优化,没上 array,也没用 __slots__ 之类的技巧。我要比的是两种结构的探测行为,不是 Python 解释器的开销——这一点后面会变成一个很明显的局限。
数据摆出来
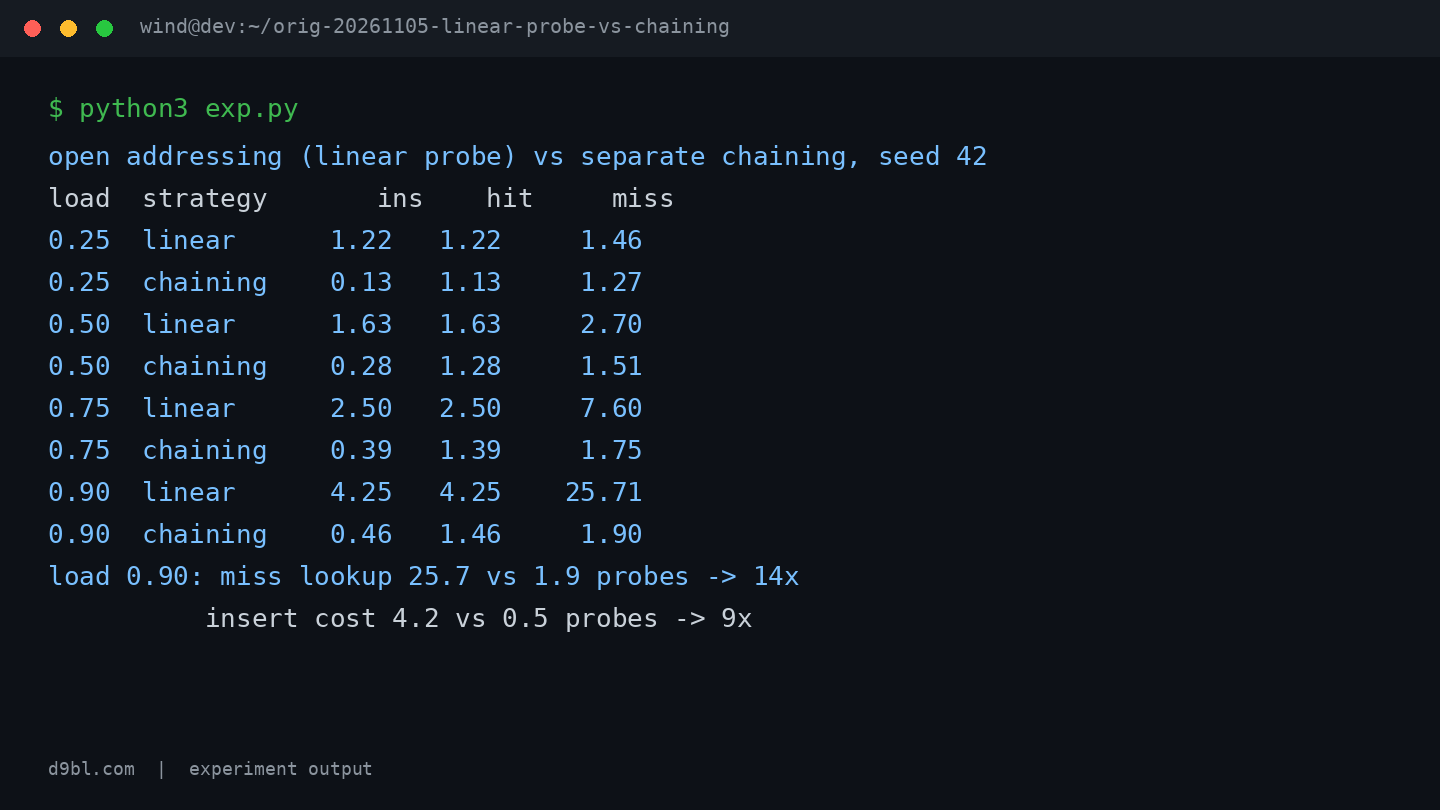
先看查空这一列。0.25 负载时线性探测 1.46 次、链地址 1.27 次,差 0.19 次,基本可以当噪声;0.50 是 2.70 对 1.51;0.75 是 7.60 对 1.75;到 0.90 变成 25.71 对 1.90,脚本自己算出来的倍数是 14 倍。插入代价在 0.90 负载下是 4.25 对 0.46,9 倍。
链地址法那一列几乎是教科书公式的复读机:查空次数约等于 1 加平均链长,0.90 负载下平均链长就是 0.9,实测 1.90,一位不差;0.50 负载下 1.51,1 加 0.5 等于 1.5,也对得上。它没有惊喜,但也没有惊吓,从 0.25 到 0.90 只从 1.27 爬到 1.90。线性探测这边完全不是一个形状:0.25 到 0.50 只从 1.46 爬到 2.70,看着还行;0.50 到 0.75 翻到 7.60;0.75 到 0.90 直接跳到 25.71——同样是加 0.15 的负载,后一段涨了三倍多。
还有个我没预料到的细节:线性探测的 hit 和 ins 四行数字一模一样,1.22、1.63、2.50、4.25。不是巧合。键唯一的时候,插入要找的位置和查找命中的结束位置走的是同一条路径,探测次数当然相同。链地址法的 hit 也在 1.13 到 1.46 之间缓慢地爬,每次命中平均要走半条链,负载越高链越长。
结论之外还要看什么
先说我这个口径里最容易被挑刺的一处:链地址法的 ins 记的是"插入前桶里已有多少个元素",0.90 负载下平均 0.46,正好是 0.9 的一半。如果允许重复键、直接往链头一挂了事,这个成本应该是 0;我这么记是因为真实实现里往往要先扫一遍链确认没有重复。换句话说,链地址法的插入 0.46 次是个偏保守的数字,而线性探测的 4.25 次是实打实的内存访问。这个口径差异让链地址法看起来更占便宜,引用这组数的时候心里得有数。
更要命的是缓存。链地址法在 C 里吃亏就吃亏在指针追逐上,一次查空可能跨好几个 cache line;可我这里用的是 Python,list 里存的是对象引用,两种结构都在做指针追逐,解释器的开销把真正想测的访存差异全埋了。所以这份数据能说明探测次数,说明不了墙钟时间,拿它去论证"C 里到底该用哪个"是越界的。
还有几件事我根本没测。删除。线性探测的删除要打墓碑标记,墓碑会持续污染探测路径,0.90 负载下频繁删除的表会比这张表还难看,而链地址法删一个节点只是链表断开,代价几乎不变。0.90 也不是终点,0.99 的线性探测在我的经验里已经不是"慢"的问题,是跑不跑得完的问题。最后,我用 k % M 直接哈希,1024 个键的分布理想得不像真的,真实键集一旦有聚集,线性探测的簇会连成片,链地址法几乎不受影响。
我会选哪个
看负载。如果负载能稳定压在 0.6 以下、删除很少,我倾向线性探测:0.50 负载下查空 2.70 次、插入 1.63 次,比链地址法的 1.51 和 0.28 多不了太多,还省掉了每条链的头指针和节点分配,内存是连续的,这个优势在 C 或者 Rust 里会被放大。但只要负载有可能爬到 0.75 以上,线性探测的曲线就开始咬人——0.90 时查空 25.71 次对 1.90 次,14 倍,这已经不是常数因子级别的差距了。
落到可执行的动作上只有两条。用线性探测,就把扩容阈值压在 0.7 附近,而且阈值判断要把墓碑计数算进去,别只数元素个数,否则表看起来半空、探测路径已经被墓碑铺满。用链地址法,初始桶数就开大一点,它 0.13 到 0.46 的插入代价说明桶多贵得有限,省那几个桶,不如省下探测。
至于"到底哪个更快",我建议你先量一下自己的实际负载再回来看这张表,这个数字比任何一篇对比文章的结论都管用。我自己还留了一个没答的问题:如果把 M 从 1024 抬到一百万、负载压到 0.10,两种做法的查空都掉到 1.1 次附近,那时候决定胜负的只剩内存占用和 cache line 命中率,而这两样恰好是我的 Python 实验测不出来的部分。谁要用 C 把这组补齐,我很想看结果。